
遇见数据集

arena-manifest

收藏
Hugging Face2026-05-29 更新2026-05-30 收录
官方服务:

资源简介:

arena-manifest 是一个单文件清单数据集,专为 SpeechAntiSpoofingBenchmarks Arena 和 speech-spoof-bench pip 包设计。它用于定义语音反欺骗基准测试中的层级结构、核心与扩展数据集集合,并固定数据集提交哈希以确保可复现性。数据集包含以下字段:ranking_version(字符串,指示排名规则版本)、schema_version(整数,当前为1,表示清单结构版本)、metrics_in_use(指标ID列表,控制竞技场显示顺序)、tiers(有序列表,从高到低,每个层级包含名称和最小覆盖范围),以及 core_set 和 extended(分别包含核心和扩展数据集的ID与git提交哈希)。该清单作为元数据标准,支持语音反欺骗研究的数据管理和基准测试。

arena-manifest is a single-file manifest dataset designed for SpeechAntiSpoofingBenchmarks Arena and the speech-spoof-bench pip package. It is used to define the tier structure, core and extended dataset collections in speech anti-spoofing benchmarks, and fixes dataset commit hashes for reproducibility. The dataset includes the following fields: ranking_version (string, indicating the ranking rule version), schema_version (integer, currently 1, representing the manifest structure version), metrics_in_use (list of metric IDs, controlling arena display order), tiers (ordered list from high to low, each containing a name and minimum coverage), and core_set and extended (containing IDs and git commit hashes for core and extended datasets, respectively). This manifest serves as a metadata standard to support data management and benchmarking in speech anti-spoofing research.

创建时间:
2026-05-21
原始信息汇总

数据集概述:arena-manifest

  • 许可证:MIT
  • 标签:arena-manifest

功能与用途

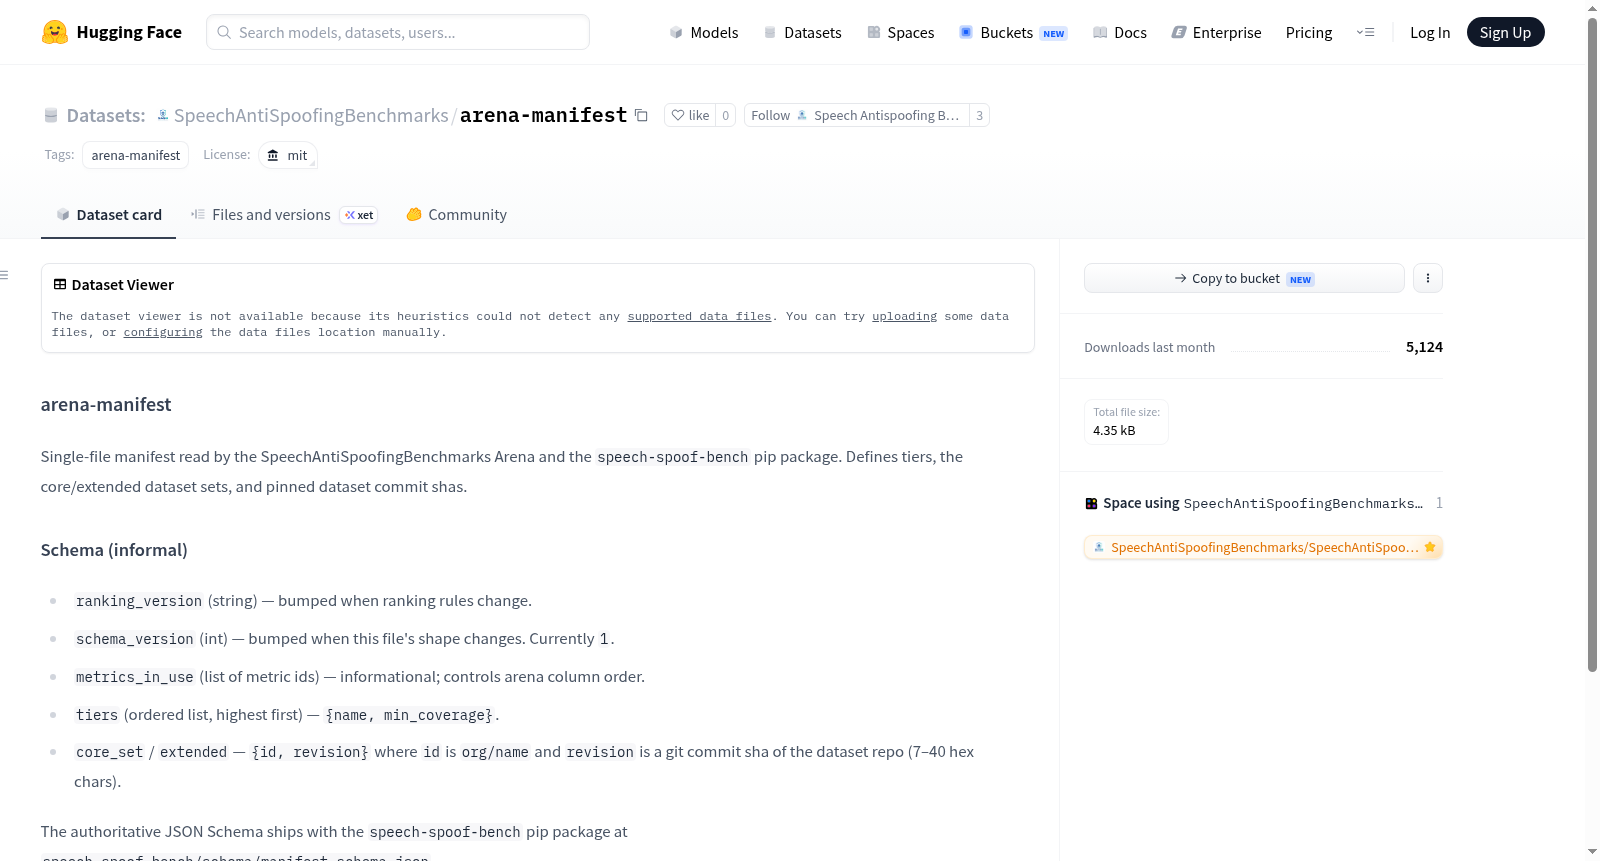
  • 该清单文件供 SpeechAntiSpoofingBenchmarks Arenaspeech-spoof-bench pip 包读取。
  • 定义了分级(tiers)、核心/扩展数据集集合(core/extended dataset sets)以及固定的数据集提交哈希(commit shas)。

数据结构(非正式描述)

  • ranking_version(字符串):当排名规则变更时递增。
  • schema_version(整数):当此文件的结构发生变化时递增,当前为 1
  • metrics_in_use(指标ID列表):信息性字段,控制 Arena 列的顺序。
  • tiers(有序列表,最高优先在前):包含 {name, min_coverage}
  • core_set / extended:包含 {id, revision},其中 idorg/name 格式,revision 为数据集仓库的 git 提交哈希(7-40个十六进制字符)。

补充说明

  • 权威的 JSON Schema 随 speech-spoof-bench pip 包一起提供,路径为 speech_spoof_bench/schema/manifest.schema.json
  • 详细信息可参考项目计划文档(https://github.com/lab260ru/speech_spoof_bench/blob/main/docs/roadmap/PLAN.md)§4。
搜集汇总
数据集介绍
arena-manifest 数据集图片
构建方式
在语音反欺骗基准测试领域,标准化评测体系的构建对于模型性能的公平比较至关重要。arena-manifest数据集以单一文件清单的形式呈现,通过定义明确的层级结构(tiers)、核心数据集(core_set)与扩展数据集(extended)的集合,以及各数据仓库的固定提交哈希值(revision),为SpeechAntiSpoofingBenchmarks Arena和speech-spoof-bench包提供统一读取规范。其构建方式遵循版本化管理原则,ranking_version在排名规则变更时更新,schema_version则随文件结构变化递增,当前版本为1。同时,metrics_in_use字段以列表形式记录使用中的评估指标标识符,控制竞技场中指标列的排序。
特点
该数据集的核心特点在于其轻量级与高规范性。作为单一文件清单,它无需加载大规模原始数据即可完整描述评测体系,极大降低了存储与传输开销。通过分层级的tiers定义(按优先级降序排列),每个层级包含name与min_coverage字段,确保了不同覆盖要求的评测场景均可灵活适配。核心数据集与扩展数据集的明确划分,使研究者可根据任务复杂度自由选择。此外,每个数据集条目均包含唯一的id(格式为org/name)和对应的仓库提交哈希值,从而实现了版本锁定,杜绝了因数据更新导致的评测结果不可复现问题。
使用方法
在实际应用中,arena-manifest文件被SpeechAntiSpoofingBenchmarks Arena后台和speech-spoof-bench Python包自动读取。用户无需手动解析该清单,只需通过标准的pip安装方式获取speech-spoof-bench包,该包内嵌了权威的JSON Schema定义文件(位于speech_spoof_bench/schema/manifest.schema.json),即可自动验证清单结构的正确性。在调用评测流程时,框架会根据清单中各tiers的优先级和core_set/extended的设定,自动拉取对应版本的数据集,并按照metrics_in_use指定的顺序展示评估结果。如需扩展或修改评测体系,只需编辑该manifest文件中的相关字段,系统即可动态识别变更并重新构建评测环境。
背景与挑战
背景概述
随着语音合成与转换技术的飞速发展,语音欺骗攻击对自动说话人验证系统的安全性构成了严峻威胁。为应对这一挑战,SpeechAntiSpoofingBenchmarks Arena 项目应运而生,其中 arena-manifest 作为核心清单文件,由 Lab260RU 研究团队于近年间开发,旨在规范与统一语音反欺骗基准测试的评估流程。该数据集通过定义多层次等级(tiers)、核心与扩展数据集集合,并固定各数据集的提交哈希值,为研究者提供了可重复、标准化的评估框架。其影响力在于推动了语音反欺骗领域的可复现性研究与公平比较,成为社区内评估算法性能的重要参考依据。
当前挑战
arena-manifest 数据集当前面临的核心挑战包括:一是所解决的领域问题中,语音欺骗检测算法在未知攻击类型上的泛化能力仍显不足,现有基准难以全面覆盖多样化欺骗手段,如深度伪造、语音转换与重放攻击等。二是在数据集构建过程中,需协调多源异构数据集(如 ASVspoof 系列)的版本一致性,确保核心集与扩展集在不同时间节点的可复现性,但各数据集的授权协议、预处理流程与评估指标差异增加了统一管理的复杂度。此外,如何动态更新清单以纳入新型攻击数据,同时维持排行榜的公平性与历史对比的连续性,亦是持续挑战。
常用场景
经典使用场景
随着语音合成与转换技术的飞速发展,语音欺骗检测(Spoofing Detection)成为声纹识别领域的关键挑战。arena-manifest 数据集作为一种轻量级清单文件,其核心用途在于定义与组织语音反欺骗基准测试中的标准化评估层级。它通过设定 tier 级别(如基础与扩展集)、明确各数据集的提交版本哈希,为研究社区提供了一个可复现、可追溯的实验配置框架。该数据集广泛应用于自动说话人验证(ASV)系统中的反欺骗评估协议制定,确保不同研究团队在统一标准下进行公平对比,推动语音安全技术的规范化发展。
衍生相关工作
基于 arena-manifest 所建立的规范,衍生了一系列重要的研究工作。最典型的是 SpeechAntiSpoofingBenchmarks 项目,它利用该清单构建了动态更新的排行竞技场,鼓励不同团队提交模型并实时比较。此外,speech-spoof-bench 包作为其官方工具集,封装了数据加载、评分计算与模型接口等底层逻辑,简化了研究者的开发流程。这些工作共同推动了语音反欺骗领域的社区协作,使得 ASVspoof 挑战赛之外,出现了更多灵活、持续的评估机制,深刻影响了该领域的研究范式。
数据集最近研究
最新研究方向
该数据集作为语音防欺骗基准测试(SpeechAntiSpoofingBenchmarks)竞技场的核心配置文件,正推动语音安全领域的前沿研究。当前研究方向聚焦于构建标准化、可复现的对抗性欺骗检测评估体系,通过定义多层级测试集(core/extended)和版本化的排名规则,支撑学术界与工业界在深度伪造语音检测、重放攻击防御等热点事件中的算法竞技。其轻量级单文件清单设计,结合git commit锁定的数据版本追溯机制,为语音生物识别系统的安全性评估提供了可扩展的基准框架,对应对日益泛滥的AI合成语音欺诈具有重要规范意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

