
遇见数据集

overthelex/ua-court-citation-graph

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

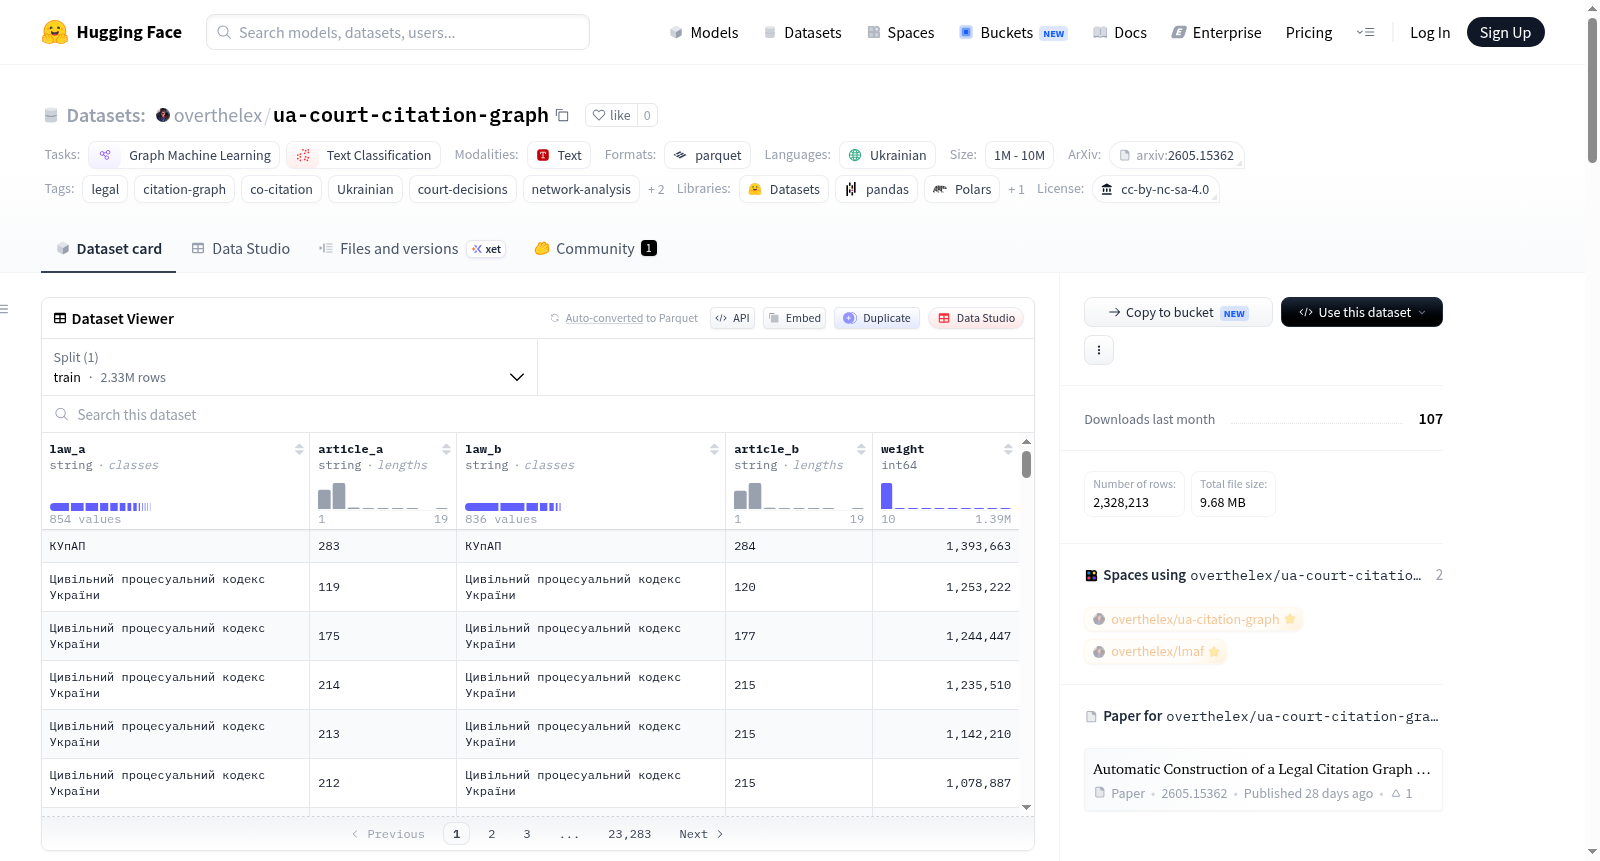
这是一个大规模共引图数据集,基于乌克兰法院判决统一国家登记册(ЄДРСР / EDRSR)中的9950万份法院判决构建。数据集包含乌克兰法律条款(如法律条文)的共引网络,时间跨度为2003年至2026年。当两个法律条款在同一份法院判决中被共同引用时,它们之间会建立连接,边的权重表示共同引用该对条款的判决数量。数据集通过正则表达式从判决文本中提取了3.45亿条引用,并过滤出权重≥10的共引边,最终包含约232.8万条边和5万个唯一法律条款。数据集文件包括:共引边文件(cocitation_edges),记录条款对及其权重;条款引用统计文件(article_citation_stats),列出最常被引用的条款及其引用次数;条款中心性文件(article_centrality),提供图的中心性度量(如度、PageRank);社区标签文件(community_labels),展示基于时间段的社区检测结果。该数据集适用于图机器学习、文本分类、法律网络分析等任务,可用于研究法律引用模式、社区结构和预测分析。关键发现包括网络具有幂律度分布(指数为2.17)、社区结构与法律领域(如刑事、民事法)对齐,以及时间稳定性高。数据集遵循CC-BY-NC-SA-4.0许可,学术和研究使用免费。

A large-scale co-citation graph derived from 99.5 million Ukrainian court decisions in the Unified State Register of Court Decisions (ЄДРСР / EDRSR). The dataset contains the co-citation network of Ukrainian legal provisions (articles) from 2003 to 2026, where two provisions are linked if they are cited together in the same court decision, with edge weights reflecting the number of decisions co-citing the pair. It includes extracted citations via regex patterns, filtered to edges with weight >= 10, resulting in approximately 2.33 million edges and 50,000 unique articles. Files include: co-citation edges (cocitation_edges) with pairwise article connections and weights; article citation statistics (article_citation_stats) for top-cited provisions; article centrality measures (article_centrality) such as degree and PageRank; and community labels (community_labels) from Louvain detection across time periods. The dataset is suited for graph ML, text classification, and legal network analysis, with key findings like power-law degree distribution (alpha=2.17), community alignment to legal domains, and high temporal stability. Licensed under CC-BY-NC-SA-4.0 for academic and research use.
提供机构:
overthelex
搜集汇总
数据集介绍
overthelex/ua-court-citation-graph 数据集图片
构建方式
该数据集源自乌克兰国家法院判决统一登记册中近一亿份司法裁决文书,通过正则表达式精准匹配乌克兰法律引用规范,从3.45亿条引用记录中提取出约3696万对独特的法条-判决关联对。在构建共引图时,将同一判决中共同出现的两条法律条文视为一条无向边,并设定权重阈值不低于10,最终生成包含232万余条边的密集网络,全面刻画了乌克兰立法体系在司法实践中的交互图景。
特点
该数据集呈现典型的无标度网络结构,幂律分布指数为2.17,证明了少数法条在司法引用中的枢纽地位。PageRank与原始度和HITS权威性得分之间的差异揭示了结构性中心性指标的重要性,例如民事诉讼法第10条因公平审判理念而获得最高PageRank排名。Louvain社区检测结果显示,模块度在0.54至0.61之间,社区结构清晰对应刑事、民事、行政及税法等法律领域,且在2017年司法改革后呈现出明显的社区重组模式。
使用方法
使用者可通过加载Parquet格式的共引边文件直接构建图结构进行网络分析与可视化,也可利用法条引用统计文件开展计量法学研究。图特征结合逻辑回归模型在预测2020至2026年顶 cite 法条时达到了0.9984的AUC值,验证了该数据集在法律预见性分析中的强大潜力。此外,时间分段的社区标签文件支持动态网络演化分析,便于追踪法律体系的结构性变迁与制度演变轨迹。
背景与挑战
背景概述
乌克兰统一国家法院判决登记册(ЄДРСР)作为东欧最大的司法文书数据库之一,收录了自2003年至2026年间近1亿份法院判决全文,为法律信息学与计算法学研究提供了前所未有的数据基础。2026年,研究者Volodymyr Ovcharov基于该语料库构建了乌克兰法院引用图(ua-court-citation-graph),通过正则表达式从3.45亿条引用记录中提取法律条文间的共引关系,形成了涵盖约5万条法律条款、包含230余万条加权边的共引网络。该数据集首次系统性地揭示了乌克兰法律体系的结构性特征,包括幂律度分布(指数α=2.17)、法律领域的社群聚类(Louvain模块度0.54-0.61)以及时序演化规律,为法律网络分析、司法决策预测与法律本体构建等方向提供了关键基准,推动了计算法学在斯拉夫语系司法体系中的实证研究。
当前挑战
该数据集所解决的核心领域挑战在于,传统法律分析长期依赖人工判例梳理与静态律典研究,难以捕获近亿级判决中法律条款之间的动态共引模式与隐性拓扑结构。ua-court-citation-graph通过大规模网络分析,实现了从海量非结构化判决文本到结构化法律知识图谱的自动转化,为法律影响力评估、先例追踪与判决结果预测提供了量化工具。构建过程中面临多重挑战:首先,乌克兰法律引用格式多样(法典条款、单行法、宪法条文等),需要设计高精度正则表达式模板以区分不同引用类型;其次,面对99.5万份判决中的3.45亿次引用,流式共引对构建需处理内存与计算效率的平衡,且需设置边权重阈值(≥10)以过滤偶然共引噪声;此外,法律条款的别名歧义(如简称与全称混用)与时间跨度达24年间的法律修订问题,增加了实体对齐的复杂性,最终通过结合统计过滤与领域知识验证得以缓解。
常用场景
经典使用场景
该数据集的核心用途在于构建和分析乌克兰法律领域的共引网络,通过将同一法院判决中共同引用的法律条款视为边,形成一张涵盖约5万条法律条款、超过230万条共引边的复杂网络。研究人员常利用该数据进行网络拓扑分析,例如揭示无标度特性(幂律指数α=2.17)、计算PageRank与HITS中心性指标,以及运用Louvain算法划分法律领域社群。此外,该数据集支持时间演化分析,通过分时段(2007-2026年)的社群检测,追踪司法改革对法律引用结构的动态影响,从而理解法律体系的内在关联性与演变规律。
实际应用
在实际应用层面,该数据集可助力司法人工智能系统的发展,例如辅助法律文书智能推荐与判决预测。通过分析特定案件涉及的条款共引模式,系统能够识别最相关的法律条文,提升法律检索的效率与准确性。同时,该数据还可用于法律知识图谱的构建,为律师、法官及立法者提供可视化的法律关联网络,例如识别不同法律之间的潜在冲突或协同关系。此外,该数据集的引用统计和中心性指标可用于评估立法修订的波及效应,为政策制定提供数据驱动的参考。
衍生相关工作
该数据集衍生了一系列具有影响力的研究工作,包括但不限于基于图特征的引用预测模型——利用逻辑回归在2007-2019年的网络结构特征上训练,即可对2020-2026年最常引用条款实现AUC=0.9984的精准预测。此外,该数据促进了法律NLP领域的跨任务发展,如与判决结果预测数据集(ua-case-outcome)结合,探索引用模式与裁判倾向间的关联。在理论层面,其揭示的社群结构稳定性(相邻时段NMI>0.85)也催生了关于司法话语权演变和制度变迁的计量法律学分析。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

