Bagpiper_TTS_SFT_Data
收藏资源简介:
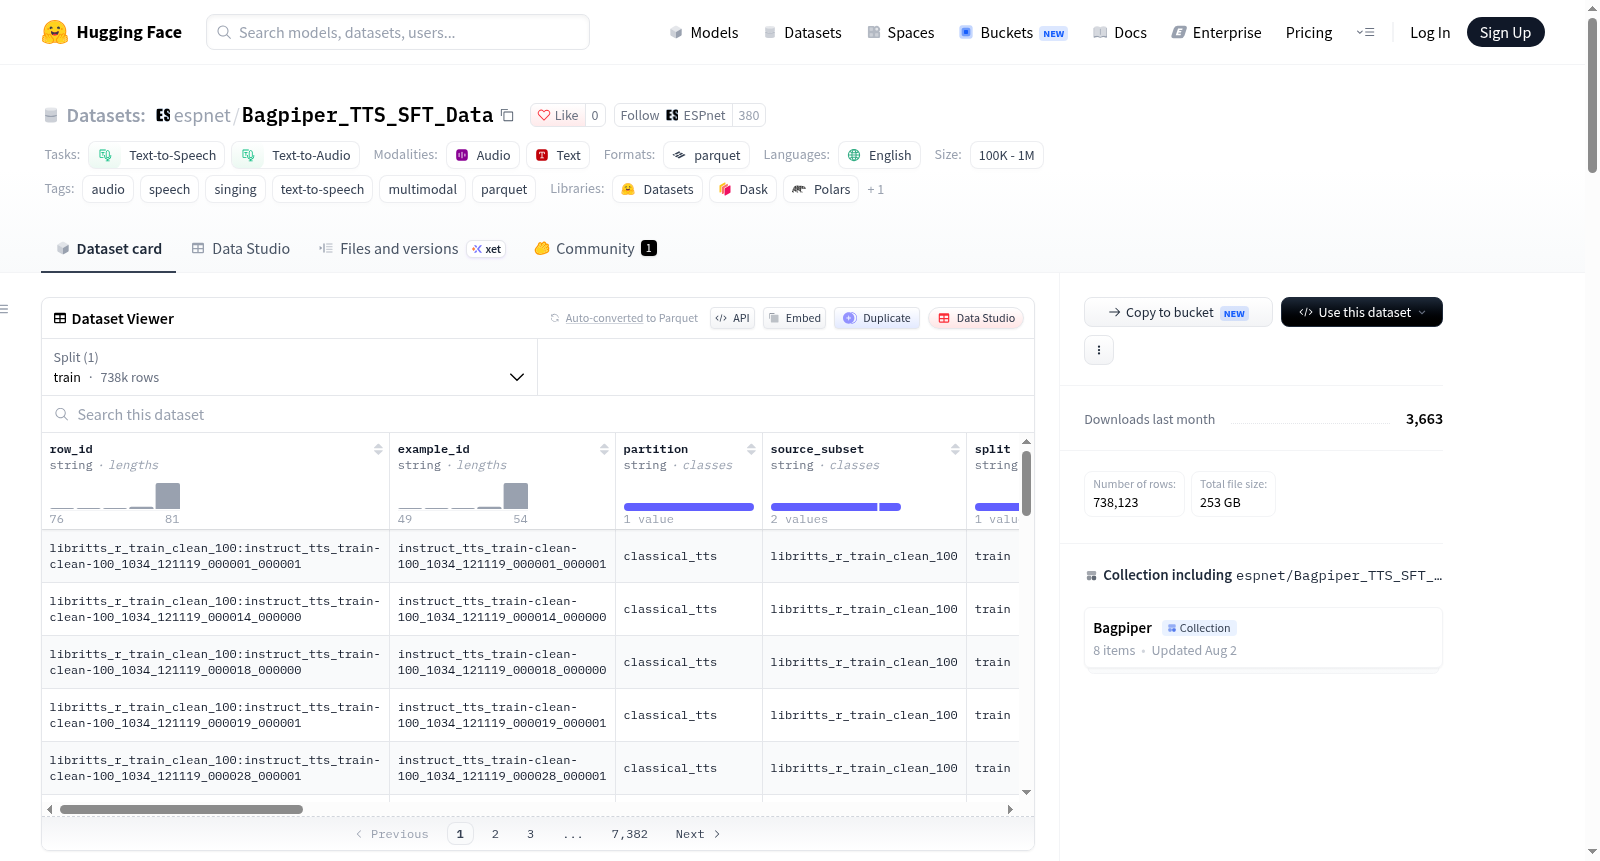
Bagpiper-TTS SFT Data 是一个为支持 Bagpiper-TTS 通用语音合成模型而构建的监督微调数据集。该数据集能够解释自由形式的自然语言请求,规划所需的输出,生成丰富的文本字幕,并合成目标音频。数据集以 Parquet 格式组织,所有样本自包含,每条记录包含用户请求、模型规划/字幕文本以及完整的编码音频字节,无需外部音频查找。数据集按论文中使用的六个应用场景划分:classical_tts(显式文本+自然语言语音和表达指令)、multi_talker(多说话人对话,含每个说话人特征)、intent_to_speech(传达交际意图,无需精确措辞)、role_play(角色/人物驱动的表现性语音)、svs(歌唱语音合成,含歌词和音乐指令)和 general_purpose(开放语音场景和非标准请求)。数据集总共有 738,123 行,分布在 1,151 个分片中,Parquet 数据约 253 GB,嵌入音频约 295.5 GB。数据构建流程包括从策划语音或歌唱音频出发,生成丰富字幕,提取或验证转录,过滤转录错误,反向模拟多样化自然语言请求,构建三部分规划轨迹,并应用一致性过滤。该数据集旨在用于研究指令跟随语音合成,不应被描述为语音克隆数据集或系统。已知限制包括:丰富字幕和模拟规划可能产生幻觉属性或内容;六个应用来源和过滤规则不同;部分原始来源存在未解决的重分发条款;可能包含合成或变换音频以及机器生成文本;未彻底审核个人信息、不安全内容、攻击性语言或受版权保护的文本/歌词。
Bagpiper-TTS SFT Data is a supervised fine-tuning dataset built to support the Bagpiper-TTS general-purpose speech synthesis model. This dataset can interpret free-form natural language requests, plan the required output, generate rich text captions, and synthesize target audio. The dataset is organized in Parquet format, with all samples self-contained; each record contains the user request, model planning/caption text, and complete encoded audio bytes, without the need for external audio lookup. The dataset is divided into six application scenarios used in the paper: classical_tts (explicit text + natural language voice and expression instructions), multi_talker (multi-speaker dialogue with speaker characteristics), intent_to_speech (conveying communicative intent without precise wording), role_play (character-driven expressive speech), svs (singing voice synthesis with lyrics and music instructions), and general_purpose (open speech scenarios and non-standard requests). The dataset has a total of 738,123 rows distributed across 1,151 shards, with Parquet data approximately 253 GB and embedded audio approximately 295.5 GB. The data construction process includes starting from curated speech or singing audio, generating rich captions, extracting or verifying transcripts, filtering transcription errors, reverse-simulating diverse natural language requests, constructing three-part planning trajectories, and applying consistency filtering. This dataset is intended for research on instruction-following speech synthesis and should not be described as a voice cloning dataset or system. Known limitations include: rich captions and simulated planning may produce hallucinated attributes or content; six application sources and filtering rules differ; some original sources have unresolved redistribution terms; may contain synthetic or transformed audio and machine-generated text; personal information, unsafe content, offensive language, or copyrighted text/lyrics have not been thoroughly reviewed.
Bagpiper-TTS SFT Data 数据集详情
数据集概览
Bagpiper-TTS SFT Data 是一个用于支持 Bagpiper-TTS 通用语音合成模型的指令微调数据集。该模型能够解析自由形式的自然语言请求、规划所需的语音输出、生成丰富的文本描述,并合成目标音频。
- 语言:英语
- 任务类别:文本转语音(text-to-speech)、文本转音频(text-to-audio)
- 数据规模:100K < n < 1M(总计 738,123 行)
数据组织方式
数据集按论文中使用的六种应用场景进行组织:
| 配置名称 | 能力描述 |
|---|---|
classical_tts |
带有自然语言声音和表达指令的显式文本转语音 |
multi_talker |
多说话人对话,支持各说话人特征设置 |
intent_to_speech |
无需精确措辞即可传达交流意图的语音生成 |
role_play |
角色/人物驱动的表现性语音 |
svs |
带歌词和音乐指令的歌声合成 |
general_purpose |
开放式语音场景和非常规请求 |
数据结构与加载方式
- 每条数据自包含:请求文本、规划/描述文本以及完整的编码音频字节均存储在同一 Parquet 行中,无需外部音频查找或表连接。
- 数据被切分为多个确定性 Parquet 分片,每个分片约 256 MiB。
- 训练对话不包含系统消息,每行按
user:text → assistant:text → assistant:audio顺序排列。 - 所有 738,123 行数据中,原始暂存 JSONL 中的任务特定系统消息已被统一移除。
- 推荐使用流式加载方式读取数据,可以通过指定 Parquet 文件的 glob 模式加载(例如
hf://datasets/espnet/Bagpiper_TTS_SFT_Data/intent_to_speech/*.parquet)。
发布统计
| 应用分区 | 行数 | 分片数 | Parquet 字节数 | 嵌入式音频字节数 |
|---|---|---|---|---|
classical_tts |
235,279 | 241 | 52,899,149,925 | 57,191,194,377 |
multi_talker |
64,659 | 170 | 38,632,502,383 | 44,989,933,724 |
intent_to_speech |
153,568 | 325 | 68,640,618,698 | 85,622,064,832 |
role_play |
47,116 | 107 | 22,456,138,107 | 28,130,403,188 |
svs |
101,887 | 120 | 29,503,615,421 | 31,274,125,012 |
general_purpose |
135,614 | 188 | 40,849,052,445 | 48,322,109,074 |
| 总计 | 738,123 | 1,151 | 252,981,076,979 | 295,529,830,207 |
classical_tts 分区包含:LibriTTS-R clean-100(17,656 行)、clean-360(60,657 行)、other-500(103,267 行)、Genshin(40,793 行)和 Star Rail(12,906 行)。
数据构建流程
数据构建流程包括以下步骤:
- 从精选的语音或歌声音频出发
- 创建详细的丰富描述(rich caption)
- 提取或验证转录文本
- 过滤转录错误
- 反向模拟多样化的自然语言请求
- 构建三部分规划轨迹
- 应用一致性过滤
论文使用 Qwen3-235B-A22B-Instruct-FP8 作为主要文本处理器,并可选使用 Gemini 进行音频验证。
预期用途与限制
预期用途:该数据集用于指令跟随语音合成的研究。Bagpiper-TTS 仅使用文本请求,不接受参考音频,因此不应被描述为语音克隆数据集或系统。
已知限制:
- 丰富的描述和模拟规划可能产生属性或内容幻觉
- 六种应用场景的数据来源和过滤规则存在异质性
- 部分原始源语料存在未解决的分发条款问题,在权利确认前相关示例将被扣留
- 游戏衍生语音、歌唱素材和基准/评估资产需要特别谨慎处理
- 数据可能包含合成或变换的音频以及机器生成的文本,而非专家标注
- 语料未经全面审核,可能存在个人信息、不安全内容、冒犯性语言或受版权保护的文本/歌词
相关资源
- 项目演示:Bagpiper-TTS
- 论文:OpenReview
- 项目主页:bagpiper-cmu.github.io
- 基础模型:espnet/bagpiper
- ESPnet 仓库:espnet/espnet