
MathArena/kangaroo_2025_11-12_outputs
收藏官方服务:
资源简介:
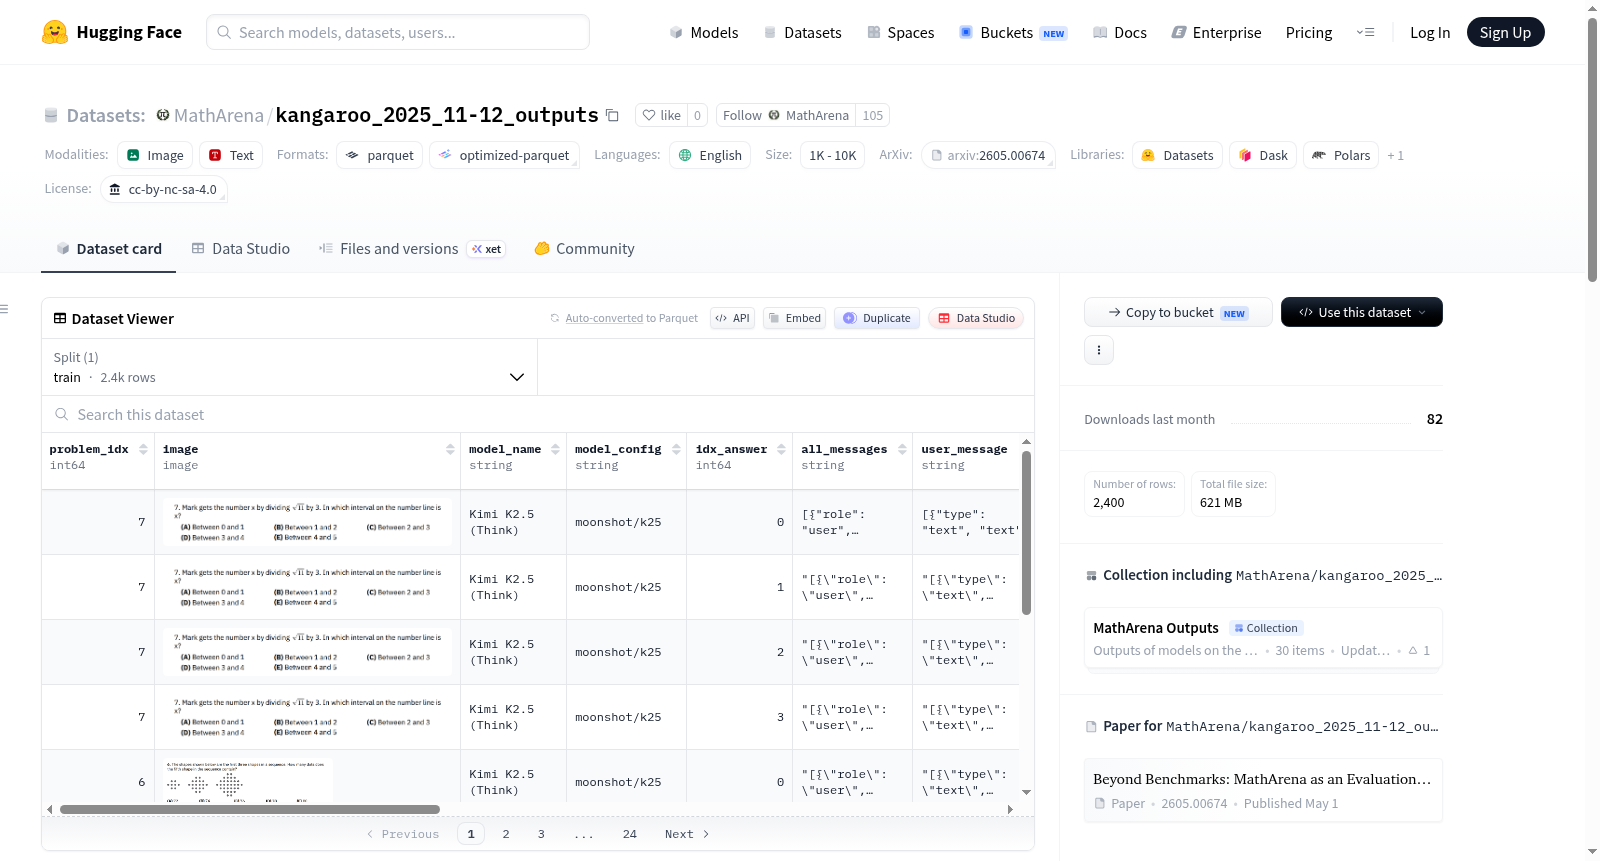
这是一个包含2025年袋鼠数学竞赛11-12年级问题的模型答案的数据集,由MathArena GitHub仓库生成。数据集中的字段包括问题索引、问题图片、真实答案、模型名称、模型配置、答案尝试索引、用户信息、模型答案、解析答案、正确性、输入输出令牌数、成本、每百万输入输出令牌的成本等。
This dataset contains model answers to the questions from Kangaroo 2025 11-12 generated using the MathArena GitHub repository, which includes fields such as problem index, problem image, ground-truth answer, model name, model configuration, answer attempt index, user message, model answer, parsed answer, correctness, number of input and output tokens, cost, cost per one million input and output tokens, etc.
提供机构:
MathArena搜集汇总
数据集介绍
构建方式
本数据集源自阿尔巴尼亚2025年袋鼠数学竞赛(Kangaroo 2025)中11-12年级的试题,原始题目经由提取、翻译及截图处理后,借助MathArena开源代码库,调用多种大语言模型生成回答。每条记录包含了从问题索引、对应图像、模型名称与配置,到完整的对话历史、用户提示与模型输出的详尽信息。在此基础上,利用自动评分流程,将模型解析答案与标准答案进行比对,并标记正确性,从而系统性地评估不同模型在数学推理任务上的表现。
特点
该数据集具有结构丰富、维度全面的特点,不仅涵盖模型输出的文本内容,还记录了每次推理的输入与输出令牌数、预估API成本等经济指标,为分析模型效率与性能的权衡提供了宝贵素材。此外,数据集保留了完整的对话序列与中间求解历史,支持对模型推理过程的深入剖析。所有样本均附带标准答案与解析结果,便于研究者直接进行自动化评估与对比实验。
使用方法
使用者可直接加载训练集中的数据,通过'image'字段获取问题图像,结合'user_message'与'answer'再现模型推理过程。'correct'字段提供了现成的正确性标注,适用于训练或评估数学推理模型的监督学习任务。借助'input_tokens'、'output_tokens'与'cost'等字段,可进一步开展模型经济性与效率分析。数据集以CC-BY-NC-SA 4.0协议发布,适合学术研究与非商业应用场景。
背景与挑战
背景概述
Kangaroo_2025_11-12_outputs数据集由瑞士苏黎世联邦理工学院计算机科学系的Jasper Dekoninck、Nikola Jovanović、Martin Vechev等学者于2026年创建,旨在评估大语言模型在数学推理任务中的表现。该数据集基于MathArena评估平台,收录了来自2025年阿尔巴尼亚袋鼠数学竞赛11-12年级的2400道问题及其模型回答,涵盖多项指标如答案正确性、推理步骤、API成本等,为研究LLM的数学能力提供了细粒度的结构化数据。作为MathArena基准测试的一部分,该数据集对推动语言模型在复杂数学推理领域的评估方法创新具有重要参考价值,促进了更可靠的自动化数学推理评测体系的发展。
当前挑战
该领域面临的核心挑战在于:数学推理需严格的形式化与符号操作能力,而当前LLM常受限于语义理解与逻辑一致性的平衡,尤其在多步推导、几何图形解析等复杂任务中易产生幻觉或逻辑断裂;此外,袋鼠竞赛题目的多语言翻译与截图处理需确保视觉信息无障碍输入模型,对跨模态对齐提出严苛要求。构建过程中的挑战包括:需从非结构化的竞赛试题中精准提取并翻译数学表达式与图形描述,确保数据标注的零歧义;同时,面对不同模型在相同问题上的输出差异,需设计统一的解析器(如MathArena Parser)实现答案标准化匹配,并控制API调用成本与流量波动对数据集规模的影响。
常用场景
经典使用场景
该数据集收录了大规模语言模型在阿尔巴尼亚袋鼠数学竞赛2025年11-12年级题目上的作答记录,涵盖模型名称、配置、完整对话历史、输入输出令牌数及API调用成本等丰富元信息。其经典用途在于系统性地评估和比较不同前沿语言模型在复杂数学推理任务上的表现,通过自动化的答案抽取与正确性校验机制,为研究者提供一个可复现的标准化评测基准。
解决学术问题
在学术研究中,该数据集有效回应了如何客观衡量语言模型数学推理能力的核心难题。传统评测常因题目泄露或打分主观性而失准,而此处通过竞赛级真题与精确的自动评分逻辑,确保了评估的严谨性与可对比性。其意义在于为模型在数学领域的缺陷诊断、训练策略调整及跨模型性能排位提供了可靠数据支撑,推动了人工智能数学推理研究的透明化与规范化。
衍生相关工作
基于此数据集,学界衍生出多项关键工作。例如,MathArena评测平台利用此类竞赛数据构建了可拓展的数学评估生态,推动了Beyond Benchmarks等研究理念的实践。后续工作还包括探究模型在数学推理中的错误模式分类、多步推理中的注意力机制分析,以及基于成本感知的模型选择策略,这些研究共同深化了我们对语言模型数学能力的理解与利用。
以上内容由遇见数据集搜集并总结生成


