遇见数据集

lamm-mit/scientific-sft-grpo-data

收藏
Hugging Face2026-07-21 更新2026-07-22 收录
官方服务:

资源简介:

该数据集包含多个配置,主要用于训练和评估自然语言处理模型,特别是针对任务完成、科学设计推理和指令遵循等场景。数据集特征包括任务ID、论文ID、提示(包含角色和内容)、任务描述、参考推理、参考答案、参考证据、机制步骤、因果链接、必需概念、必需约束、评估标准、可接受替代方案、失败模式等。数据集划分为训练集、验证集和测试集,不同配置的数据量从几千字节到几千万字节不等,示例数量从几个到几千个。数据集可能用于支持强化学习(如GRPO)和监督微调(SFT)等机器学习方法,适用于生成对话、科学问题解决和因果推理等任务。

This dataset includes multiple configurations designed for training and evaluating natural language processing models, particularly for task completion, scientific design reasoning, and instruction following. The features consist of task ID, paper ID, prompt (with role and content), task description, reference reasoning, reference answer, reference evidence, mechanism steps, causal links, required concepts, required constraints, evaluation criteria, acceptable alternatives, failure modes, and more. The dataset is split into training, validation, and test sets, with data sizes ranging from a few kilobytes to tens of megabytes and example counts from a few to thousands. It is likely used to support machine learning methods such as reinforcement learning (e.g., GRPO) and supervised fine-tuning (SFT), applicable to tasks like dialogue generation, scientific problem-solving, and causal reasoning.

提供机构:
lamm-mit
原始信息汇总

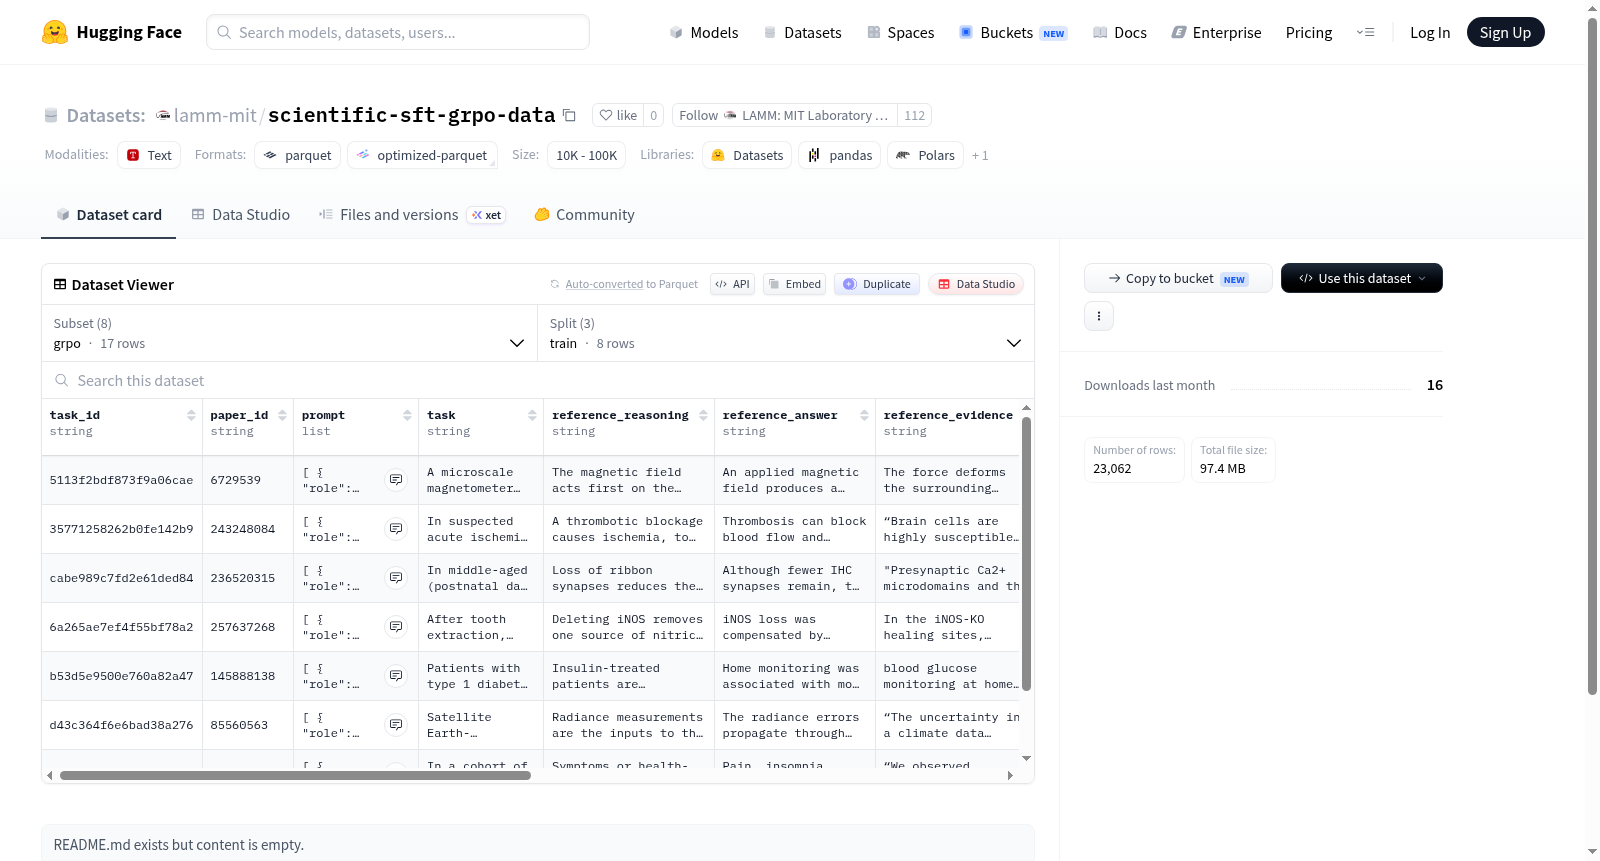
数据集概览:lamm-mit/scientific-sft-grpo-data

  • 数据集名称:lamm-mit/scientific-sft-grpo-data
  • 发布机构:LAMM: MIT Laboratory for Atomistic and Molecular Mechanics (lamm-mit)
  • 模态:文本 (Text)
  • 格式:parquet, optimized-parquet
  • 规模:10K - 100K 条记录
  • 库依赖:Datasets, pandas, Polars 等

数据集内容

该数据集包含科学机制推理任务,每个样本包含以下字段:

  • task_id: 任务唯一标识符
  • paper_id: 来源论文ID
  • prompt: 系统与用户提示消息,要求解决科学机制任务并解释因果链
  • task: 科学机制任务描述文本
  • reference_reasoning: 参考推理过程
  • reference_answer: 参考答案
  • reference_evidence: 任务中引用最相关观察的原文
  • mechanism_steps: 机制步骤列表
  • causal_links: 因果链列表(包含因果关系键值对)
  • required_concepts: 所需概念列表
  • source_license: 来源许可证(如 CCBY)
  • source_url: 来源论文URL

数据集划分与子集

  • 子集 (Subset): 共8个,包括 grpo (17行)、scientific_design_grpo (675行)、scientific_design_grpo_L (1.2k行)、scientific_design_sft (575行)、scientific_design_sft_L (10k行)、scientific_design_sft_L_messages (10k行)、scientific_design_sft_messages (575行)、sft (20行)
  • 划分 (Split): 训练集 (train) 8行、验证集 (validation) 4行、测试集 (test) 5行(示例中仅展示grpo子集的train划分)

示例数据内容

数据集样本涵盖跨学科科学机制,例如:

  • 磁力计中微磁体与聚合物变形对光学腔响应的影响
  • 急性缺血性中风(AIS)的院前筛查与治疗黄金时间
  • 内毛细胞突触丢失与代偿性增强导致听觉过敏
  • 一氧化氮合酶缺失后其他亚型补偿促进骨愈合
  • 家庭血糖监测与低血糖报告之间的关联(横断面研究局限性)
  • 卫星辐射测量不确定度传播至气候数据记录
  • 治疗性大麻使用动机与未满足医疗需求
  • microRNA319通过切割位点调控转录因子TCP基因表达
搜集汇总
数据集介绍
lamm-mit/scientific-sft-grpo-data 数据集图片
构建方式
在科学推理与实验设计的广阔领域中,为提升大语言模型的逻辑严谨性与因果推断能力,scientific-sft-grpo-data数据集应运而生。该数据集的构建植根于生物医学文献,通过从已发表论文中提取并结构化关键信息,精心策划了涵盖因果推理与实验设计两大维度的样本。构建过程包括两个核心分支:其一为通用科学推理数据(grpo与sft配置),针对每个科学问题,独立标注出分步推理过程、因果链路、参考证据及最终结论,形成包含任务ID、论文来源、多轮对话提示及答案的完整单元;其二为科学实验设计数据(scientific_design系列),进一步细分为SFT(监督微调)与GRPO(群体相对策略优化)两种格式,分别包含任务家族分类、约束条件、评估标准、可接受替代方案及失败模式等结构化字段。数据采用大规模样本集,其中scientific_design_sft_L配置包含高达9000条训练样本,覆盖广泛任务类型,确保了领域知识的深度与广度。
使用方法
研究人员可通过HuggingFace Datasets库便捷地加载scientific-sft-grpo-data,利用其多配置结构灵活适配不同训练需求。对于监督微调任务,建议选用scientific_design_sft_L或scientific_design_sft配置,其中包含系统提示与模型回答的结构化对话对,可直接用于训练对话式语言模型;而对于偏好优化任务,scientific_design_grpo及grpo配置内置了任务提示与参考标准答案,适合应用于基于奖励的强化学习方法,例如GRPO算法。具体使用时,可以依据task_id或task_family字段筛选特定领域的科学问题,利用prompt字段构建输入,并以completion或reference_answer作为目标输出。对于因果推理场景,mechanism_steps与causal_links字段可作为额外监督信号。此外,数据集已预先划分为训练、验证与测试集,便于直接开展交叉验证与性能评估,为科学AI的基准测试提供了标准化平台。
背景与挑战
背景概述
在计算生物学与人工智能交叉领域,科学推理的自动化正成为推动实验设计革新的关键动力。scientific-sft-grpo-data数据集由研究机构基于强化学习中的GRPO算法与监督微调范式构建,旨在训练大型语言模型掌握因果推理、实验机制设计与约束条件解析等核心科学能力。该数据集于2024年发布,其核心研究问题聚焦于如何通过结构化任务样本(如因果链接、失败模式与可接受替代方案)使语言模型具备可验证的科学论证逻辑。通过整合论文标识符、机制步骤与评价标准,该数据集为科学实验的自主设计提供了标准化训练资源,对自动化科研助手领域产生了深远影响。
当前挑战
该数据集面临的挑战包括:第一,领域问题层面,科学实验设计需满足严格的因果一致性、约束逻辑与可重复性,而当前语言模型在复杂科学推理中常产生因果谬误或忽略关键约束,数据集通过显式标注因果链接与失败模式试图弥合这一鸿沟。第二,构建过程中,从异构科学文献中提取结构化标签(如机制步骤、因果链与评价准则)依赖精细的人工标注专家知识,数据规模扩展与噪声控制之间存在张力,尤其是大型版本(如scientific_design_sft_L的9000条训练样本)需平衡覆盖广度与标注质量。第三,GRPO配置中的参考推理与证据字段要求模型超越浅层模式匹配,实现深层次机理理解,这对训练数据的语义粒度和多样性提出了严苛标准。
常用场景
经典使用场景
在科学智能(AI for Science)这一前沿交叉领域中,scientific-sft-grpo-data数据集的核心价值在于为大型语言模型提供高度结构化的科学推演与实验设计训练素材。该数据集融合了监督微调(SFT)与基于群体相对策略优化(GRPO)的强化学习范式,能够有效引导模型学习科学论文中的因果推理链条、机制步骤以及实验约束条件。其经典使用场景聚焦于训练具备科学思辨能力的语言模型,使其能够基于给定的研究背景,自动生成包含明确因果关系的科学推演文本,并在多轮对话中完成复杂的科研任务设计,从而显著提升模型在科学发现与假设生成任务上的表现。
解决学术问题
该数据集直击当前科学研究中的一个关键瓶颈:如何利用人工智能自动从海量文献中提取可验证的因果机制,并生成符合科学规范的研究方案。传统方法多依赖人工标注与规则匹配,难以兼顾推理的深度与灵活性。scientific-sft-grpo-data通过提供包含因果链接、关键概念与评估准则的结构化数据,使得语言模型能够学习到科学推理的形式化逻辑,从而解决学术领域中推理不透明、实验设计缺乏系统性等问题。其意义在于为自动化科学发现提供了可训练的数据基石,推动模型从简单的信息检索向深层次的知识发现与理论建构迈进,对计算社会科学、生物医学研究乃至物理学中的理论推导都具有深远影响。
实际应用
在实际应用中,该数据集驱动的人工智能系统能够辅助科研人员完成多项繁重任务。例如,在生物医学领域,模型可以基于给定的分子机制与病理背景,自动设计体外实验的约束条件与评估指标,并预判潜在的失败模式。在材料科学中,它能够根据化学反应的因果链条,生成新的实验方案与工艺参数建议。此外,该数据集还支持科研写作辅助系统,通过理解论文中的机制步骤,自动生成符合学术规范的实验方法描述与结果讨论。这些应用不仅显著缩短了科研周期,还降低了实验设计中对专家经验的过度依赖,使得跨学科研究协作变得更加高效与精准。
数据集最近研究
最新研究方向
该数据集聚焦于利用强化学习中的GRPO算法与监督微调(SFT)策略,推动科学实验设计与因果推理的前沿探索。通过构建包含任务指令、约束条件、评估标准及失败模式的结构化样本,研究团队着力于训练大语言模型具备自主设计实验方案与推导科学机制的能力。这一方向紧密关联当前AI for Science的热潮,旨在突破模型在复杂科学推理中的瓶颈,为自动化科学发现与可解释性研究提供高质量训练资源,其规模化版本(如scientific_design_sft_L)更预示着向多领域科学任务的泛化潜力。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务