
遇见数据集

David-beakr/agent-harness-seed

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

Agent Harness Seed v0.3 是一个小型数据集,包含16个单轮和多轮代理案例,专门用于评估代理工具的可靠性,重点关注指令遵循、工具选择与避免使用错误工具、跨轮次状态跟踪以及在需要时请求澄清等核心能力。该数据集基于tau-bench和BFCL两篇论文的理论基础,并针对Beakr内部需求进行了扩展,包括澄清和格式遵循等行为。数据集采用混合检查方法,结合确定性检查(如字符串匹配、工具调用验证)和LLM法官评估,以确保语义正确性。

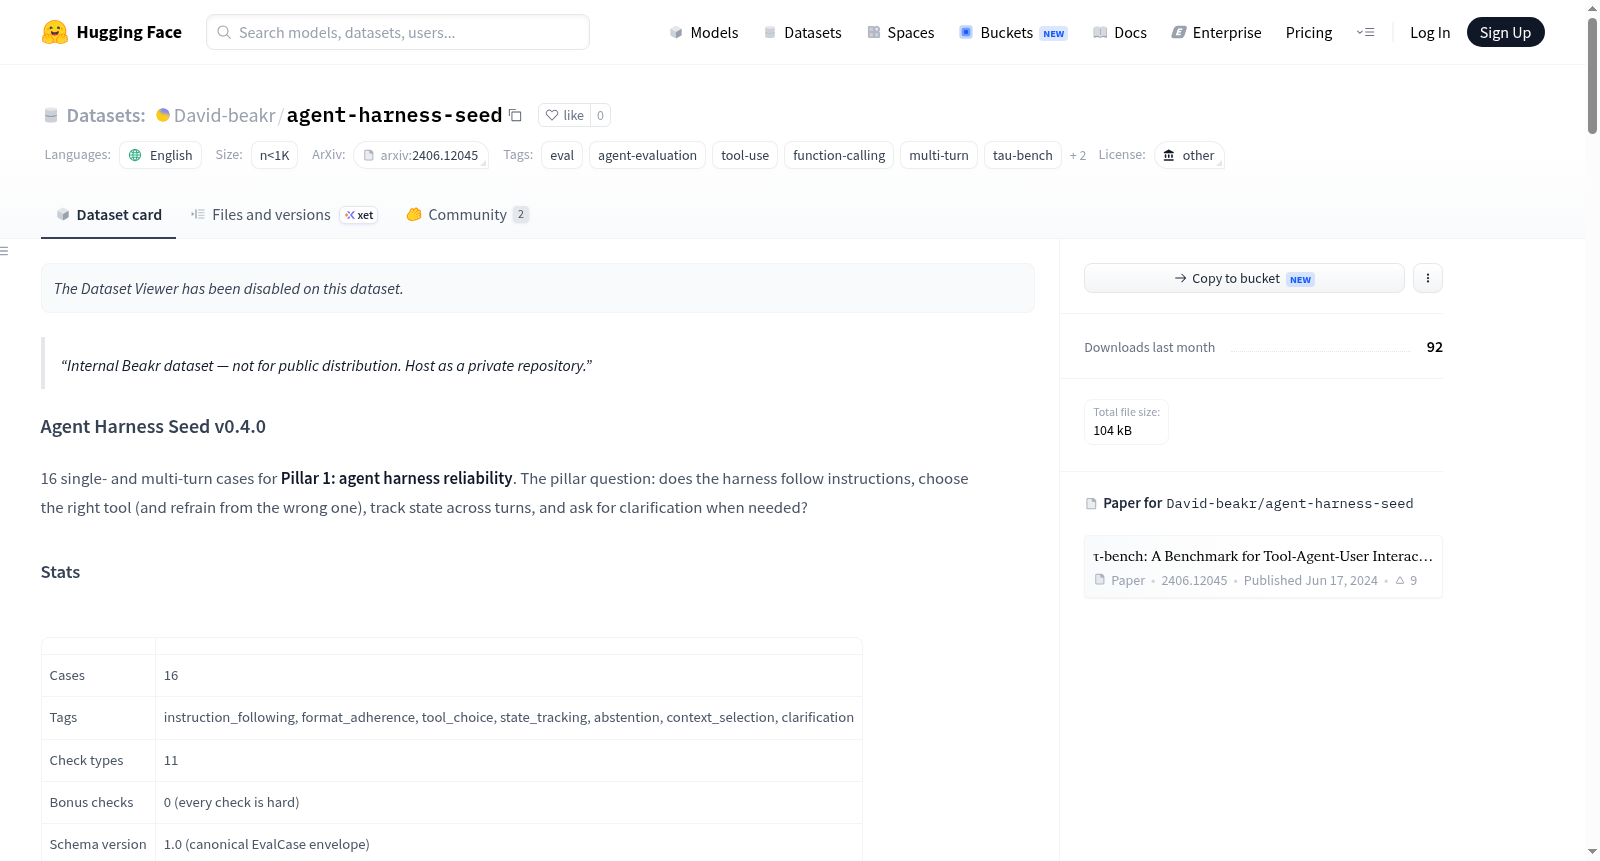
Agent Harness Seed v0.3 is a small dataset of 16 single-turn and multi-turn agent cases designed to evaluate agent harness reliability, focusing on pillar 1: instruction-following, tool choice (and refraining from wrong tools), state tracking across turns, and asking for clarification when needed. It is grounded in two anchor papers (tau-bench and BFCL) and extends beyond them with Beakr-specific behaviors like clarification and format adherence. The dataset employs a hybrid checking methodology, combining deterministic checks (e.g., string matching, tool call verification) with LLM judge evaluations to ensure semantic correctness.
提供机构:
David-beakr
搜集汇总
数据集介绍
David-beakr/agent-harness-seed 数据集图片
构建方式
Agent Harness Seed v0.4.0 数据集采用确定性构建策略,基于 tau-bench 与 BFCL 两大权威基准的核心理念进行设计。它通过预定义固定对话脚本(transcript)与模拟工具返回值(fixture_return)来构建16个单轮及多轮的评估案例。每个案例严格按照规范的 EvalCase 信封结构组织,包含输入(input)、参考(reference)与元数据(metadata)三大模块,其中参考部分详细定义了多种类型的检查规则(checks),如精确字符串匹配、JSON 结构验证、工具调用次数统计等,从而确保评估过程的客观与可复现。
使用方法
使用者可通过 Hugging Face Hub 的 snapshot_download 接口加载 gold.json 文件,获取16个评估案例。运行时需按顺序逐轮重放每个案例的对话记录,借助 fixture_return 模拟工具响应,并依据 reference.checks 中的 applies_to 字段在指定轮次执行检查。特别地,对于包含 LLM 裁判的案例,需要集成外部语言模型以完成语义层面的判断。该数据集不涉及网络请求或沙箱环境,专注于纯粹的逻辑正确性验证,适合作为智能体框架基础可靠性的快速测试集。
背景与挑战
背景概述
Agent Harness Seed v0.4.0 是由 Beakr 团队于 2024 年构建的内部数据集,旨在评估智能体执行框架(agent harness)的可靠性。该数据集聚焦于核心研究问题:执行框架能否严格遵循指令、精准选择并规避误用工具、在多轮对话中追踪状态,以及在信息不足时主动请求澄清。数据集以 tau-bench(Yao et al., 2024)和 BFCL(Patil et al., ICML 2025)为理论锚点,通过 16 个精心设计的测试用例,覆盖指令遵循、格式遵从、工具选择、状态追踪、弃权、上下文筛选和澄清等关键能力。其设计兼具理论深度与实践导向,为智能体系统的可靠性评估提供了可复现的基准,对推动工具增强型大语言模型的鲁棒性研究具有重要意义。
当前挑战
该数据集所面临的挑战主要来自两个层面。在领域问题层面,智能体执行框架面临的核心困难在于平衡工具使用的灵活性与指令约束的严苛性:如何确保模型在复杂多轮交互中不产生工具误用、状态混乱或策略违背,同时应对开放域中的歧义情境。在构建过程中,数据集需在极小的规模(16 个用例)内系统性地覆盖指令遵从、格式约束、上下文筛选等多样化的评估维度,并设计出既包含确定性检查(如精确字符串匹配、工具调用计数)又融入大模型评判的混合评分策略。此外,还需解决工具调用匹配的精度问题(如缺少 AST 严格类型匹配)、缺乏动态用户模拟以及多语言工具支持缺失等局限,从而在有限资源下实现评估信号的有效性与可靠性。
常用场景
经典使用场景
Agent Harness Seed v0.4.0作为智能体框架可靠性评估的核心数据集,其经典使用场景聚焦于多轮对话中工具调用行为的系统性验证。该数据集通过精心设计的16个测试用例,覆盖指令遵循、格式一致性、工具选择、状态追踪、拒绝回答、上下文筛选及澄清请求等关键维度,为评估智能体系统在复杂交互中的鲁棒性提供了标准化基准。研究者可借助该数据集对harness框架进行压力测试,检验其是否能够精准遵循用户指令、规避不当工具调用、跨轮次维护上下文状态,并在信息不明确时主动请求澄清。这种面向底层可靠性的评估范式,为构建更稳定的智能体系统奠定了坚实基础。
解决学术问题
该数据集针对智能体评估领域的核心痛点——即现有基准如tau-bench和BFCL在细粒度行为测试上的局限性——提出了系统性解决方案。tau-bench侧重端到端任务完成度,BFCL聚焦函数调用准确性,但二者均未充分覆盖指令遵循、格式约束、主动澄清等harness层面的关键交互特征。Agent Harness Seed通过填补这一空白,使研究者能够量化分析智能体框架在特定约束下的决策质量,例如检测模型是否在已知答案时不当调用工具、能否从干扰信息中识别关键上下文。这种面向基础可靠性的评估方法论,推动了智能体系统从功能验证向行为可靠性研究的深化,对构建可信赖的人机交互系统具有重要的学术价值。
实际应用
在实际应用中,Agent Harness Seed为智能体系统的工业化部署提供了关键的质量保障工具。企业可在集成智能体框架之前,利用该数据集对候选系统进行标准化压力测试,确保其在实际场景中能够准确执行任务而不引发错误连锁反应。例如,在客户服务场景中,系统需正确判断何时调用退款API、何时仅提供政策说明;在数据分析任务中,智能体需从多文档中精准锁定相关信息。该数据集通过模拟这些复杂决策边界,帮助开发者识别模型在边界条件下的脆弱性,从而针对性地优化提示策略或工具调用逻辑。这种预部署测试机制显著降低了智能体系统上线后的风险。
数据集最近研究
最新研究方向
当前,智能体(Agent)系统的可靠性评估成为大语言模型应用落地的核心挑战。该数据集聚焦于智能体框架的‘缰绳’(Harness)可靠性,通过16个精心设计的单轮与多轮案例,系统性地检验指令遵循、工具选择、状态追踪及澄清请求等关键能力。其研究前沿在于将tau-bench的多轮交互状态评估与BFCL的函数调用精确性相融合,并创新性地引入‘弃权’与‘格式遵守’等扩展维度。该工作不仅为智能体框架的标准化评估提供了可复现的基准种子,更揭示了从确定性规则到LLM法官判分的混合评估策略,对于推动智能体在复杂任务中的可信执行具有里程碑式的意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

