
遇见数据集

David-beakr/kg-retrieval-seed

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

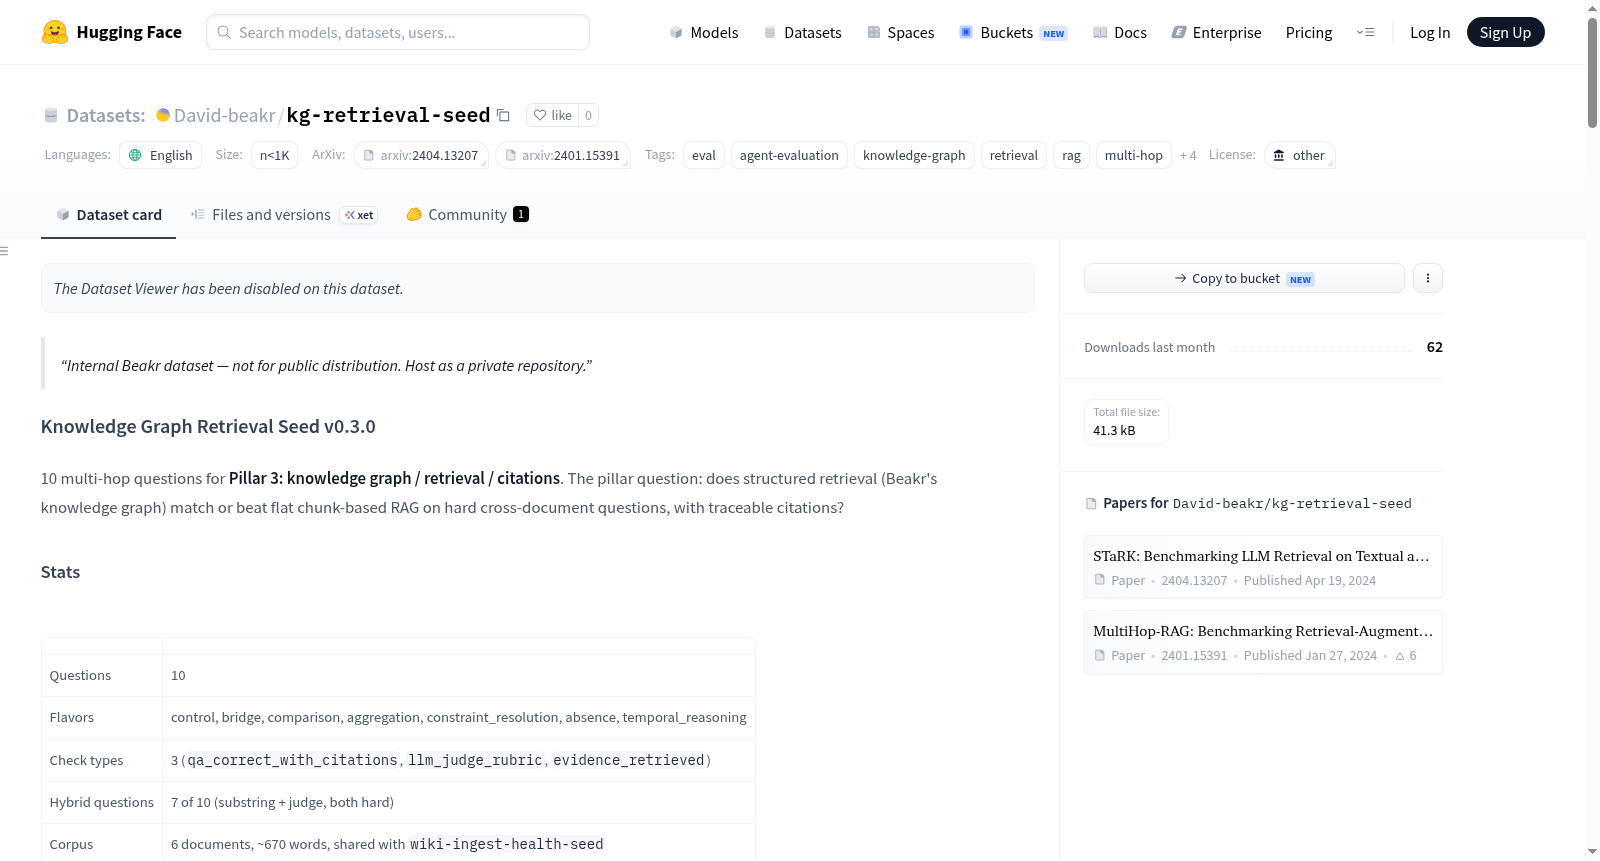
这是一个内部使用的知识图谱检索种子数据集(版本v0.2.1),专为评估知识图谱、检索和引用能力而设计。数据集包含10个多跳问题,用于测试结构化检索(基于知识图谱)在困难的跨文档问题上是否优于扁平分块RAG,并确保答案具有可追溯的引用。每个问题都附带黄金答案、检查项(包括硬检查和奖励检查)和预期支持文档。语料库由6个固定文档组成(约670词),与配套数据集wiki-ingest-health-seed共享。数据集的设计基于STaRK和MultiHop-RAG等文献,并引入了问题类型映射和方法偏差。检查方法结合了确定性子串匹配和LLM法官评估,以分离检索质量和答案质量。数据集还支持扩展,例如增加问题数量、改进检索指标和扩大语料库规模。

This is an internal Knowledge Graph Retrieval Seed dataset (version v0.2.1) designed for evaluating knowledge graph, retrieval, and citation capabilities. It contains 10 multi-hop questions to test whether structured retrieval (based on a knowledge graph) outperforms flat chunk-based RAG on hard cross-document questions, with traceable citations. Each question includes gold answers, checks (both hard and bonus), and expected supporting documents. The corpus consists of 6 fixture documents (approximately 670 words), shared with the companion dataset wiki-ingest-health-seed. The design is grounded in literature such as STaRK and MultiHop-RAG, with question flavor mapping and methodological deviations. The check methodology combines deterministic substring matching and LLM judge evaluation to separate retrieval quality from answer quality. The dataset also supports extensions, such as adding more questions per flavor, improving retrieval metrics, and scaling to larger corpora.
提供机构:
David-beakr
搜集汇总
数据集介绍
David-beakr/kg-retrieval-seed 数据集图片
构建方式
kg-retrieval-seed数据集由Beakr团队精心构建,旨在评估知识图谱检索与引用的能力。其核心语料库包含6份文档,约670词,与wiki-ingest-health-seed数据集共享,确保测试环境的一致性。数据集的构建基于STaRK和MultiHop-RAG两大锚定基准,手工设计了10道多跳问题,涵盖控制、桥接、比较、聚合、约束解析、缺失推理和时序推理等多种风味,以全面检验结构化检索相较于传统分块RAG在跨文档复杂查询中的效能。每个问题均采用规范的EvalCase信封格式封装,包含唯一标识符、输入问题、参考答案、预期文档来源及多类型检查条件,其中7题为混合型,结合子串匹配与LLM裁判,以确保评估的严谨性与语义完整性。
使用方法
使用方法简便直观。数据集随附的corpus目录已包含全部语料文档,无需外部获取。用户可通过huggingface_hub库的snapshot_download函数一键下载整个仓库,随后解析gold.json文件即可获取所有测试案例。每个案例的EvalCase信封中清晰定义了输入、参考答案、预期文档源及检查条件。评估时,系统需对每个问题生成答案并引用来源;硬性检查(如子串匹配与LLM裁判)必须全部通过,而奖励性检查(如证据检索)仅在评估工具暴露检索集时才执行。对于7道混合问题,需集成LLM裁判进行语义判分,确保回答不仅包含关键词,更真正回应了问题核心。
背景与挑战
背景概述
知识图谱与检索增强生成(RAG)技术的融合已成为提升大语言模型事实性与可解释性的关键方向。在此背景下,Beakr团队于2024年构建了kg-retrieval-seed数据集,旨在系统评估结构化知识图谱检索相较于传统扁平化分块检索在多跳跨文档问答任务中的表现。该数据集由10个精心设计的种子问题组成,覆盖控制、桥接、比较、聚合、约束消解、缺失识别与时间推理七种推理类型,依托Project Harbor语料库(6篇文档,约670词)构建。问题设计深度借鉴了STaRK(Wu et al., NeurIPS 2024)与MultiHop-RAG(Tang & Yang, COLM 2024)的评估框架,并引入可追溯引用作为答案正确性的必要条件。作为Beakr内部分项测试的核心组件,该数据集为验证结构化检索在复杂推理场景中的优势提供了结构化基准。
当前挑战
该数据集面临的核心挑战体现在两个层面。在领域问题层面,多跳问答中不同文档间信息的关联、冲突与时间敏感性要求检索系统不仅具备跨文档链接能力,还需能区分干扰信息(如废弃草案),这对传统扁平化检索的相似度匹配策略构成了根本性挑战;同时,答案需附带精确来源引用,进一步提升了推理过程的透明性要求。在构建层面,团队面临规模与有效性之间的权衡:仅10个问题无法涵盖真实世界的检索多样性,却足以通过精妙的种子设计暴露系统缺陷;此外,评估体系需同时处理封闭形式(如精确值匹配)与开放语义答案,且需将检索质量与问答正确性解耦作为独立信号,这要求评估框架具备高度灵活性。数据集的混合评分策略(7/10问题采用LLM评判)既保证了评估的鲁棒性,也引入了对评判模型可靠性的依赖。
常用场景
经典使用场景
知识图谱检索与多跳问答是当前信息检索领域的前沿课题,kg-retrieval-seed数据集正是为此而生。该数据集精心设计了10个涵盖多种认知复杂度的问题,从简单的单跳基线查询到复杂的跨文档推理任务。其经典使用场景在于评估结构化知识图谱检索系统在应对需要跨越多个文档片段、进行逻辑链条推理的复杂问题时,能否有效替代或超越传统的基于块检索的RAG方法。每个问题均包含标准答案、来源文档及多维度检查机制,为模型在知识密集型问答中的表现提供了精准的评测标尺。
解决学术问题
kg-retrieval-seed致力于解决当前RAG评测中面临的几个核心学术瓶颈。其一,传统基准测试往往忽略跨文档的多跳推理能力,而该数据集通过桥接、比较、聚合等七种推理风格,系统考察模型对离散信息片段的整合与逻辑串联能力。其二,针对检索质量与答案质量解耦的难题,数据集引入了独立的证据检索评估机制,能够分离检索模块与生成模块的贡献。其三,通过引入约束消解、时间推理和缺失判断等高级认知任务,填补了现有评测体系中关于否定推理和时间敏感信息检索的空白,推动了更严谨的评估范式的建立。
实际应用
在产业应用中,kg-retrieval-seed所评测的能力直接映射到多种高价值场景。在企业知识管理领域,该数据集模拟了分析人员面对跨部门文档(如项目计划、状态报告、责任分配矩阵)时,需要整合多源信息进行决策支持的典型场景。在法律与医疗领域,其衡量的是系统能否从散落的卷宗或病历中准确提取时间线、排除过时信息并遵循既定边界,这对构建可靠的合规审查和临床决策支持系统至关重要。此外,数据集对引文可溯源性的强调,也使其成为评估企业内部审计追踪、科学文献综述生成等场景中AI系统可信度的理想工具。
数据集最近研究
最新研究方向
知识图谱检索与多跳推理的评估范式正经历从扁平化块检索向结构化图谱检索的深刻转变。以kg-retrieval-seed为代表的基准测试集,聚焦于检验结构化检索在跨文档复杂问答中是否优于传统RAG方法,并强调可追溯引用。该数据集融合了STaRK和MultiHop-RAG的前沿设计理念,涵盖了控制、桥接、比较、聚合、约束求解、缺失检测和时间推理等七种推理风味,其中七成问题引入混合评分机制(子串匹配结合LLM评判),以规避单纯关键词匹配的语义陷阱。这一评估框架推动了知识图谱驱动的多跳推理研究,为构建可信、可解释的智能问答系统奠定了重要基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

