
遇见数据集

lance-format/stanford-cars-lance

收藏
Hugging Face2026-05-08 更新2026-05-10 收录
官方服务:

资源简介:

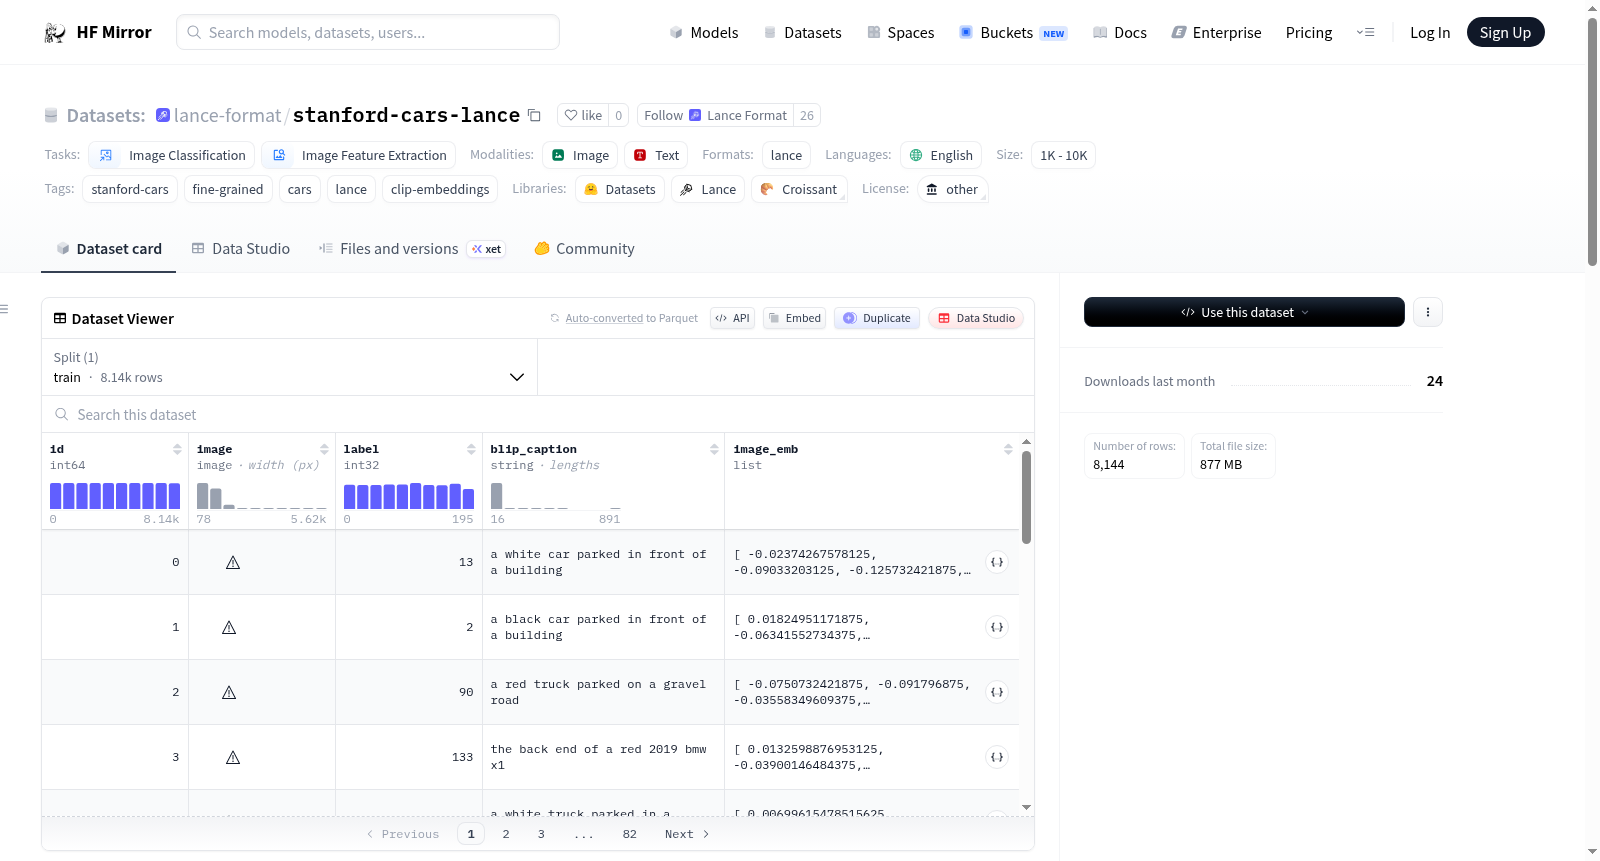
Stanford Cars(Lance格式)数据集是Stanford Cars数据集的Lance格式版本,包含8,144张训练图像,涵盖196个细粒度的汽车品牌/型号/年份类别。数据集包含图像数据、标签、BLIP生成的标题和OpenCLIP嵌入等列。还提供了预构建的索引以支持高效查询,并提供了快速入门、基于标题的过滤和视觉相似性搜索的示例。数据集源自Multimodal-Fatima/StanfordCars_train,仅限非商业研究使用。

The Stanford Cars (Lance Format) dataset is a Lance-formatted version of the Stanford Cars dataset, containing 8,144 training images across 196 fine-grained car make/model/year classes. The dataset includes columns for image data, labels, BLIP-generated captions, and OpenCLIP embeddings. It also features pre-built indices for efficient querying and provides examples for quick start, caption-based filtering, and visual similarity search. The dataset is sourced from Multimodal-Fatima/StanfordCars_train and is intended for non-commercial research use.
提供机构:
lance-format
搜集汇总
数据集介绍
lance-format/stanford-cars-lance 数据集图片
构建方式
斯坦福汽车数据集(Stanford Cars)是细粒度图像分类领域的经典基准,涵盖196种汽车品牌、型号及年份类别。本数据集以Lance格式重构,从Multimodal-Fatima/StanfordCars_train镜像中提取了8144张训练图像,每张图像以JPEG字节形式存储于'image'字段。此外,数据表整合了通过BLIP模型(beam=5)生成的文本描述(blip_caption),并预计算了OpenCLIP ViT-B-32架构下的512维余弦归一化图像嵌入(image_emb),从而形成多模态索引基础。
特点
本数据集的核心亮点在于其专为高效检索设计的预构建索引体系:image_emb字段上建立了IVF_PQ索引(余弦相似度度量),支持毫秒级视觉相似性搜索;blip_caption字段配置了倒排索引(FTS),允许用户通过自然语言描述进行语义过滤;label字段的B树索引则便于类别的快速筛选。这种多索引架构使得数据查询兼具灵活性与高性能,特别适用于细粒度分类、跨模态检索及嵌入空间分析等场景。
使用方法
用户可通过Python的Lance库直接加载远程数据集(如lance.dataset('hf://.../train.lance')),并调用count_rows()、schema等基础方法。具体操作包括:利用full_text_query参数对描述文本执行关键词检索(例如查找'red sports car'),或借助nearest参数对image_emb进行k近邻搜索(如取参考样本的嵌入后返回前5个相似项)。所有查询均可指定返回列,支持与PyArrow表格的无缝互操作。
背景与挑战
背景概述
斯坦福汽车数据集(Stanford Cars)由斯坦福大学视觉实验室的Jonathan Krause、Michael Stark、Jia Deng和Li Fei-Fei等人于2013年创建,旨在推动细粒度视觉分类领域的发展。该数据集包含196类汽车品牌、型号及年份的8,144张训练图像,聚焦于对视觉上高度相似的汽车类别进行精确区分,为细粒度图像识别提供了标准化的评估基准。其在计算机视觉领域影响深远,成为衡量细粒度分类算法性能的核心数据集之一。本版本(stanford-cars-lance)由Multimodal-Fatima团队以Lance格式转化,并整合了OpenCLIP嵌入、BLIP生成描述和预建索引,显著增强了数据集的实用性和检索效率。
当前挑战
该数据集面临的核心挑战在于细粒度图像分类的固有难度:不同汽车类别间视觉差异极其细微,例如同一品牌不同年份的车型,要求模型捕捉局部特征(如车灯、格栅形状)的细微变化。构建过程中,原始数据依赖人工标注,确保196个细分类别的精确性耗时费力,且需平衡类间样本不均衡问题。转化至Lance格式时,需高效处理JPEG图像、BLIP描述和512维CLIP嵌入的异构存储,并构建IVF_PQ、FTS和BTREE多类型索引,以支持快速相似性搜索和文本检索,这对数据格式设计和计算资源提出较高要求。
常用场景
经典使用场景
在细粒度图像识别领域,斯坦福汽车数据集(Stanford Cars)一直被视为评估模型对类间细微差异感知能力的标杆。其Lance格式版本通过将原始JPEG图像与OpenCLIP ViT-B-32预提取的512维余弦归一化嵌入向量打包存储,使得研究者无需重复计算视觉特征即可直接开展实验。该数据集最经典的使用场景是作为细粒度分类任务的基准测试平台——利用其196个汽车品牌、车型及年份类别,训练或评估卷积神经网络与视觉Transformer在区分仅有微小造型差异的汽车图像上的表现,例如区分2012款宝马M3双门轿跑与2012款宝马M3敞篷跑车。
解决学术问题
该数据集精准回应了计算机视觉中长期存在的挑战:如何让模型在粗粒度分类任务之外,掌握对局部细节的敏感性。在斯坦福汽车数据集问世前,学术界缺乏一个兼具规模与难度、专注于单一超类下子类别判定的标准测试集。它有效推动了细粒度视觉识别(FGVC)子领域的发展,促使研究者设计出更具判别力的注意力机制、部位定位算法和度量学习策略。通过提供标注明确的类别标签与BLIP自动生成的图像描述,该数据集还支撑了零样本分类、跨模态检索等前沿课题的量化评估,成为连接视觉表征学习与语言模型理解之间的关键枢纽。
衍生相关工作
斯坦福汽车数据集催生了多条重要的学术衍生脉络。在方法层面,它直接激发了DenseNet、双线性网络(Bilinear CNNs)等为捕捉局部判别性特征而设计的架构;在基准体系上,它与其他细粒度数据集(如CUB-200-2011鸟类数据集)共同构成了FGVC挑战赛的核心评测集合,后续的细粒度视觉分类竞赛几乎均以该数据集作为测试磨损性能的基准。此外,针对该数据集的开放环境评估还衍生出关于领域偏移、模型校准和分布外检测的研究课题。近年来,基于其BLIP描述与视觉嵌入的双模态特性,研究人员进一步利用其检验了图文对比学习(如CLIP)和图像检索系统中精细语义对齐的有效性。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

