
Data-Gouv-FR/auteurs-et-autrices-dans-les-annales-de-lepreuve-de-francais-du-diplome-national-du-brevet-1
收藏数据链接:
官方服务:
资源简介:
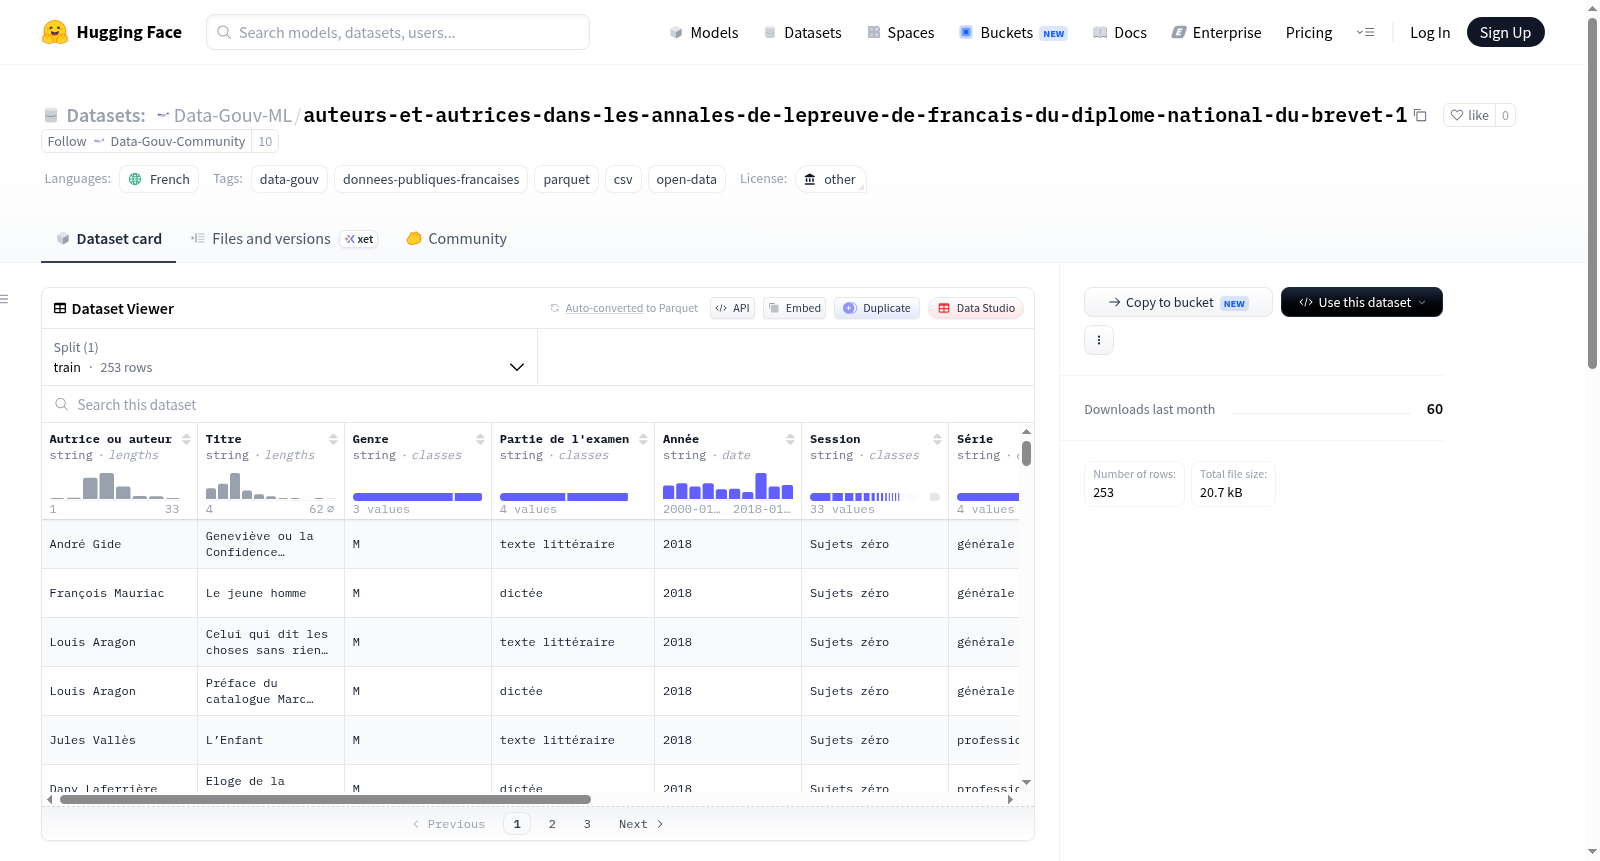
该数据集记录了法国国家文凭(Brevet)法语考试中文本摘录的作者信息,并提供了包含这些作者的考试题目的链接。
Ce jeu de données recense les auteurs et autrices des extraits de textes proposés dans les épreuves de français du diplôme national du brevet, en fournissant un lien vers les sujets qui les contiennent.
提供机构:
Data-Gouv-FR搜集汇总
数据集介绍
构建方式
该数据集旨在系统性地收录法国国家初中毕业会考(DNB)法语科目试题中所引用的文学作品片段作者信息,并附注对应试题的访问链接。其构建依托法国官方开放数据平台data.gouv.fr,属于公共数据资源在机器学习领域的延伸应用。原始数据以表格形式呈现,在Hugging Face平台上转化为单一配置的子集,并统一划分至名为'train'的分割集,存储格式为Parquet,兼顾了数据加载的高效性与兼容性。
特点
数据集的核心特点在于其聚焦于法语教育评测这一特定领域,将标准化考试中的文学引文作者进行结构化整理,为自然语言处理中的作者特征分析、教育数据挖掘等任务提供了独特素材。由于数据源自官方公开信息,并采用CC-BY-SA许可协议,具备合法性与可追溯性。此外,其存储格式简洁,仅包含单一子集与默认训练分割,降低了数据理解的复杂度,便于研究者快速上手。
使用方法
数据集的使用遵循Hugging Face Datasets库的标准流程。用户可通过Python环境中的'load_dataset'函数直接加载指定配置,例如执行'from datasets import load_dataset; ds = load_dataset("Data-Gouv-ML/auteurs-et-autrices-dans-les-annales-de-lepreuve-de-francais-du-diplome-national-du-brevet-1", "auteurs-et-autrices-dans-les-annales-de-l-epreuve-de-francais-du-diplome-national-du-brevet")',即可获取包含唯一'train'分割的数据对象。之后,可通过下标访问'ds["train"]'查看具体数据内容,适用于文本作者分类、考试内容分析等下游研究任务。
背景与挑战
背景概述
该数据集创建于法国公共数据开放平台data.gouv.fr,由Data-Gouv-ML团队整理发布,旨在系统收录法国国家初中毕业会考(diplôme national du brevet)法语科目试题中所引用的文学作品作者信息。核心研究问题聚焦于法语教育考试文本选材的权威性与代表性,通过结构化记录作者身份、作品出处及对应试题链接,为教育政策分析、文学经典传承研究及考试命题规律挖掘提供数据基础。该数据集以CC-BY-SA许可开放共享,对法国教育大数据领域具有里程碑意义,尤其推动了法语语文学与教育测量学的交叉研究范式变革。
当前挑战
在领域问题层面,该数据集需解决法语标准化考试中文学选段作者分布不平衡的隐性偏差,例如经典作家(如莫里哀、维克多·雨果)占比过高与当代女性作家系统性缺失的结构性矛盾。在构建挑战方面,数据采集需跨越数十年间的纸质试卷数字化鸿沟,面临试题版本迭代导致的作者署名格式不一致(如复合姓氏、笔名与真名映射)等历史文献规范化难题;同时需建立跨机构协作机制,以协调法国教育部各地区考试委员会不同时期的档案管理标准,确保作者国籍、生卒年份等元数据的时空一致性校验。
常用场景
经典使用场景
该数据集汇集了法国国家初中毕业会考法语科目历年试题中所引用文本的作者信息,并附有指向对应试题的直接链接。其经典使用场景在于为教育研究者和语言学家提供一个结构化、可量化的语料库,用以分析法国初中阶段法语教学所偏重的文学与思想流派、时代跨度及性别代表性,从而揭示出官方考试在文本选择上的倾向性与演变趋势。
解决学术问题
该数据集有效解决了长久以来法国中等教育研究中一个被忽视的难题:即缺乏一个系统化、标准化的档案来记录官方考试试题文本的源头。它使学者能够定量评估考试内容的多样性,例如追踪女性作者占比随时间的变化,或检测特定历史时期作家被纳入或排除的模式。这些分析对于理解国家教育政策对文化传承与多元化价值观的塑造具有深远意义。
衍生相关工作
基于该数据集,研究者已衍生出若干颇具影响力的工作。例如,结合自然语言处理技术开展历年试题文本的自动主题建模与情感分析,以量化考试风格的嬗变;或利用图论方法构建作者共现网络,揭示不同作家在考试文本中形成的人文对话关系。这些衍生研究不仅深化了对法国教育体系的理解,也为跨学科的数字人文方法提供了示范性案例。
以上内容由遇见数据集搜集并总结生成


