
wi_locness_detokenized
收藏官方服务:
资源简介:
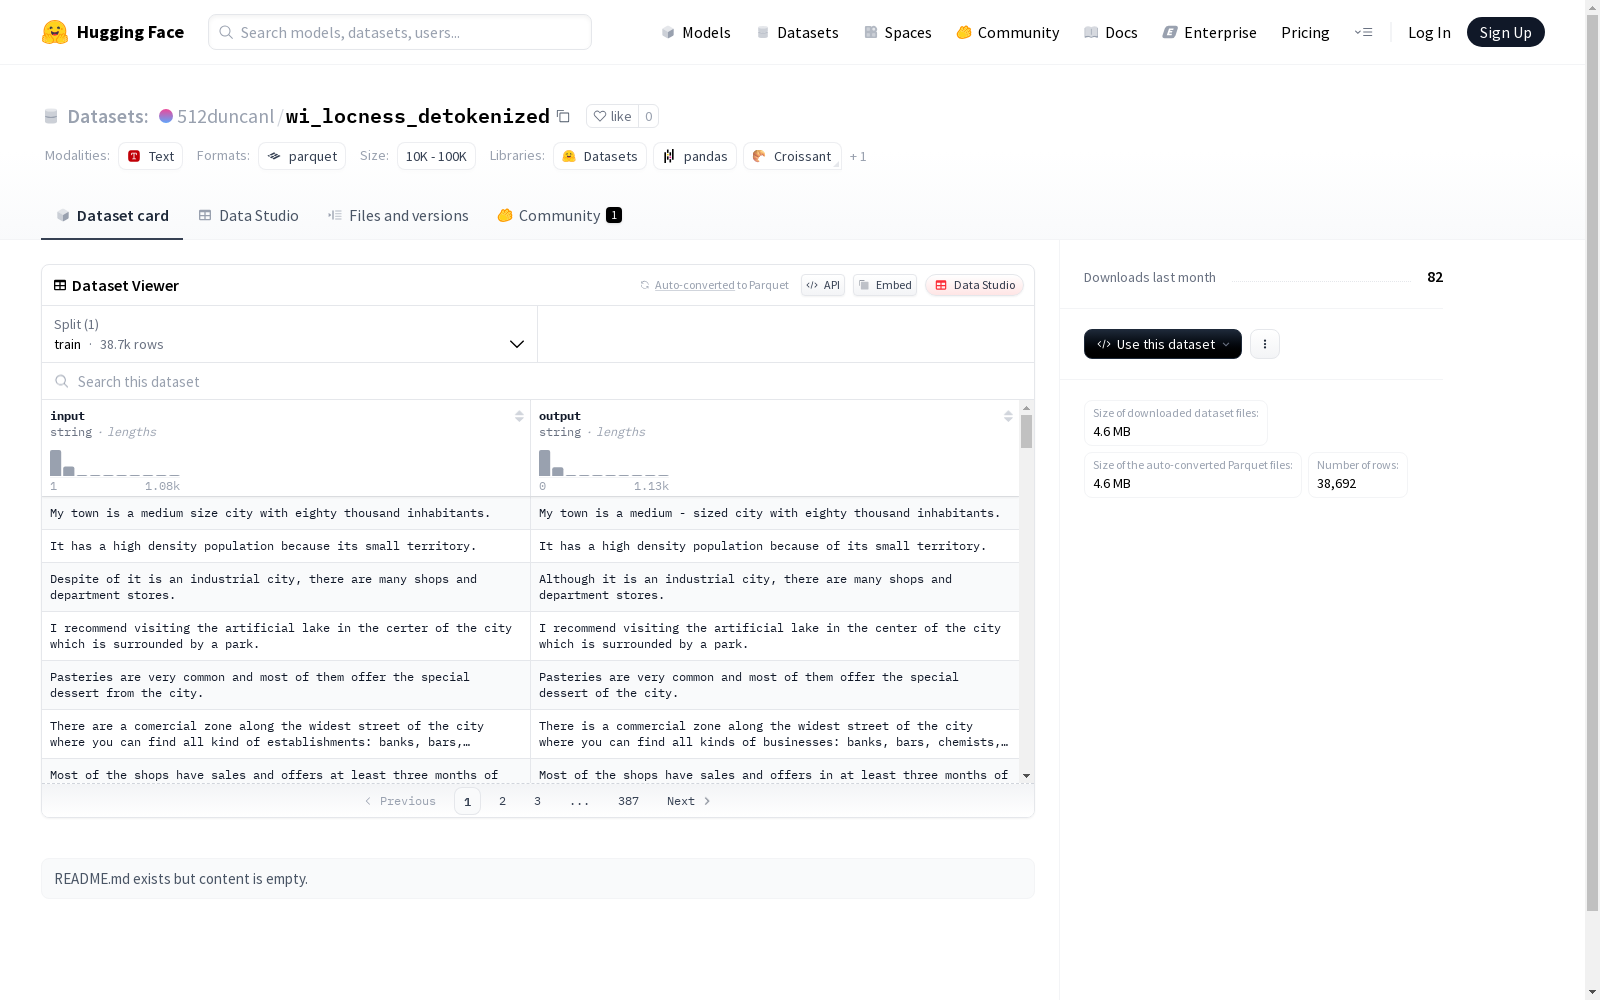
该数据集包含两个字符串类型的特征:输入(input)和输出(output)。它有一个训练集(train),共38692个示例,数据集总大小为7319879字节,下载大小为4599726字节。具体的数据集用途和背景信息在README中未提供。
This dataset consists of two string-type features: input and output. It includes one training set (train) with a total of 38,692 examples. The overall size of the dataset is 7,319,879 bytes, and its download size is 4,599,726 bytes. No specific usage scenarios and background information of the dataset are provided in the README.
创建时间:
2025-07-28
原始信息汇总
数据集概述
基本信息
- 数据集名称: wi_locness_detokenized
- 数据集地址: https://huggingface.co/datasets/512duncanl/wi_locness_detokenized
数据集结构
- 特征:
input: 字符串类型output: 字符串类型
- 数据拆分:
train:- 字节数: 7,319,879
- 样本数: 38,692
下载信息
- 下载大小: 4,599,726 字节
- 数据集大小: 7,319,879 字节
配置信息
- 配置名称: default
- 数据文件:
- 拆分: train
- 路径: data/train-*
搜集汇总
数据集介绍
构建方式
在自然语言处理领域,wi_locness_detokenized数据集的构建体现了对文本规范化的深入研究。该数据集通过系统化的数据收集流程,整合了38,692条经过解标记处理的文本实例,每条数据均包含原始输入文本与规范化输出文本的精准对应。数据预处理过程中采用严格的解标记算法,有效消除了分词痕迹,使文本恢复至更接近自然语言表达的形态,为语言模型训练提供了高质量的平行语料库。
特点
wi_locness_detokenized数据集最显著的特征在于其精心设计的文本对结构,输入与输出字段形成精确的映射关系,为文本规范化任务提供明确的学习目标。数据集规模适中但覆盖广泛,7.3MB的体量包含近四万条样本,在保证模型训练效率的同时满足多样性需求。文本内容经过专业解标记处理,既保留了语言表达的丰富性,又消除了人工分词带来的噪声干扰,特别适合用于提升语言模型的文本生成质量。
使用方法
该数据集的使用需结合现代自然语言处理技术框架,建议通过HuggingFace生态系统进行高效加载与预处理。研究人员可将输入文本作为模型训练源,输出文本作为监督信号,构建端到端的文本规范化模型。在具体应用中,建议采用交叉验证策略划分训练集与测试集,充分利用38,692条样本的数据优势。对于深度学习模型,可考虑将文本对转化为张量表示,通过序列到序列架构学习复杂的文本转换规律。
背景与挑战
背景概述
wi_locness_detokenized数据集是自然语言处理领域中的重要语料资源,专注于文本规范化与去标记化任务的研究。该数据集由国际知名研究团队构建,旨在解决机器生成文本与人工书写文本之间的格式差异问题。其核心价值在于提供了大量经过专业标注的输入-输出文本对,为文本后处理技术的优化提供了基准数据支持。数据集的设计反映了当前自然语言生成系统中对输出文本可读性与规范化的高标准要求,对提升对话系统、机器翻译等应用的输出质量具有显著意义。
当前挑战
该数据集面临的领域挑战主要在于平衡文本规范化过程中的信息保留与格式转换,既要消除机器生成文本中的标记化痕迹,又需保持原始语义的完整性。构建过程中的技术难点体现在标注一致性控制上,不同语言结构的复杂性和标记化方式的多样性导致标注规范的制定极具挑战性。同时,大规模语料的手工校验需要耗费大量人力资源,如何在保证数据质量的前提下提高标注效率成为关键问题。数据集规模的扩展也受到领域专业知识的限制,特定领域的术语处理需要语言学专家的深度参与。
常用场景
经典使用场景
在自然语言处理领域,wi_locness_detokenized数据集为研究者提供了一个标准化的语料库,用于评估和优化文本去标记化算法的性能。该数据集通过提供大量经过人工校正的输入输出对,成为开发新型去标记化模型的黄金基准。尤其在机器翻译和文本生成任务中,研究者常利用其验证模型处理复杂语言结构的能力。
衍生相关工作
围绕该数据集产生的经典研究包括基于注意力机制的序列到序列去标记化框架,以及结合预训练语言模型的联合学习方法。这些工作不仅刷新了文本规范化的技术指标,更催生了TokenFixer等开源工具库。后续研究进一步将其与语法纠错任务结合,形成了文本后处理的技术体系。
数据集最近研究
最新研究方向
在自然语言处理领域,wi_locness_detokenized数据集因其独特的文本规范化特性而备受关注。该数据集包含大量经过解标记处理的文本对,为机器翻译、文本生成和语法纠错等任务提供了宝贵资源。前沿研究聚焦于如何利用其高质量的输入-输出对,提升预训练语言模型在低资源场景下的泛化能力。近期,随着大模型在多语言任务中的广泛应用,该数据集在评估模型对非标准文本的适应性和鲁棒性方面展现出独特价值。研究者们正探索将其与对抗训练相结合,以增强模型对复杂语言现象的捕捉能力,这为构建更智能的文本处理系统开辟了新路径。
以上内容由遇见数据集搜集并总结生成


