bitmoe-400m-t-v1
收藏资源简介:
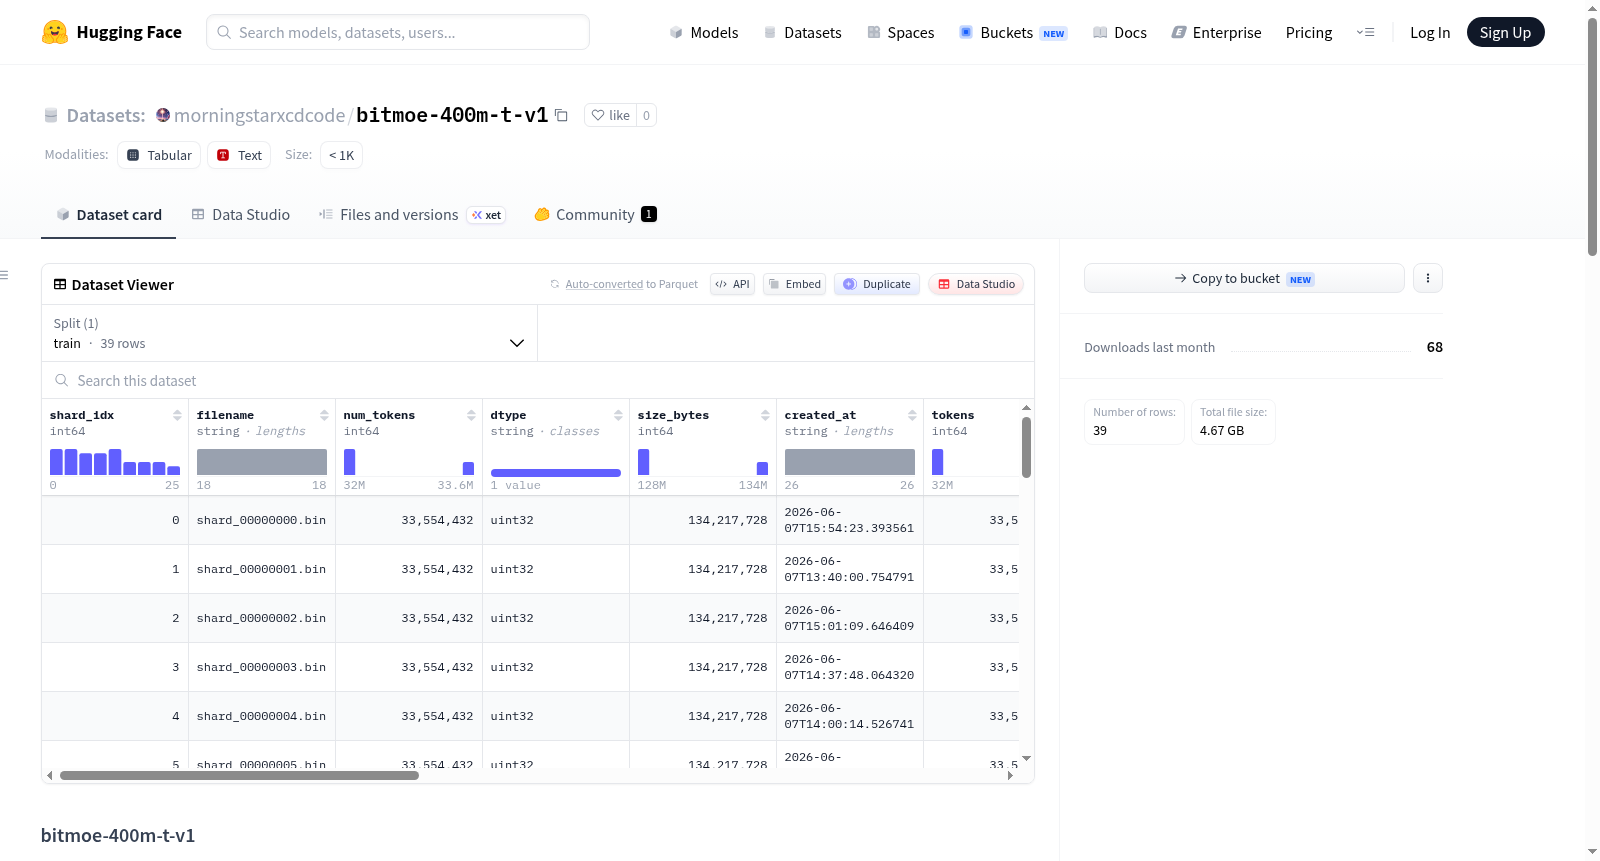
bitmoe-400m-t-v1 是一个专为 BitMoE-400M-T 模型设计的文本分词器预训练语料库。数据集以分片形式组织,每个分片包含 33554432 个 uint32 类型的 token ID,原始数据存储在二进制文件(.bin)中,并配有详细的 JSON 元数据侧文件(.meta.json)。元数据包含 18 个字段,详细记录了每个分片的信息,包括分片索引、文件名、token 数量、创建时间、质量分数统计(平均分、最小分、最大分、标准差)、分数直方图(0.0 至 10.0,步长 0.5)、模态组成(纯文本)以及支柱来源组成(如 fineweb-edu、wikipedia、c4 等)。数据集通过 Azure D4s_v3 虚拟机上的 bitmoe_miner.py 脚本生成,并遵循 Apache-2.0 许可证。该数据集适用于大规模语言模型的预训练任务,特别是需要高质量、结构化文本 token 序列的场景。
bitmoe-400m-t-v1 is a text tokenizer pre-training corpus specifically designed for the BitMoE-400M-T model. The dataset is organized in shards, with each shard containing 33554432 uint32-type token IDs. Raw data is stored in binary files with the .bin extension, accompanied by detailed JSON metadata sidecar files (.meta.json). The metadata includes 18 fields that comprehensively document information for each shard, including shard index, file name, token count, creation time, quality score statistics (mean, minimum, maximum, standard deviation), score histogram (0.0 to 10.0 with a step size of 0.5), modality composition (plain text), and pillar source composition (e.g., fineweb-edu, wikipedia, c4, etc.). The dataset was generated using the bitmoe_miner.py script on an Azure D4s_v3 virtual machine, and is licensed under the Apache-2.0 license. This dataset is suitable for pre-training tasks of large-scale language models, particularly scenarios requiring high-quality, structured text token sequences.
数据集概述:BitMoE-400M-T 文本分词器预训练语料库
该数据集是专为 BitMoE-400M-T 模型设计的文本分词器预训练语料库,包含大量预处理后的 Token ID 数据分片及相关元数据。
数据集结构
数据集由两种主要文件组成,位于 data/shards/ 和 state/ 目录下:
| 路径 | 格式 | 说明 |
|---|---|---|
data/shards/shard_*.bin |
uint32 小端序,128 MiB |
原始 Token ID 数据,每个分片包含 33,554,432 个 Token |
data/shards/shard_*.meta.json |
JSON,18 个字段 | 每个数据分片的侧车元数据文件 |
state/shard_*.meta.json |
JSON,18 个字段 | 与上述 schema 相同,存放较旧的分片 |
state/warp_*.state |
JSON,被查看器忽略 | 矿工恢复检查点,使用不同 schema(6 个字段) |
侧车元数据 Schema
每个 JSON 侧车文件包含 18 个固定顺序和类型的键:
json { "shard_idx": 0, // 分片索引 "filename": "shard_00000000.bin", // 对应 .bin 文件名 "num_tokens": 33554432, // Token 数量 "dtype": "uint32", // 数据类型 "size_bytes": 134217728, // 文件大小(字节) "created_at": "2026-06-07T05:34:11.337884", // ISO 8601 时间戳 "tokens": 33554432, // Token 数量(同 num_tokens) "avg_score": 3.2258, // 平均质量分数 "min_score": 2.5, // 最低质量分数 "max_score": 5.9, // 最高质量分数 "std_score": 0.56, // 质量分数标准差 "n_above_3": 11223, // 分数大于 3 的数量 "n_above_5": 39, // 分数大于 5 的数量 "score_hist": {...}, // 21 个固定区间的分数直方图(0.0 到 10.0,步长 0.5) "modality_comp": {"txt": 33554432}, // 模态组成(全为文本) "pillar_comp": {...}, // 数据源组成(如 fineweb-edu、wikipedia、c4) "ts": 1780810451.34, // Unix 时间戳(浮点数,向后兼容) "modality": "text" // 数据模态 }
关键注意事项:
score_hist必须始终包含完整的 21 个区间键,即使计数为 0,否则查看器无法合并行。created_at必须使用 ISO 8601 字符串格式,不能使用浮点数,否则会破坏所有分片的 schema 推断。
数据来源与生成
- 生成工具:
bitmoe_miner.py脚本,运行在 Azure D4s_v3 虚拟机(Ubuntu 24.04)。 - 数据源:包含 fineweb-edu、wikipedia、c4 等来源。
- 配置:数据源权重和质量阈值在矿工虚拟机的
/opt/bitmoe/config/*.env文件中配置。
验证工具
scripts/verify_viewer.py 脚本用于检查所有侧车文件的 schema 一致性、访问 Croissant 端点,并进行流式 load_dataset 往返测试。矿工虚拟机通过 6 小时 systemd 定时器自动运行此检查。
许可协议
Apache-2.0