
minoruskore/anime-faces-256
收藏官方服务:
资源简介:
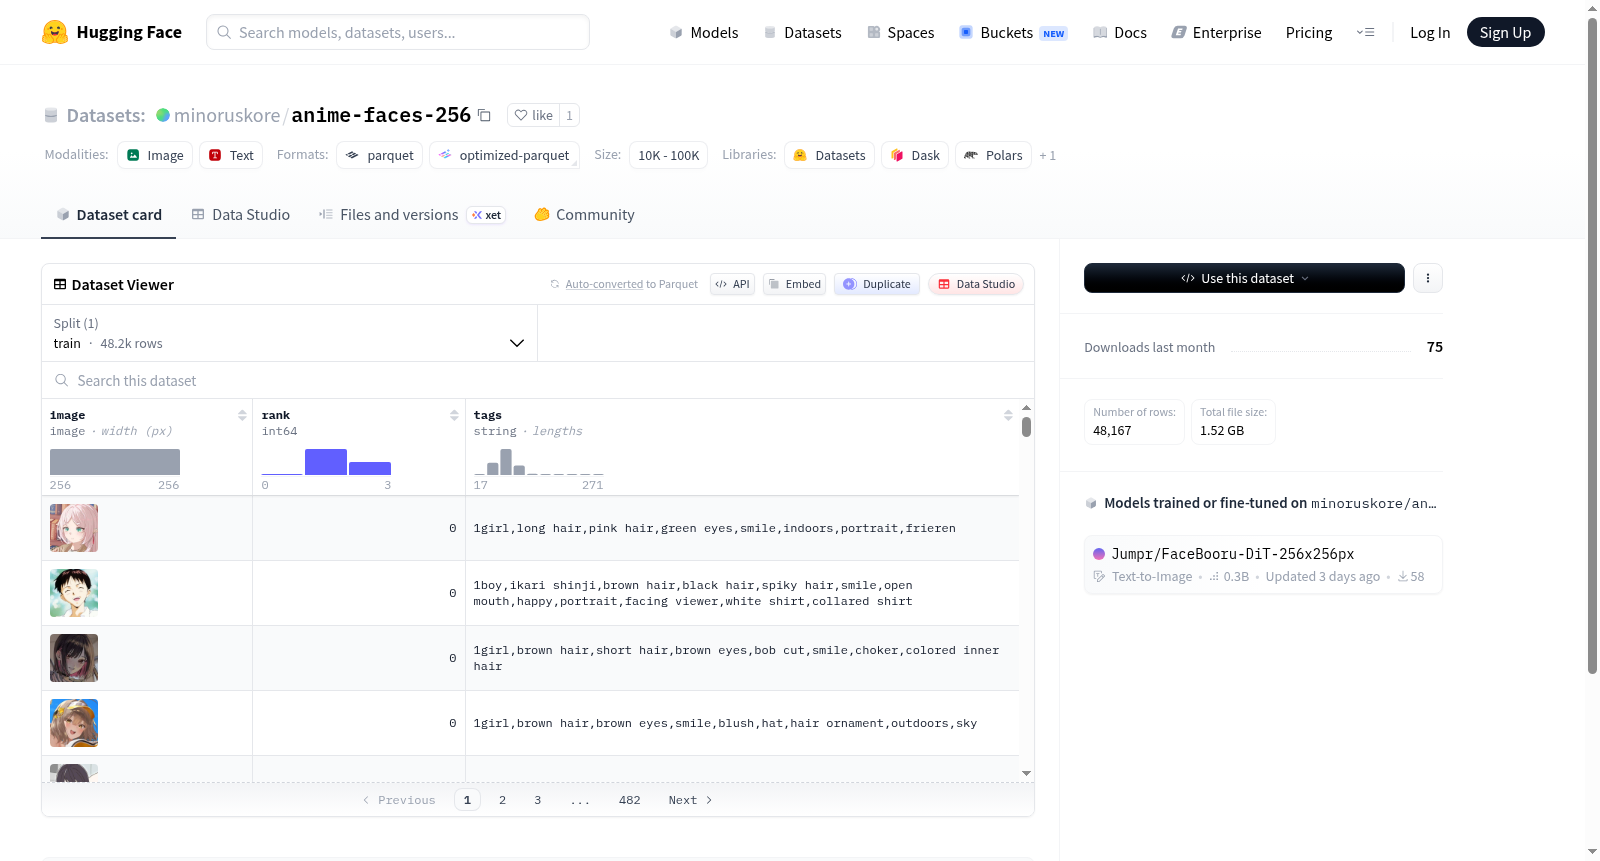
该数据集包含图像、排名和标签三个主要特征。其中图像数据以image格式存储,排名为int64类型,标签为string类型。数据集仅包含训练集,共有48,167个样本,总大小为1,524,520,546字节。
This dataset includes three primary features: images, ranks, and labels. Specifically, the image data is stored in image format, the rank field is of int64 data type, and the label field is of string data type. This dataset only contains a training set, with a total of 48,167 samples and an overall size of 1,524,520,546 bytes.
提供机构:
minoruskore搜集汇总
数据集介绍
构建方式
anime-faces-256数据集专为动漫风格人脸生成与识别任务而构建,其核心设计聚焦于高分辨率与多样性。数据集以256×256像素的统一尺寸采集图像,确保输入数据的规范性。每张图像均附带唯一标识符(rank)及语义标签(tags),其中标签系统覆盖角色属性、表情或服饰等维度,为多标签分类或条件生成提供结构化支持。数据划分仅包含训练集,共48,167个样本,存储格式采用HuggingFace标准化的图像数据类型,便于与现有深度学习框架无缝集成。构建过程中,源数据经过严格预处理,剔除模糊或低质图像,最终形成规模紧凑但语义丰富的专业级人脸数据集。
使用方法
使用该数据集时,可通过HuggingFace Datasets库快速加载,仅需指定`anime-faces-256`名称与`train`划分即可获得可迭代的样本字典。图像字段可直接输入视觉模型,tags字段可作为文本条件参与多模态训练(如CLIP或Stable Diffusion)。rank字段适用于构建有序任务,例如基于排名的人脸生成优先级学习。推荐将数据集与PyTorch或TensorFlow配合使用,利用`set_transform`方法对图像进行随机增强(如翻版、颜色抖动)。若需生成任务,可针对tags设计分词器进行编码;若需分类任务,则可将tags拆解为多热向量(multi-hot encoding)以适配多标签损失函数。整体而言,其接口友好且扩展性高,适配从基础视觉表征到高级生成对抗网络的各类实验场景。
背景与挑战
背景概述
动漫人脸数据集anime-faces-256是在深度学习与计算机视觉交叉领域涌现的专用资源,创建于近年,由开源社区研究人员推动构建。该数据集聚焦于动漫风格人脸图像的生成与理解,核心研究问题在于如何从有限且风格化的动漫图像中学习高质量的人脸特征表达。相较于自然图像数据集,动漫人脸在色彩、线条和纹理上具有高度艺术化特征,对生成模型和判别模型均构成独特挑战。anime-faces-256通过收集48,167张256×256像素的动漫人脸图像,并附加排序标签和文本标注,为风格迁移、图像生成(如GANs、扩散模型)及多模态学习提供了基准。其在动漫图像生成领域的影响力日益显著,成为评估模型对非真实感人脸建模能力的重要参考。
当前挑战
该数据集主要面临三大挑战:首先,在领域问题层面,动漫人脸具有鲜明的艺术风格,其夸张的比例、非写实的配色和简化的细节,使得传统基于自然图像的人脸检测、对齐与生成算法难以直接适用,亟需设计能适应艺术化分布的特征提取与生成方法。其次,构建过程中存在标注主观性强的问题,排序标签(rank)和标签(tags)依赖人工评判,不同标注者对画风偏好和语义理解存在差异,导致标注一致性难以保证。此外,数据来源多样,部分图像可能涉及版权争议,且图像质量参差不齐,模糊或分辨率不足的样本会影响模型训练稳定性,增加了数据清洗和标准化处理的难度。
常用场景
经典使用场景
anime-faces-256数据集的核心用途在于为生成对抗网络(GANs)、变分自编码器(VAEs)以及扩散模型等深度学习架构提供高质量、标准化的训练素材。研究者将其广泛用于人脸图像的生成任务,尤其聚焦于动漫风格面部特征的捕捉与再现。该数据集中的每张图像均经过裁剪与缩放,统一至256×256像素的分辨率,极大简化了预处理流程,便于在条件生成或无条件生成场景下开展对比实验。此外,图像附带的标签与评分信息为多模态学习及条件控制生成提供了天然的监督信号,使得可控的人脸属性编辑、风格迁移等复杂任务得以在标准化的框架下进行系统探索。
解决学术问题
该数据集有效缓解了动漫面部生成研究中长期存在的数据稀缺与标准缺失问题。在学术领域,研究者常因缺乏大规模、统一格式的动漫人脸样本而难以公平评估不同生成模型的性能。anime-faces-256通过提供超过4.8万张经过精心对齐与筛检的面部图像,为定量分析模型的保真度、多样性与收敛速度奠定了可靠基础。它直接推动了动漫风格人脸合成领域的基准测试建立,使得诸如FID(Fréchet Inception Distance)等评价指标在非真实感渲染场景下的适用性得到验证。这一资源的开源共享,促进了生成模型在细分视觉风格上的泛化能力研究,加速了从无条件的纹理生成向可控化的语义合成的范式演进。
实际应用
在实际应用中,anime-faces-256数据集助力动漫与游戏产业的内容创作流程实现自动化升级。它被用于训练角色设计辅助系统,能够根据粗糙的草稿或文本描述自动生成符合特定画风的面部图像,显著缩短了概念原画的迭代周期。在虚拟主播与数字人领域,该数据集支撑了实时面部表情驱动与风格一致的匿名化身生成技术,使得低成本、高效率的虚拟角色定制成为可能。此外,在图像修复与超分辨率等下游任务中,基于该数据集训练的模型展现出对动漫笔触特有的边缘与色彩分布的出色理解,被集成于各类大众化的绘画辅助软件中,为业余爱好者与专业画师提供了智能化的创作工具。
数据集最近研究
最新研究方向
anime-faces-256数据集作为二次元面部图像的标准基准,正引领着生成式模型与风格迁移领域的精细化研究。当前前沿方向聚焦于利用该数据集训练高保真度的GAN与扩散模型,以生成具有丰富表情与多样标签的动漫肖像,推动角色原画自动化创作。同时,结合多标签分类与注意力机制,研究者正探索从标签语义到面部特征的细粒度映射,显著提升图像编辑与风格一致性的可控性,为虚拟偶像与数字娱乐产业注入创新活力。
以上内容由遇见数据集搜集并总结生成


