
ViSA_LlavaOV_700K
收藏官方服务:
资源简介:
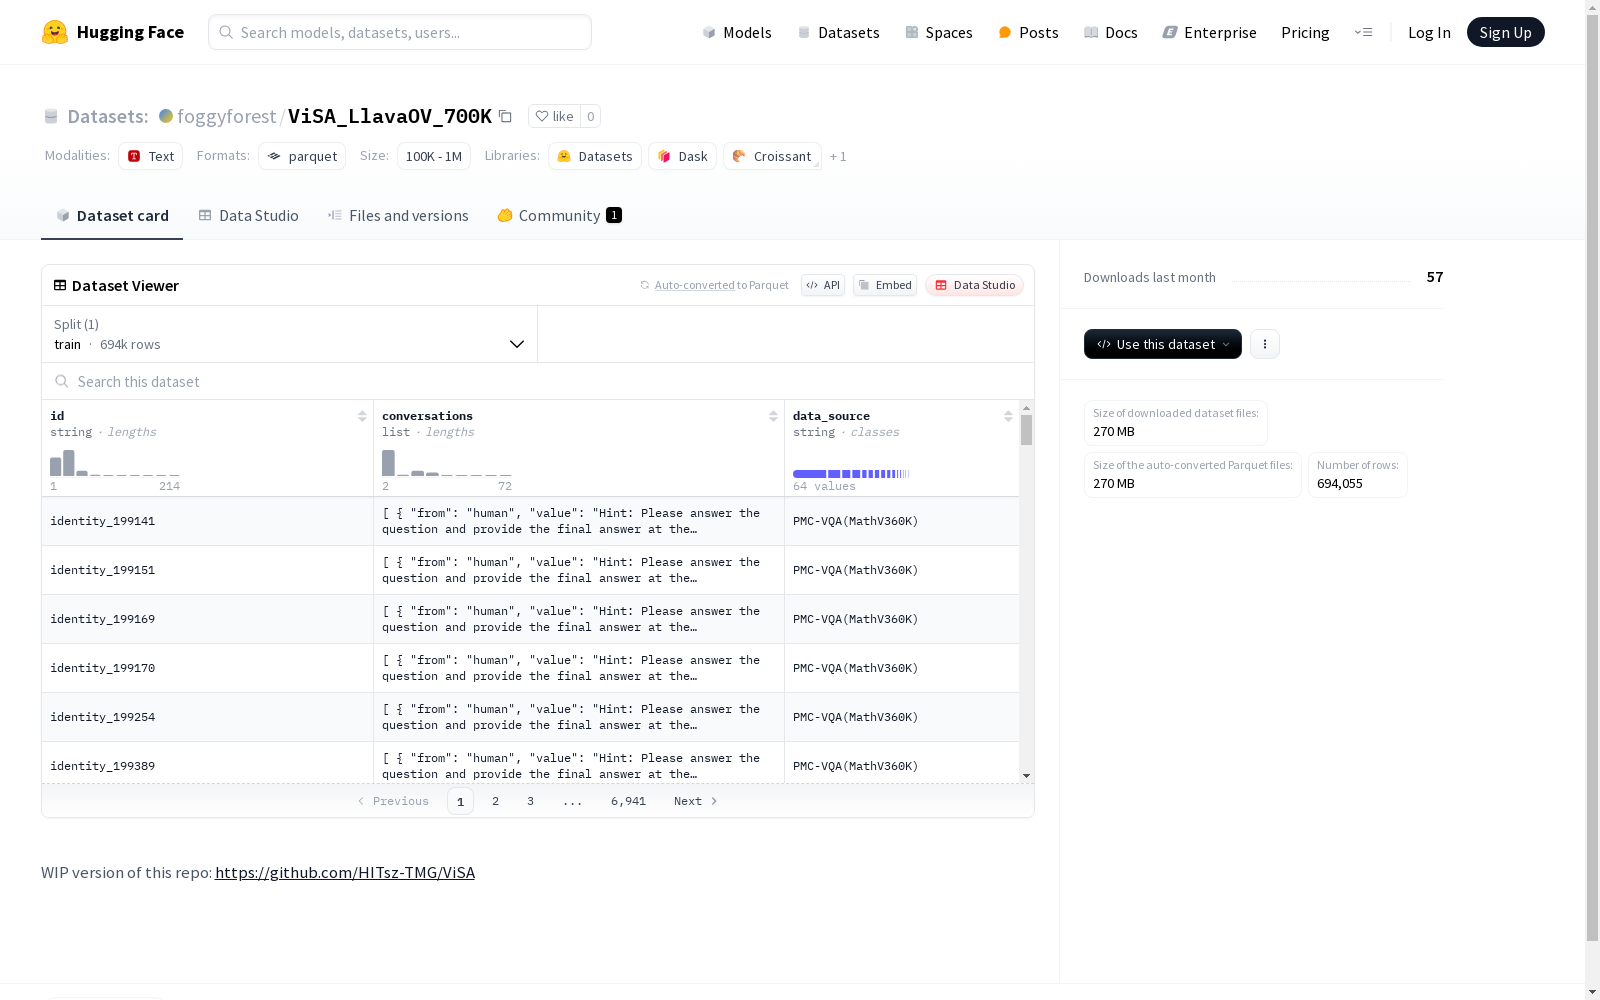
该数据集包含了用户对话信息,每个对话记录包括发送者id和对话内容,以及数据来源。数据集分为训练集,可用于对话系统的训练等NLP任务。
This dataset contains user conversation information, where each conversation record includes the sender ID, conversation content, and data source. The dataset is divided into training subsets and can be used for NLP tasks such as dialogue system training.
创建时间:
2025-03-21
搜集汇总
数据集介绍
构建方式
ViSA_LlavaOV_700K数据集的构建依托于多模态学习的前沿技术,通过整合视觉与语言模态的交互信息,形成了规模庞大的对话数据集。该数据集包含近70万条样本,每条样本均以结构化的对话形式呈现,涵盖了丰富的视觉场景和语言描述。数据来源经过严格筛选和标注,确保了内容的多样性和准确性,为多模态研究提供了坚实的基础。
特点
ViSA_LlavaOV_700K数据集以其大规模和多模态特性脱颖而出,每条样本均包含视觉与语言的双重信息,适用于视觉问答、对话生成等任务。数据集中的对话内容涵盖了广泛的场景和主题,具有高度的多样性和复杂性。其结构化设计便于模型直接处理,为研究者提供了高效的数据支持。
使用方法
使用ViSA_LlavaOV_700K数据集时,研究者可通过HuggingFace平台直接下载并加载数据,数据集以标准的JSON格式存储,便于集成到各类深度学习框架中。每条样本包含唯一的ID、对话内容及数据来源标识,支持多模态模型的训练与评估。数据集的设计兼顾了灵活性与易用性,可广泛应用于视觉语言联合建模的研究。
背景与挑战
背景概述
ViSA_LlavaOV_700K数据集是近年来多模态学习领域的重要资源,由哈尔滨工业大学(深圳)的TMG团队于2023年构建。该数据集聚焦于视觉与语言的跨模态理解,旨在推动视觉问答(VQA)和视觉对话系统的研究。作为Llava框架的扩展,其核心研究问题在于解决复杂场景下视觉信息与自然语言交互的语义对齐难题。通过提供近70万条高质量的对话样本,该数据集显著提升了模型对开放世界视觉概念的泛化能力,为多模态大语言模型的训练设立了新基准。
当前挑战
构建ViSA_LlavaOV_700K面临双重挑战:在领域问题层面,开放域视觉问答需要克服细粒度视觉特征与多样化语言表达间的语义鸿沟,特别是处理隐含语义和主观性提问时的模型鲁棒性问题;在数据构建过程中,团队需解决大规模多轮对话标注的复杂度,包括视觉焦点切换的连贯性保持、跨模态噪声过滤,以及对话逻辑的时空一致性验证。此外,平衡数据多样性与标注质量的关系,避免引入文化偏见和语义歧义,也是数据集构建的关键难点。
常用场景
经典使用场景
在视觉与语言交叉研究领域,ViSA_LlavaOV_700K数据集以其丰富的对话式标注成为多模态理解的基准测试平台。该数据集通过69万条结构化对话样本,为视觉问答、图像描述生成等任务提供了标准化评估框架,研究者可基于对话序列分析模型对视觉内容的语义捕捉能力。
实际应用
在智能客服与辅助系统领域,该数据集支撑了具身智能体的环境交互能力训练。基于对话记录的视觉场景理解模块可应用于盲人导航、工业质检等场景,其大规模样本覆盖了复杂环境下的多轮对话需求,显著提升了系统在开放域中的鲁棒性表现。
衍生相关工作
该数据集的发布催生了系列创新研究,如基于对话历史的视觉注意力预测模型、多模态对话状态跟踪系统等。GitHub开源项目ViSA围绕该数据集构建了扩展工具链,包括视觉语义对齐评估协议和增量式对话标注平台,形成了完整的生态体系。
以上内容由遇见数据集搜集并总结生成


