
遇见数据集

biglam/londons-pulse-moh

收藏
Hugging Face2026-06-03 更新2026-06-14 收录
官方服务:

资源简介:

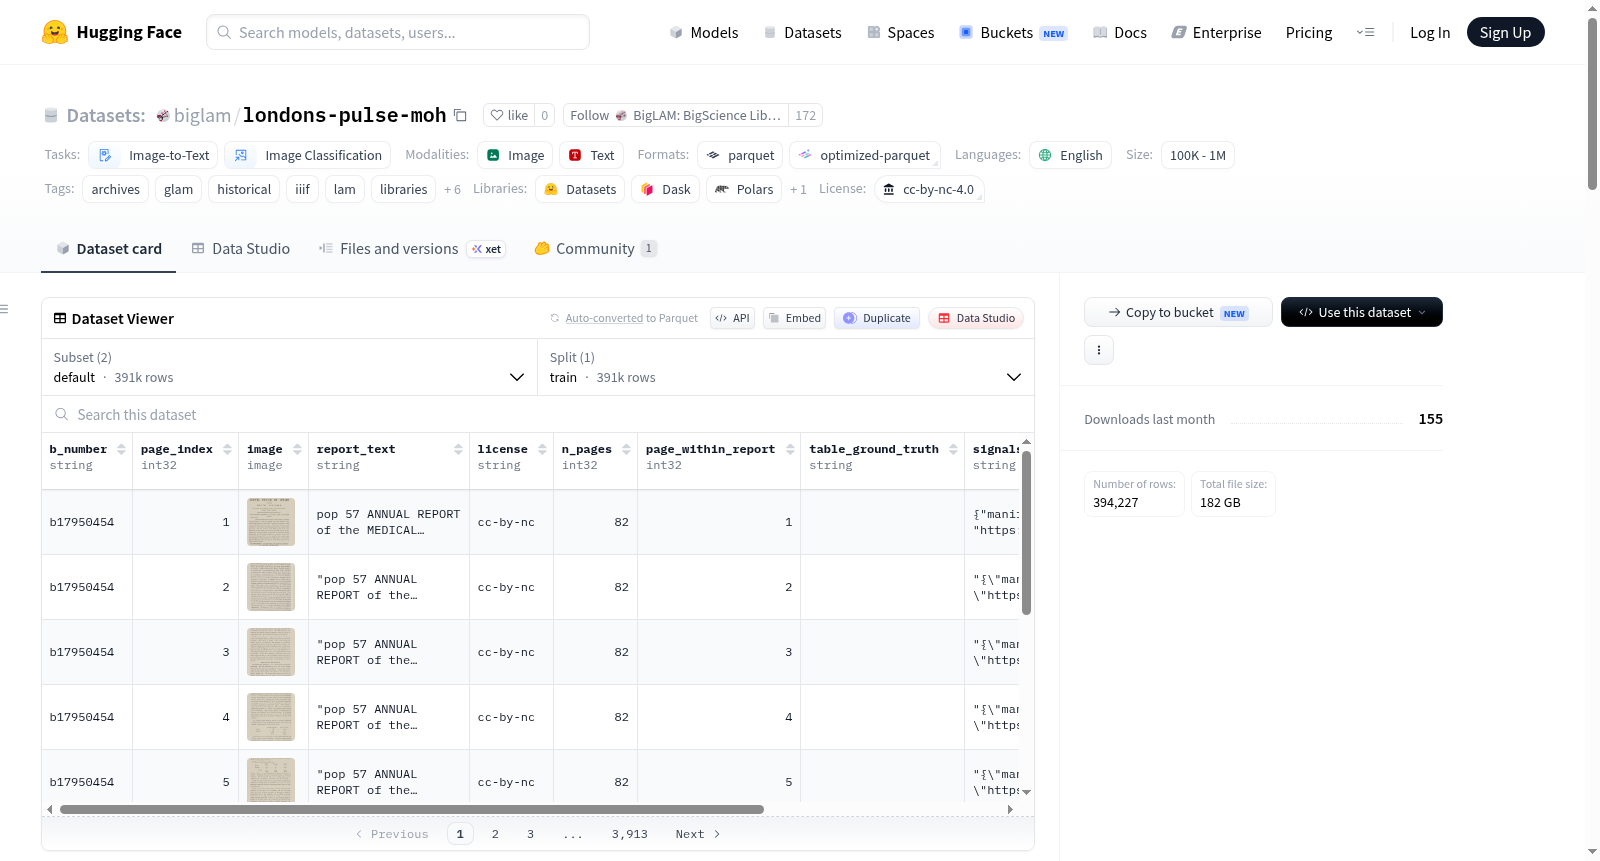
该数据集名为伦敦脉搏:卫生官员报告(页面图像 + OCR文本),包含1848年至1972年伦敦卫生官员(MOH)报告的页面扫描图像和OCR文本。它提供两个配置:default配置包含391,964个页面图像及其对应报告的OCR文本,适用于OCR、视觉语言模型(VLM)和文档理解任务;tables配置包含3,000个包含表格的页面,每个页面提供图像和机器提取的表格真值,用于页面类型分类训练和OCR/VLM表格提取评估。数据集具有历史档案和公共卫生背景,涵盖密集统计表格和混合布局,图像使用CC-BY-NC 4.0许可证,文本和表格使用CC-BY 4.0许可证。

This dataset is named London Pulse: Medical Officer of Health Reports (Page Images + OCR Text). It includes scanned page images and OCR text extracted from London's Medical Officer of Health (MOH) reports spanning 1848 to 1972. The dataset provides two configurations: 1. The default configuration contains 391,964 page images paired with the corresponding OCR text of their reports, which is applicable to OCR, vision-language model (VLM) and document understanding tasks; 2. The tables configuration includes 3,000 pages containing tables, with each page providing both the page image and machine-extracted table ground truth, intended for page type classification training and OCR/VLM table extraction evaluation. This dataset carries historical archival and public health research contexts, covering dense statistical tables and mixed layouts. The page images are licensed under CC-BY-NC 4.0, while the text and table data are licensed under CC-BY 4.0.
提供机构:
biglam
搜集汇总
数据集介绍
biglam/londons-pulse-moh 数据集图片
构建方式
伦敦脉搏数据集源自威尔康图书馆数字化馆藏,系统收录了1848至1972年间伦敦卫生官员报告的页面扫描图像与OCR文本。其构建遵循严格的数据溯源原则:图像通过IIIF Presentation v2 API获取,保留原生分辨率;文本则整合自该馆发布的完整语料库。特别值得注意的是,数据集提供了两种配置——默认配置包含近40万页完整报告,而表格配置则精心筛选了3000个包含统计表格的页面,并配以机器提取的结构化表格真值。所有数据按报告级别进行分组,确保训练、验证和测试集之间不存在页面泄露。
特点
该数据集最显著的特点在于其历史档案的真实性与双重用途设计。近40万页扫描图像覆盖12个年代,真实再现了世纪之交公共卫生报告的复杂版面——密集的统计表格、混合版式与古旧印刷字体并存。表格配置尤为独特,每个页面不仅标注了表格数量,还提供了JSON格式的CSV表格真值,使其既可训练页面类型分类器,又能作为视觉语言模型的表格提取基准。需要注意的是,表格真值为机器自动提取的银标准而非人工校对的金标准,数值内容高度准确,但文字标签偶有OCR噪声。
使用方法
使用该数据集时,研究者可通过HuggingFace的datasets库便捷加载。默认配置支持流式加载以应对约110GB的庞大体量,适合训练OCR与文档理解模型。表格配置则更轻量,可直接用于图像到结构化表格的提取任务评估。实践中,由于OCR文本仅在报告级别提供而非按页对齐,建议按b_number字段进行分组去重。对于追求高精度的研究,推荐在表格真值基础上构建小规模人工校正的金标准子集,以获取更可靠的评估结果。
背景与挑战
背景概述
由Wellcome Collection团队创建的London's Pulse: MOH Reports数据集,收录了1848至1972年间伦敦卫生官员报告的页面级扫描图像与OCR文本,共计近40万页、4886份报告。该数据集聚焦于历史公共卫生档案的数字化理解,核心研究问题在于如何利用视觉语言模型与光学字符识别技术,从复杂统计表格与混合排版中提取结构化信息。作为文化遗产与医疗史研究的重要资源,它填补了历史文档领域在密集表格数据上的空白,推动了对近两个世纪公共卫生演变的数据化分析。
当前挑战
该数据集面临的首要挑战在于所解决的领域问题:历史表格的自动提取,尤其是处理百年印刷品中的噪声、多样排版与非标准符号。构建过程中遭遇的挑战颇具代表性:OCR文本源自整份报告而非按页对齐,导致页面与文本的映射关系断裂;表格真值仅由机器提取,虽数值准确但文本标签常有OCR错误(如'classes'误为'olasses'),标题扁平化且空单元格标记不一,形成银标准而非金标准,要求评估时采用模糊匹配策略。此外,数据集的非商业许可限制了其广泛应用场景。
常用场景
经典使用场景
《伦敦脉搏:卫生官员报告(页面图像与OCR文本)》数据集汇聚了1848年至1972年间伦敦卫生官员的原始报告页面扫描图像及配套OCR文本,共计39万余页。其经典使用场景聚焦于历史文献的数字化理解与信息抽取,尤其是针对百年间密集统计表格、混合布局与古旧排印字体。研究者可借助该数据集开展视觉语言模型(VLM)在真实历史公共健康档案上的性能评估,以及文档版面分析、页面类型分类等任务,为处理非标准、低质量历史印刷品提供坚实的基准资源。
解决学术问题
该数据集系统性地填补了历史公共健康档案数字化研究的两个关键空白:一是大规模、跨年代的真实页面图像与结构化的表格提取标注(银标准)的结合,二是为OCR与VLM表格抽取任务提供了可量化评估的测试平台。学术上,它有效解决了历史文献中密集数值型表格难以自动解析的难题,使得疾病发病率、死亡率等时序统计数据的规模化提取成为可能。其影响在于推动了将古老文档转化为可计算数据结构的方法论进步,为计算历史学、数字人文学及公共卫生史研究开辟了新的实证路径。
衍生相关工作
该数据集衍生了一系列经典工作,主要集中在历史文档理解与信息抽取的方法创新上。相关研究包括利用端到端视觉语言模型直接对历史页面图像进行表格到文本的生成,对比传统流水线方法与联合模型的优劣;以及构建基于该数据集的版面分割与页面分类基准,推动低资源历史文档场景下的迁移学习与弱监督学习技术。此外,还有工作在此基础上引入了人工修正的金标准子集,用于量化银标准标注的噪声边界,进而提出更鲁棒的评估协议。这些衍生工作共同构成了历史文档数字化领域一个活跃的研究生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

