
correll/semanticsegmentationandposeestimationfromrgbd
收藏官方服务:
资源简介:
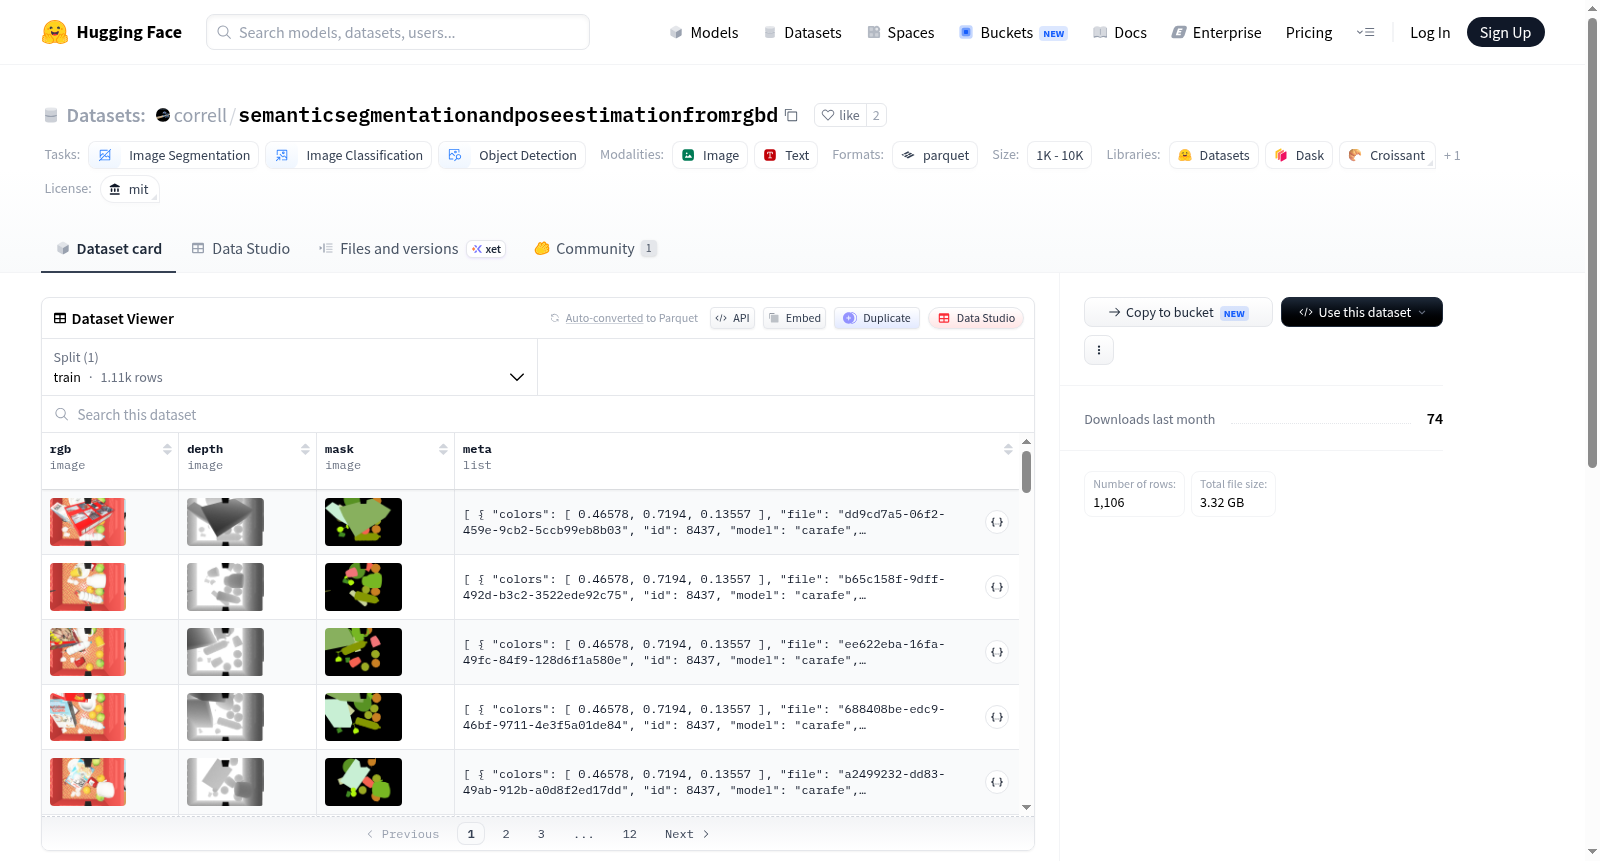
这是一个用于实例分割(从RGB或深度图像)和单个物体姿态估计的RGB-D数据集。数据是通过在Webots中随机化箱子内容生成的。每个实例包含一个掩码图像以及包含标签、位置和每个对象大小的元数据。用户可以通过在Webots中打开webots_grasp.wbt文件来创建自己的数据。
这是一个用于实例分割(从RGB或深度图像)和单个物体姿态估计的RGB-D数据集。数据是通过在Webots中随机化箱子内容生成的。每个实例包含一个掩码图像以及包含标签、位置和每个对象大小的元数据。用户可以通过在Webots中打开webots_grasp.wbt文件来创建自己的数据。
提供机构:
correll原始信息汇总
数据集概述
数据集名称
Semantic segmenation and pose estimation from RGB-D
许可
MIT
任务类别
- 图像分割
- 图像分类
- 目标检测
数据集特征
- rgb: 图像类型
- depth: 图像类型
- mask: 图像类型
- meta: 列表类型,包含以下子特征:
- colors: 序列类型,float64
- file: 字符串类型
- id: 整数类型,int64
- model: 字符串类型
- numberOfColors: 整数类型,int64
- orientation: 序列类型,float64
- position: 序列类型,float64
- positionOnImage: 序列类型,int64
- size: 序列类型,float64
- sizeOnImage: 序列类型,int64
数据集分割
- train:
- 字节数: 3340733260.96
- 样本数: 1106
数据集大小
- 下载大小: 3319212411
- 数据集大小: 3340733260.96
配置
- default:
- 数据文件路径: data/train-*
搜集汇总
数据集介绍
构建方式
在计算机视觉与机器人感知领域,RGB-D数据驱动的语义分割与姿态估计是理解三维场景的关键技术。该数据集基于Webots仿真环境,通过随机化料箱内物体的摆放位置与朝向生成多样化的训练样本。每个数据实例包含RGB图像、深度图像以及对应的实例分割掩码图像,同时附有详尽的元数据,涵盖每个物体的类别标签、三维空间位置、尺寸、颜色信息、图像平面坐标及物体朝向等属性。这种自动化生成策略确保了数据的高效性与场景的丰富性,为算法在复杂工业分拣场景中的泛化能力提供了基础支撑。
特点
该数据集的核心特色在于其多模态与多任务协同设计。数据同时提供RGB与深度两种模态,支持从单一模态或融合模态进行实例分割,并进一步实现个体物体的六自由度姿态估计。元数据中包含了物体的颜色直方图、模型名称、图像内位置与尺寸等细粒度信息,这使得模型不仅能区分不同物体,还能对同一类别的不同实例进行精确区分。此外,数据集的生成过程引入了随机化机制,模拟了真实工业环境中物体堆叠与遮挡的复杂情况,增强了数据对真实场景的模拟真实度与挑战性。
使用方法
该数据集以Hugging Face Datasets库的标准格式发布,用户可通过加载`correll/semanticsegmentationandposeestimationfromrgbd`配置直接获取训练数据。数据集中仅包含训练划分,共1106个样本,每个样本的RGB、深度及掩码图像以图像格式存储,元数据则以结构化字段组织。用户可依据任务需求,将图像输入分割网络提取掩码,或结合深度信息与元数据中的位置、朝向标签训练姿态估计模型。对于希望扩展数据规模的研究者,数据集提供了基于Webots的仿真世界文件`webots_grasp.wbt`,支持自定义场景参数以生成更多样化的训练实例。
背景与挑战
背景概述
在机器人抓取与操作领域,从RGB-D数据中同时实现实例分割与六自由度位姿估计是赋予智能体环境感知能力的关键技术。该数据集由correll团队于近年创建,依托Webots仿真环境随机化料箱物体布局生成,核心研究问题聚焦于如何利用单一模型从彩色与深度模态中联合推理物体边界与空间姿态。通过提供1106个训练样本,每个样本包含RGB图像、深度图、实例掩码以及标注物体颜色、位置、朝向等元数据,该数据集为验证多任务学习架构在复杂工业场景下的泛化性能提供了标准化基准,推动了视觉感知从分类向空间理解的范式演进。
当前挑战
当前面临的核心挑战在于多模态数据异质性与任务耦合度之间的平衡。从领域问题看,实例分割与位姿估计对特征表征的需求存在冲突:前者依赖边界细节,后者强调全局几何结构,导致共享编码器易产生特征混淆。从构建过程看,仿真数据与真实世界的域间隙显著,Webots生成的理想化光照和纹理难以覆盖真实工业场景中的反射、遮挡与传感器噪声,而人工标注真实RGB-D位姿数据成本高昂。此外,掩码与位姿标注的同步精度不足会引发监督信号矛盾,进一步制约模型在密集堆叠物体环境下的鲁棒性。
常用场景
经典使用场景
在计算机视觉与机器人感知的交叉领域中,RGB-D数据为三维场景理解提供了丰沛的信息源泉。该数据集专为实例分割与位姿估计任务而设计,其经典使用场景涵盖从RGB图像或深度图中精准分离出单个物体,并同步推断其六自由度空间位姿。借助Webots仿真环境随机生成的杂乱箱体内容,数据集模拟了工业分拣与仓储操作中的典型挑战,为评估算法在遮挡、光照变化及物体堆叠条件下的鲁棒性提供了理想基准。
解决学术问题
该数据集直面机器人操作中的核心学术难题:如何在缺乏精确几何先验的情况下,从单帧RGB-D观测中同时实现多实例分割与物体位姿估计。传统方法往往将二者割裂处理,而该数据集的统一标注格式鼓励研究者探索端到端的联合推理范式。其意义在于弥合了感知与操控之间的鸿沟,为构建具身智能体在非结构化环境中的自主抓取能力奠定了数据基础,并推动了从仿真到现实迁移学习的研究进程。
衍生相关工作
该数据集衍生了一系列具有影响力的研究工作,包括基于多模态特征融合的实例分割网络(如RGB-D Mask R-CNN变体)、结合几何约束的位姿回归框架,以及利用仿真到现实迁移的域自适应方法。部分工作进一步探索了自监督学习范式,通过预测物体对称性来增强位姿估计的泛化能力。这些衍生工作不仅在公开榜单上刷新了性能记录,更启发了后续针对动态场景与可变形物体的感知研究,形成了从静态抓取到动态交互操作的技术演进脉络。
以上内容由遇见数据集搜集并总结生成


