
fdvfvdvdvqw/ai-model-fingerprinting-dataset
收藏官方服务:
资源简介:
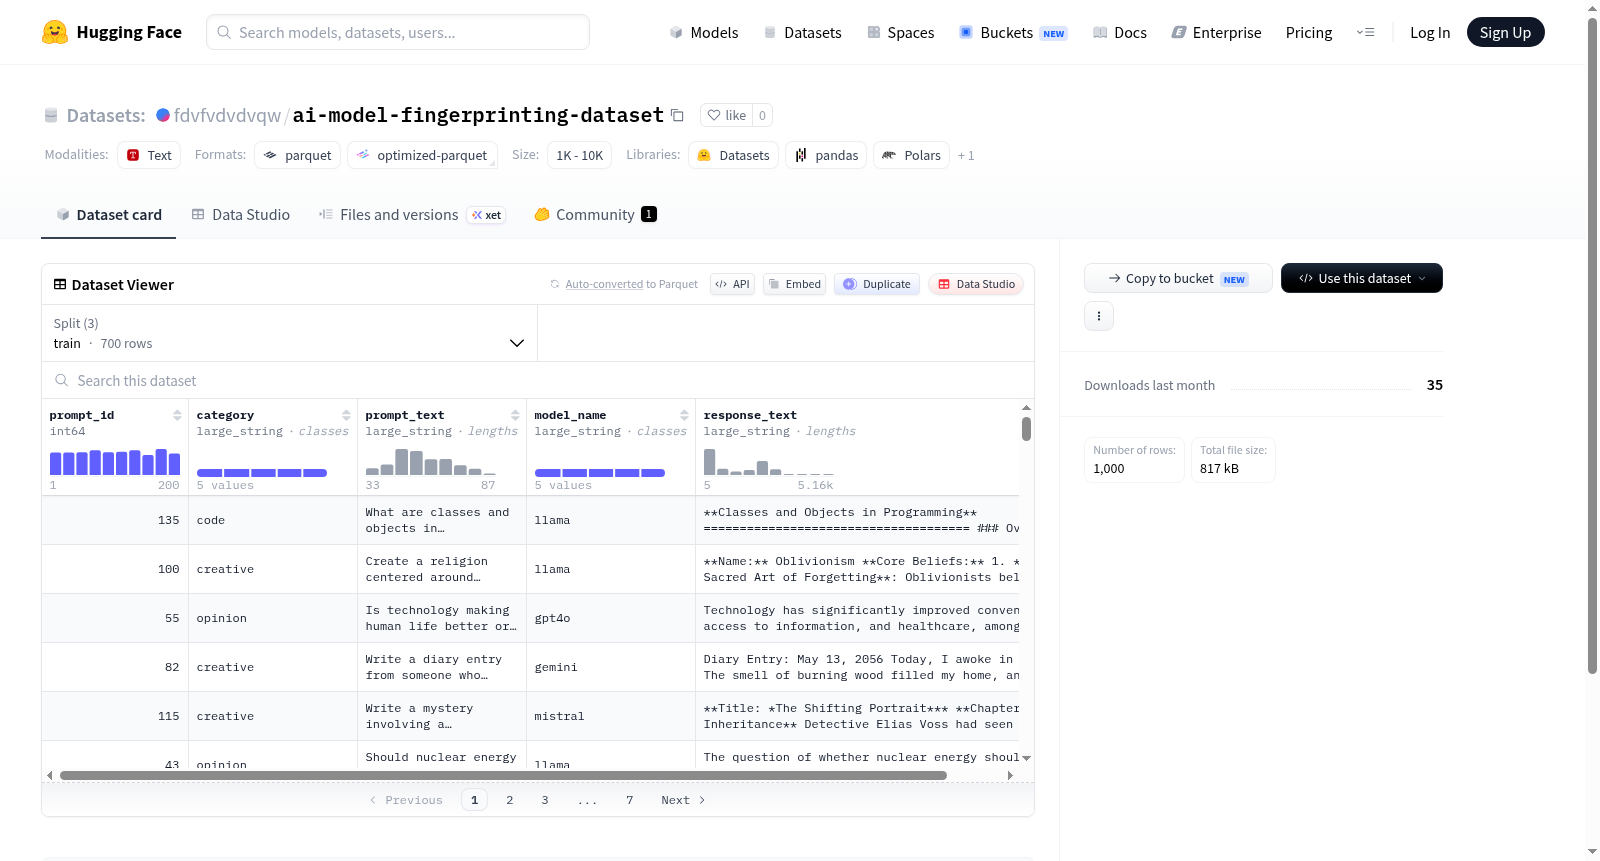
该数据集包含用于语言模型评估或训练的数据,具有700个训练样本、150个验证样本和150个测试样本。每个样本包括提示ID、类别、提示文本、模型名称和响应文本等字段,可用于分析不同模型对提示的响应效果。
This dataset contains data for language model evaluation or training, with 700 training samples, 150 validation samples and 150 test samples. Each sample includes fields such as prompt ID, category, prompt text, model name and response text, which can be used to analyze the response effects of different models to prompts.
提供机构:
fdvfvdvdvqw搜集汇总
数据集介绍
构建方式
该数据集专为人工智能模型指纹识别任务设计,基于精心设计的提示文本与模型响应对进行构建。数据涵盖多种提示类别,每一条记录包含唯一提示标识符、类别标签、完整的提示文本、目标模型名称及其对应的响应文本。数据集被划分为训练、验证和测试三个子集,分别包含700、150和150个样本,确保模型训练与评估的独立性与可靠性。数据以标准化的特征结构存储,便于直接加载与处理。
特点
数据集的核心特点在于其结构化与多维度的信息组织方式。通过将提示文本与模型响应成对收集,并附带模型名称与类别标签,为研究不同模型间的行为差异及指纹识别提供了坚实基础。数据集规模虽紧凑,但覆盖了多个提示类别,能够有效支持分类与对比分析任务。此外,明确的数据划分使得实验复现与性能评估更加可控,适合用于模型溯源与安全性研究。
使用方法
该数据集可通过HuggingFace Datasets库直接加载,使用默认配置即可获取训练、验证与测试分片。各分片数据以parquet格式存储于指定路径,用户可调用`load_dataset`函数快速读取。加载后,数据以字典形式呈现,包含提示ID、类别、提示文本、模型名称与响应文本字段,适合直接用于监督学习或特征提取。建议根据具体任务对类别标签进行预处理,或按模型名称分组进行指纹分析。
背景与挑战
背景概述
随着大语言模型(LLMs)的广泛应用,模型安全与溯源问题日益凸显,不同模型生成的文本在风格、结构和潜在偏差上存在细微差异,这为模型指纹识别技术提供了研究契机。ai-model-fingerprinting-dataset数据集由相关研究团队构建,旨在系统收集不同大语言模型对同一提示词的响应,从而建立一个可用于模型归属分析与指纹识别的标准化基准。该数据集包含700条训练样本、150条验证样本和150条测试样本,每条记录涵盖提示词ID、类别、模型名称及对应响应文本,为多模型响应差异性分析提供了高质量数据支撑。其发布对推动AI模型溯源、版权保护和安全性评估具有重要学术价值,为后续模型指纹识别算法的开发与评测奠定了坚实基础。
当前挑战
该数据集所应对的核心领域挑战在于如何有效区分不同大语言模型生成的文本,即解决模型指纹识别问题。由于现代LLM在训练数据、架构和指令微调上的高度相似性,其输出往往具有重叠的语言模式,使得精准归属分析困难重重。此外,数据收集过程也面临诸多挑战:确保提示词覆盖广泛且无偏以避免模型间差异被噪声掩盖;标注过程中需防止模型训练数据泄露导致误判;不同模型版本更新频繁,数据集的时效性与代表性难以维持;跨模型响应的微小特征差异需要大规模、高质量的配对数据才能被学习,而当前数据量限制了模型指纹识别算法的泛化能力与鲁棒性验证。
常用场景
经典使用场景
在人工智能安全与隐私保护领域,模型指纹识别技术正逐渐成为抵御未经授权模型分发与滥用的关键手段。该数据集专为模型指纹识别任务设计,通过精心构建的提示文本(prompt_text)与对应模型响应(response_text)之间的映射关系,为研究者提供了丰富的实验素材。其经典用途在于训练和评估能够从模型输出中提取独有特征模式的指纹识别模型,从而实现对特定AI模型的精准溯源与身份认证。
衍生相关工作
围绕该数据集,研究者已衍生出多项富有影响力的工作。经典研究方向包括基于输出分布统计特征的不可逆指纹编码方案,以及融合对抗样本微调的高鲁棒性指纹嵌入技术。同时,该数据集催生了关于模型指纹抗模仿攻击能力的评估框架,推动了对抗性后门注入与指纹验证联合设计的新范式。这些工作共同丰富了模型溯源领域的理论体系,并促进了指纹长度与检测精度之间权衡关系的系统性分析。
数据集最近研究
最新研究方向
随着大语言模型在各类应用中的广泛部署,模型指纹识别技术作为保障模型安全与知识产权的重要手段,正受到学术界与工业界的高度关注。ai-model-fingerprinting-dataset专为模型指纹辨识任务设计,汇集了不同提示文本下多个模型的响应输出,为探究模型间的独特表征模式提供了关键资源。当前前沿研究聚焦于利用该数据集开发高效的模型归属与溯源算法,以应对模型窃取、未经授权使用等安全挑战。在生成式人工智能伦理与监管日益严格的背景下,该数据集支持的黑盒指纹分析技术,有助于构建更加透明可信的AI生态系统,其影响已延伸至模型审计、版权保护与合规检测等热点领域。
以上内容由遇见数据集搜集并总结生成


