
AI 模型随机数指纹数据集
收藏官方服务:
资源简介:
通过随机选数字的统计分布指纹,区分/检测17个AI模型的数据集,包含原始响应与相似度分析,采集自OpenRouter API,每模型约300有效样本,保存完整请求和响应数据,用于模型指纹识别和检测。
This dataset is intended for distinguishing and detecting 17 AI models via statistical distribution fingerprints of randomly selected numbers. Collected from the OpenRouter API, it contains approximately 300 valid samples per model, preserves complete request and response data, and includes raw response data as well as similarity analysis results, targeting model fingerprinting and detection tasks.
创建时间:
2026-06-26
原始信息汇总
数据集概述:AI 模型随机数指纹数据集
该数据集旨在通过分析 AI 模型对“随机选数字”这一指令的响应分布,来区分和检测不同的 AI 模型。
核心原理
- 大语言模型并非真正的随机数生成器。
- 使用固定提示词“请从 1 到 355 之间随机选择一个数字”和固定参数(
temperature=1.0)进行大量采样。 - 不同模型因训练数据、架构、RLHF 或 tokenizer 的差异,会生成统计上可区分的数字分布“指纹”。
- 该指纹不易被系统提示词覆盖,可用于检测第三方 API 是否使用了不同的底层模型。
数据采集
- 数据来源:通过 OpenRouter API 采集。
- 覆盖模型:共 17 个模型。
- 样本数量:每个模型约 300 个有效样本(其中 minimax 模型通过后处理恢复至 622 个样本)。
- 采样参数:
max_tokens=32,大多数模型禁用推理(reasoning.enabled=false)。对于强制使用推理的模型(如grok-build-0.1和kimi-k2.7-code),则设置max_tokens=2048。 - 数据保存:每条请求的完整信息均被保存,包括原始响应体、
system_fingerprint、用量(含成本)、请求参数、延迟和 HTTP 状态码。 - 采集特性:支持断点续采、并发请求以及遇到 429 状态码时的退避重试。
数据结构
| 路径 | 内容 |
|---|---|
data/raw_*.jsonl |
每个模型的全部原始请求记录(一行一条请求,包含完整响应) |
data/summary.json |
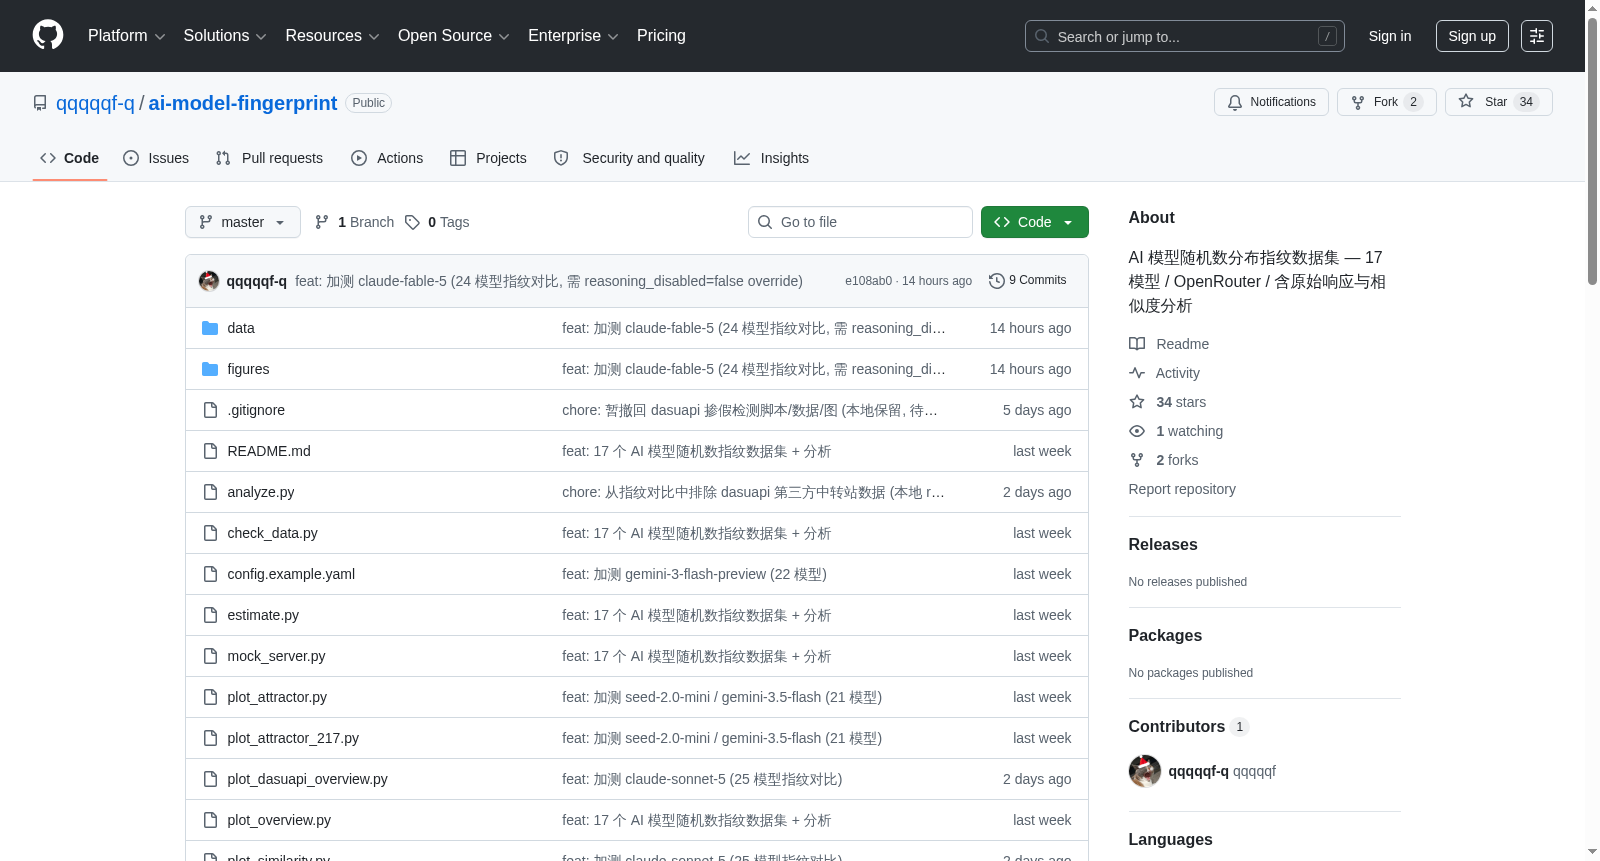
聚合数据,包括指纹向量、统计量、17×17 相似度矩阵以及所有模型的数字序列 |
figures/ |
可视化图表,如分布图、统计量图、相似度热力图、箱线图和综述图 |
覆盖模型(17个)
- Claude: opus 4.6、opus 4.7、opus 4.8、sonnet 4.6、haiku 4.5
- GPT: gpt-5.5、gpt-5.4、gpt-4o-mini
- GLM: glm-5.2
- DeepSeek: deepseek v3.2、v4-flash、v4-pro
- 其他: minimax-m3、qwen3.7-plus、grok-build-0.1、kimi k2.6、kimi k2.7-code
关键发现
- 模型版本间差异:Claude opus 4.6 和 4.7 的指纹几乎相同(余弦相似度 0.997),但 4.8 版本则完全不同(余弦相似度约 0.04),且其输出近乎固定(300 次中几乎总是输出 237)。
- 模型后训练影响:Kimi K2.6 与经过后训练的 K2.7-code 版本,指纹余弦相似度为 0.631,说明后训练会显著改变模型指纹。
- 同系列模型差异:DeepSeek 同系列的 v3.2、v4-flash 和 v4-pro 版本,相互之间的余弦相似度仅为 0.15 到 0.31。
- 跨模型相似性:发现一些跨模型组合的指纹非常相似,如 haiku-4.5 和 sonnet-4.6(余弦相似度 0.997),以及 kimi-k2.7-code 和 glm-5.2(余弦相似度 0.916)。
复现与成本
- 复现步骤:安装依赖、配置 OpenRouter API 密钥,然后依次执行数据采集、完整性验证、统计分析和成本预估脚本。
- 采集成本:全量采集约需 1.03 美元,其中 grok 模型的推理成本占比较大(平均每次请求消耗 637 个输出 token)。
搜集汇总
数据集介绍
构建方式
该数据集基于名为“随机选数字”的统计分布指纹构建,旨在区分17个不同AI模型。数据通过OpenRouter API采集,固定提示词为“请从1到355之间随机选择一个数字”,并设置temperature=1.0以确保采样多样性。每个模型收集约300个有效样本,其中minimax模型通过后处理恢复至622个样本。采集过程中,多数模型禁用推理功能,但grok-build-0.1和kimi-k2.7-code因强制推理而将max_tokens提升至2048。每条请求完整保存了原始响应体、系统指纹、使用情况、成本、请求参数、延迟及HTTP状态码,并支持断点续采、并发控制和429错误退避重试,确保了数据的完整性和采集效率。
特点
数据集的核心特点在于揭示了不同AI模型在随机数生成上的统计分布差异,这些差异源于模型训练数据、架构、RLHF过程及分词器的不同,且不易被系统提示词覆盖。关键发现包括:Claude Opus 4.6与4.7的指纹几乎相同(余弦相似度0.997),但4.8版本截然不同(余弦相似度约0.04),且4.8版本几乎固定输出237;Kimi K2.6与K2.7-code的相似度为0.631,表明后训练显著改变了指纹;DeepSeek同系列的不同版本间相似度仅为0.15至0.31。此外,数据集提供了17×17相似度矩阵、指纹向量及统计量,便于深入分析模型间关系。
使用方法
使用该数据集时,用户可通过安装依赖并配置OpenRouter API密钥开始。执行python run.py --samples 300命令进行数据采集,随后运行python check_data.py验证数据完整性。利用python analyze.py脚本生成统计量和可视化图表,包括分布图、相似度热力图和箱线图,从而直观观察各模型的指纹特征。数据集还提供python estimate.py用于预估令牌和成本,方便规划进一步实验。所有原始记录存储于data/raw_*.jsonl文件,汇总数据与相似度矩阵位于data/summary.json,可视化结果存放于figures/目录,结构清晰,便于研究者复现和扩展分析。
背景与挑战
背景概述
随着大规模语言模型在各类应用中的广泛部署,模型身份验证与溯源成为日益重要的研究课题。当前,第三方API服务可能通过替换底层模型或混合推理来降低成本,给用户带来安全隐患。为此,研究人员于近期构建了AI模型随机数指纹数据集,由团队通过OpenRouter API对17个主流大模型进行系统性采样。该数据集的核心研究问题在于:能否利用大模型对固定随机数生成任务的统计输出差异,构建独一无二的模型指纹,从而实现对不同模型的有效区分与检测。这一思路借鉴了模型输出分布中的潜在规律,为模型身份认证提供了非侵入式的轻量级方案。数据集构建过程中,团队严格控制采样参数,并针对部分推理强制模型进行调整,累计采集约5100条有效样本,涵盖了Claude、GPT、DeepSeek、Kimi等主流模型,为后续模型指纹研究奠定了坚实基础。该数据集不仅在模型安全领域具有开创性意义,也为模型溯源、版权保护及服务质量监控等应用提供了新的视角。
当前挑战
该数据集在构建与应用中面临多重挑战。首先,核心领域挑战在于如何克服大模型随机数生成分布中的噪声与不确定性,提取稳定且具有区分度的指纹特征。实验显示,同一模型在不同版本间可能呈现极高相似度(如Claude Opus 4.6与4.7的余弦相似度达0.997),而部分模型(如Claude Opus 4.8)则表现出极低熵的准固定输出,这些现象使得指纹的定义与提取缺乏统一标准。其次,构建过程中遇到的技术挑战包括:如何管理OpenRouter API的高并发请求与429限频退避策略,确保数据采集的连续性与完整性;部分模型(如grok-build-0.1与kimi-k2.7-code)强制启用推理模式,导致输出长度与token消耗显著增加,需要动态调整max_tokens参数;此外,样本量控制方面,每模型约300条有效样本是否足以捕捉完整的分布特征,仍需进一步验证。最后,跨模型的指纹相似性分析揭示了意料之外的关联性(如haiku-4.5与sonnet-4.6高度相似),这提示模型架构或训练数据中可能存在未被预见的共同属性,为指纹的鲁棒性带来了新的挑战。
常用场景
经典使用场景
该数据集的核心使用场景在于通过分析大语言模型在固定提示下对随机数生成任务的输出分布,构建具有统计显著性的模型指纹。研究者可利用该数据集中17个主流模型的近300次采样结果,计算各模型输出的数字频率分布、熵值、唯一值比例等统计量,并与相似度矩阵进行比对,从而实现对未知API调用背后真实模型身份的推断与验证。这一方法为模型溯源、API服务审计等任务提供了可量化的技术路径。
实际应用
在实际业务场景中,该数据集可直接用于第三方大模型API服务的质量监控与合规检测。当企业采购或集成外部AI能力时,可以通过部署随机数指纹采集流程,定期对API应答进行统计指纹比对,判断服务商是否在高峰时段降级替换为低性能模型或混合使用多版本模型。此外,该技术还可用于检测模型蒸馏攻击、推理API中是否嵌入了不同架构的辅助模型,以及评估模型版本更新对输出行为的实际影响,为AI服务采购的透明度与可靠性提供量化保障。
衍生相关工作
基于该数据集的指纹分析方法,衍生出一系列重要研究工作:包括利用输出分布差异对模型进行聚类与元学习分类,构建跨版本、跨厂商的模型谱系树;发展对抗性测试框架,评估系统提示词与后处理对指纹的鲁棒性;以及结合贝叶斯推断与信息论方法,极小化从有限样本中提取指纹所需的查询成本。同时,也有工作将该思路推广到代码生成、逻辑推理等其他任务类型,探索多维行为指纹实现更精确的模型识别与异常检测体系。
以上内容由遇见数据集搜集并总结生成


