
遇见数据集

Data-Gouv-FR/temps-de-parole-des-femmes-et-des-hommes-dans-les-programmes-ayant-fait-lobjet-dune-declaration

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

该数据集包含法国电视和广播节目中女性和男性的发言时间估计数据,这些数据来源于法国高级视听委员会(CSA)关于电视和广播中女性代表性的年度报告(2019年和2020年)。发言时间通过使用INA开发的免费软件inaSpeechSegmenter自动计算得出,该软件基于机器学习算法,训练于大量音乐、噪音、女声和男声样本,以检测视听文档中的语音区域。数据集涵盖26个电视频道和14个广播电台,但部分频道在特定年份未进行分析或数据不足。数据集结构包括两个子集:按节目类型分类的发言时间和按频道分类的发言时间。

This dataset contains estimated speaking time data for female and male speakers across French television and radio programs. The data is sourced from the 2019 and 2020 annual reports on the representation of women in television and radio published by the Conseil Supérieur de l'Audiovisuel (CSA). Speaking time was automatically computed using inaSpeechSegmenter, a free software developed by the Institut National de l'Audiovisuel (INA). This software employs a machine learning algorithm trained on large-scale datasets of music, ambient noise, female speech, and male speech to identify speech segments in audiovisual documents. The dataset encompasses 26 television channels and 14 radio stations, yet some channels were not analyzed or lacked sufficient data in certain years. The dataset is structured with two subsets: speaking time categorized by program genre, and speaking time categorized by broadcasting channel.
提供机构:
Data-Gouv-FR
搜集汇总
数据集介绍
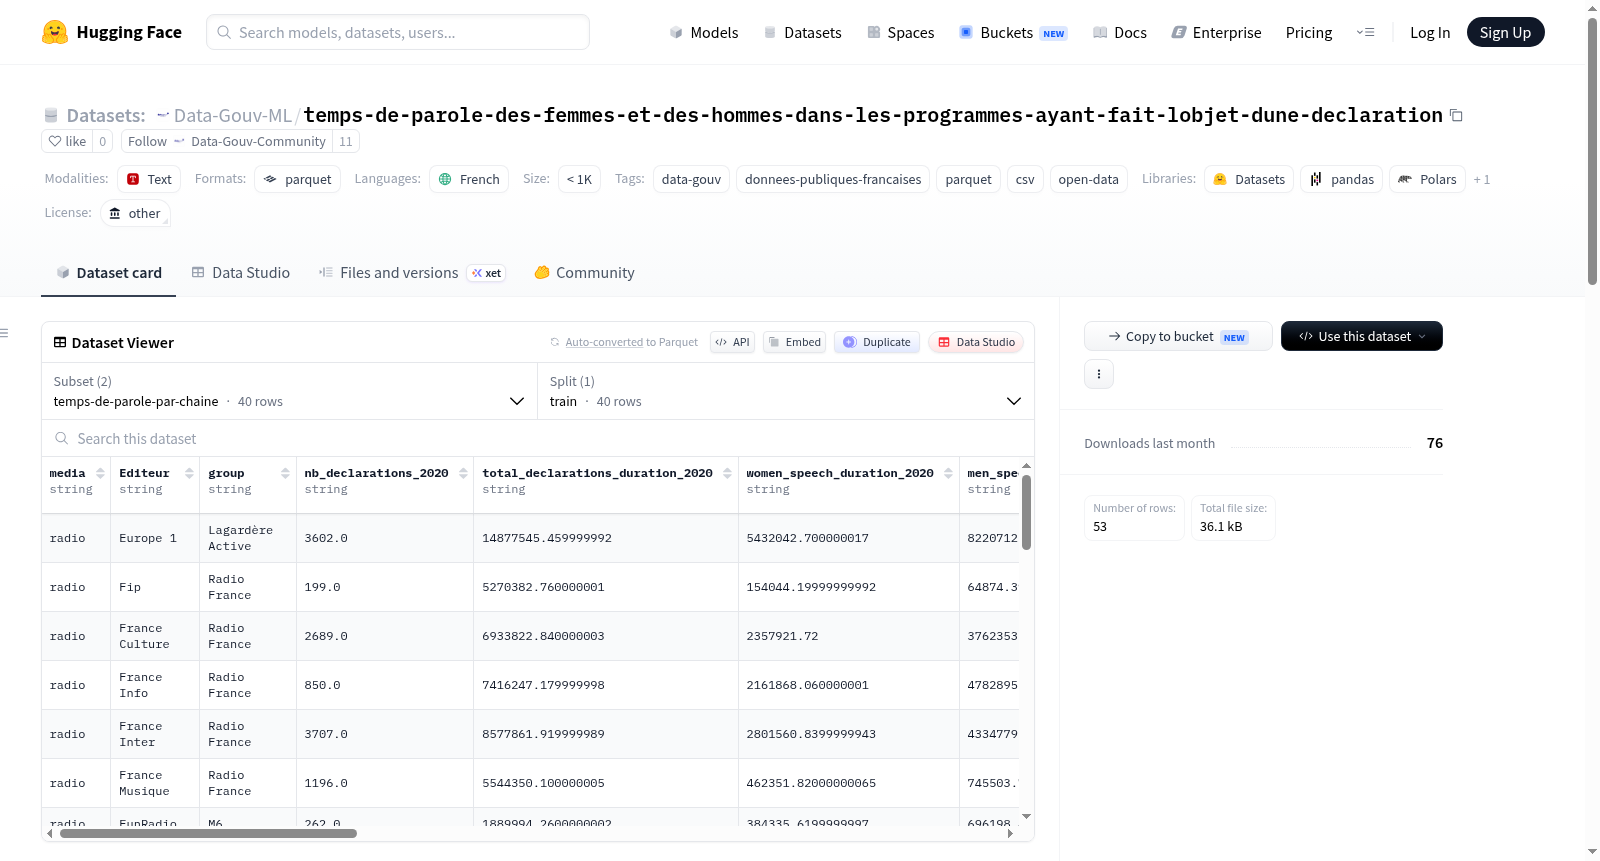
Data-Gouv-FR/temps-de-parole-des-femmes-et-des-hommes-dans-les-programmes-ayant-fait-lobjet-dune-declaration 数据集图片
构建方式
该数据集源自法国公共数据平台data.gouv.fr,聚焦于法国最高视听委员会(CSA)年度报告中关于电视与广播节目中女性与男性发言时间的统计数据。数据构建依托于法国国家视听研究院(INA)研发的开源软件inaSpeechSegmenter,该软件基于机器学习算法,通过对大量音乐、噪声、男女声样本的训练,自动检测并分割视听文档中的语音区域,从而量化不同性别的发言时长。数据集覆盖了2019至2020年间26个电视频道和14个广播电台的节目内容,其中部分频道与电台因样本量不足或已停播而未被纳入分析。
使用方法
用户可通过Hugging Face的datasets库直接调用该数据集,例如使用load_dataset函数选择特定子集(如“temps-de-parole-par-genre-de-programme”),即可获取包含发言时间的训练数据。该数据集适用于性别话语权分析、媒体内容研究、社会学统计及机器学习模型训练等场景。用户可结合pandas等工具进行数据清洗与可视化,或利用其原始属性探索电视与广播节目中性别代表的动态变化。需要注意的是,数据为预分割的Parquet文件,加载后可直接进行聚合、筛选或与其他数据源关联分析。
背景与挑战
背景概述
该数据集由法国最高视听委员会(CSA)于2020年基于2019至2020年度电视与广播节目中的女性与男性发言时间数据创建,主要研究人员包括来自法国国家视听研究所(INA)的David Doukhan与Jean Carrive等人。其核心研究问题在于量化评估法国主流媒体中性别代表性失衡现象,通过自动语音分割技术(inaSpeechSegmenter)对26个电视频道及14个广播电台的节目内容进行多维度分析。该数据集作为开放数据资源,为性别平等政策制定、媒体内容审计及计算社会科学研究提供了关键基础,是法国公共数据在性别研究领域的标志性应用。
当前挑战
该数据集面临的领域挑战主要在于媒体性别表征问题本身——女性在新闻、娱乐及政治类节目中的发言时间长期显著低于男性,这种结构性不公需要通过精确量化来驱动政策干预。构建过程中的技术挑战则体现于自动语音识别算法对性别分类的准确性,由于基于机器学习的inaSpeechSegmenter在嘈杂背景、多说话人重叠或非标准语音模式(如变声、口音)下易产生误判,需人工校验以降低偏差;此外,跨年度数据(2019-2020)因部分频道样本量不足(如CStar、Gulli)或频道停播(如France Ô)导致分析覆盖不完整,进一步增加了数据融合与可比性分析的难度。
常用场景
经典使用场景
该数据集源自法国视听与数字通信监管机构(CSA)的年度报告,专注于量化法国电视与广播节目中女性和男性的发言时长分布。其经典使用场景在于借助自动化语音分割工具inaSpeechSegmenter,对26个电视频道和14个广播电台的节目内容进行性别维度的语音时间分析,从而揭示媒体话语权中的性别失衡现象。研究者可通过按节目类型或频道细分的子集,精确剖析不同节目形态(如新闻、娱乐、脱口秀)与不同媒体机构中女性发言比例的差异,为后续性别平等政策评估提供可重复、可比较的实证基础。
解决学术问题
该数据集有效解决了媒体研究中长期存在的两大难题:一是如何大规模、客观地获取媒体内性别话语的量化数据,替代传统耗时的人工标注方式;二是如何为性别平等政策的效能评估提供标准化基准。通过引入机器学习驱动的语音性别识别技术,它突破了以往研究样本量小、覆盖范围窄的局限,使得跨频道、跨年度的纵向比较成为可能。这为传播学、性别研究和社会学领域提供了关键数据支撑,推动了关于媒体再现如何影响公众性别认知、女性在公共话语空间中的边缘化程度等核心学术议题的实证探索。
实际应用
在实际应用中,该数据集为媒体监管机构、电视台和广播电台提供了可操作的性别平衡监测工具。监管机构可定期追踪各频道是否遵循性别平等的指导方针,并据此调整政策要求;媒体机构自身则能审视其节目制作与嘉宾邀请过程中的潜在性别偏见,进而优化内容策略,例如增加女性专家的曝光率或调整特定时段的话语分配。此外,民间组织和记者亦可利用公开数据开展独立的媒体监督项目,发起公众对媒体代表性的讨论,形成自上而下与自下而上相结合的性别平等推动力。
数据集最近研究
最新研究方向
在性别平等议题日益成为全球焦点的背景下,该数据集聚焦于法国广播电视中女性与男性话语时间的量化分析,依托CSA年度报告与INA开发的inaSpeechSegmenter自动语音识别技术,精准呈现了26个电视频道与14个广播电台在2019至2020年间的性别话语分布。前沿研究方向已从单一的时间测量转向交叉性分析,即结合节目类型、频道属性与社会文化语境,探究话语时间差异背后的结构性偏见。例如,研究者正利用该数据揭示不同节目流派(如新闻、娱乐、体育)中性别呈现的不对称,并关联到#MeToo运动及法国媒体监管改革等社会热点事件,评估政策干预对性别失衡的矫正效果。这一资源的开放性与细粒度使其成为推动媒体性别公平的重要工具,助力构建更包容的公共话语空间。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

