terminal_bench_2_a1_stack_bash_20260822_024512
收藏资源简介:
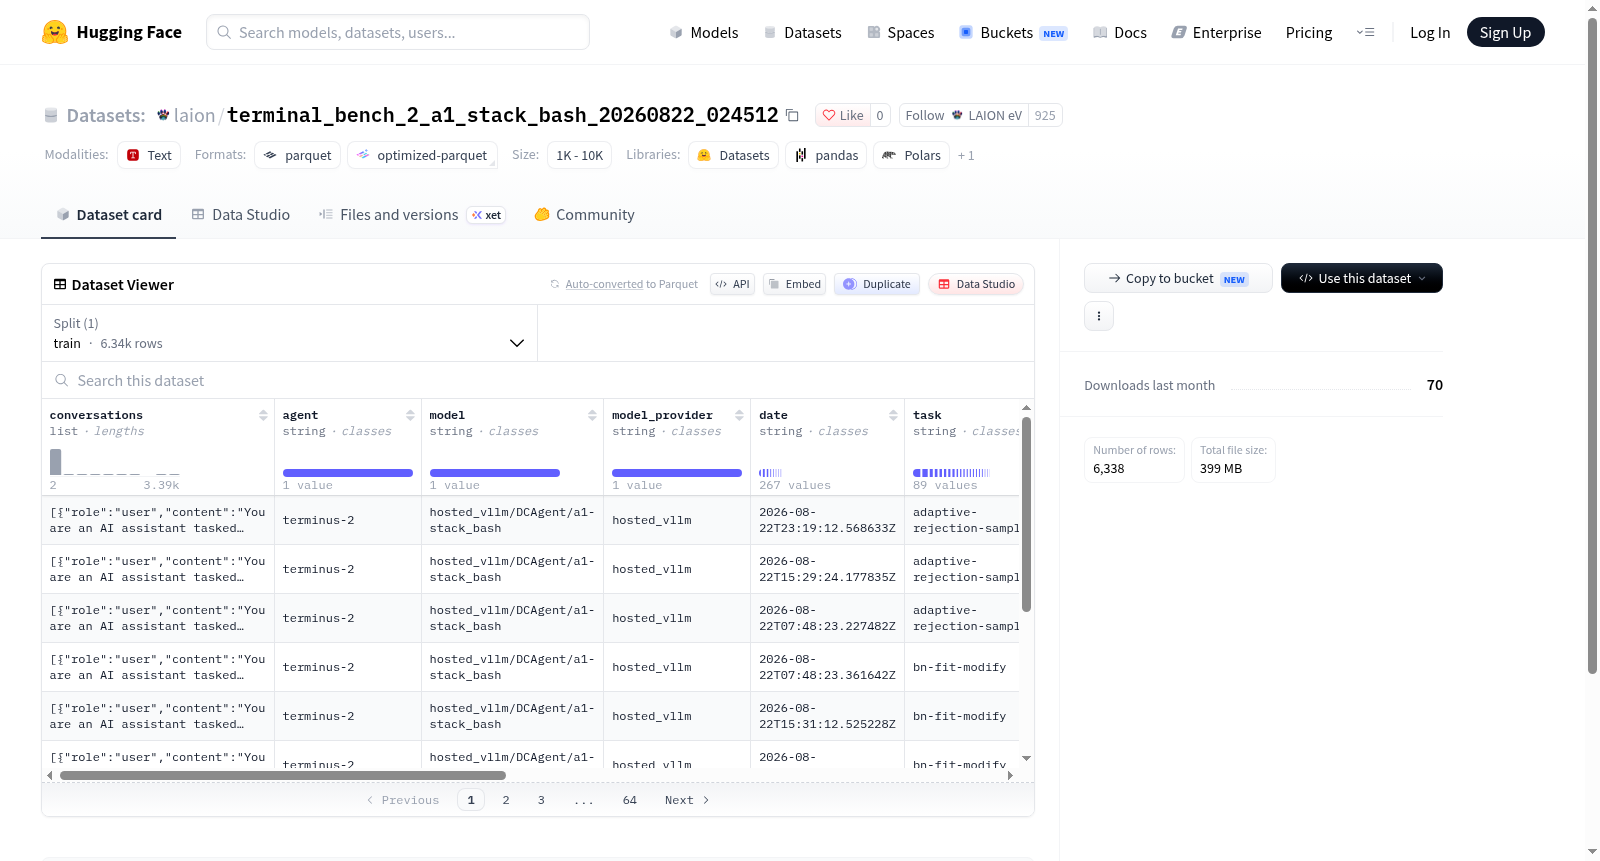
该数据集包含6338个样本,每个样本记录了一次智能体交互的完整对话历史及相关元信息。每条样本由以下字段组成:conversations字段为对话列表,每条对话包含角色(role)和内容(content);agent字段标识智能体名称;model和model_provider分别记录使用的模型及其提供商;date字段记录日期;task字段标记任务类型;episode、run_id、trial_name用于追踪实验运行;result字段存储最终结果;verifier_output字段包含验证器输出;trace_source字段注明跟踪来源。数据集仅提供训练集拆分,总数据量约490MB,适用于分析智能体对话行为、模型性能比较或验证器效果评估等场景。
This dataset contains 6338 samples, each recording a complete dialogue history of an agent interaction along with related metadata. Each sample consists of the following fields: the conversations field is a list of dialogues, each containing role and content; the agent field identifies the agent name; model and model_provider record the model used and its provider respectively; the date field records the date; the task field marks the task type; episode, run_id, and trial_name are used to track experiment runs; the result field stores the final result; the verifier_output field contains the verifier output; the trace_source field indicates the trace source. The dataset provides only the training split, with a total data size of approximately 490MB, suitable for analyzing agent dialogue behavior, model performance comparison, or verifier effect evaluation.
数据集概述:laion/terminal_bench_2_a1_stack_bash_20260822_024512
基本信息
- 数据集名称:terminal_bench_2_a1_stack_bash_20260822_024512
- 提供方:LAION
- 数据集大小:约490.5 MB(下载大小约398.7 MB)
- 训练集样本数量:6,338条
- 数据格式:仅包含训练集(train split)
数据字段说明
| 字段名 | 数据类型 | 说明 |
|---|---|---|
| conversations | 列表(含role和content字段) | 对话记录,role为角色(字符串),content为内容(字符串) |
| agent | 字符串 | 代理标识 |
| model | 字符串 | 使用的模型名称 |
| model_provider | 字符串 | 模型提供方 |
| date | 字符串 | 日期信息 |
| task | 字符串 | 任务描述 |
| episode | 字符串 | 轮次/会话编号 |
| run_id | 字符串 | 运行标识 |
| trial_name | 字符串 | 试验名称 |
| result | 字符串 | 执行结果 |
| verifier_output | 字符串 | 验证器输出 |
| trace_source | 字符串 | 追踪来源 |
数据用途建议
该数据集包含对话记录、代理信息、模型信息、任务描述及执行结果等字段,适用于终端环境下的代理行为分析、多轮对话建模、以及基于bash/stack任务场景的智能体评估与训练。数据集规模适中(6,338条),适合作为细粒度终端交互任务的训练或验证数据。