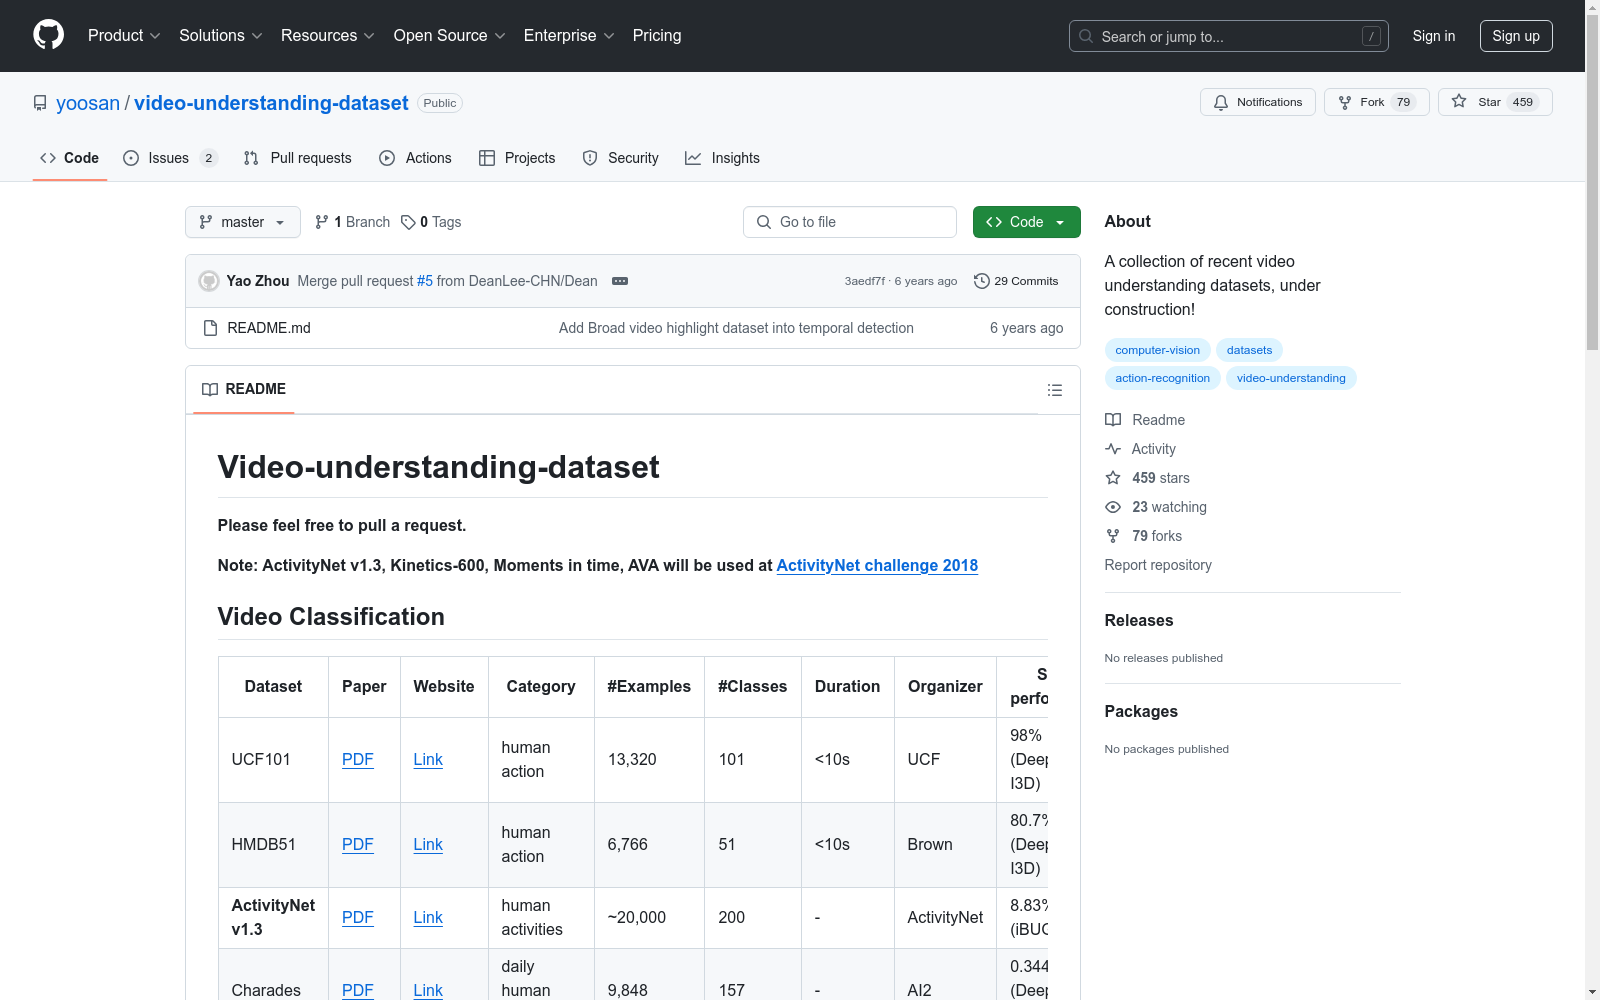
ActivityNet v1.3: 包含约20,000个人类活动的视频数据集。 Kinetics-600: 包含约500,000个人类动作的视频数据集,每个视频约10秒。 Moments in Time: 包含约100万个描述动作或活动的视频数据集,每个视频约3秒。 AVA: 包含57.6k个视频片段,涉及80个类别,用于时空定位的原子视觉动作。 UCF101: 包含13,320个视频,涉及101个类别的人类动作。 HMDB51: 包含6,766个视频,涉及51个类别的人类动作。 Charades: 包含9,848个视频,涉及157个类别的日常人类活动。 Sports-1M: 包含约100万个视频,涉及478个类别的体育活动。 YouTube-8M: 包含约700万个视频,涉及4716个类别的视觉内容。 FCVID: 包含91,223个视频,涉及239个类别的视觉内容。 Something-Something: 包含108,499个视频,涉及174个类别的与物体相关的动作。 SLAC: 包含520K个视频片段,涉及200个类别,用于识别和定位。 THUMOS2014: 包含9,682个视频片段,用于时间动作检测。 Broad Video Highlights: 包含18,000个视频片段。 Jester: 包含148,092个视频片段,涉及27个类别的手势。 MPII-MD: 包含68,337个视频片段,涉及电影内容。 MSR-VTT: 包含10,000个视频片段,涉及20个类别。 Densevid: 包含20k个视频片段和100k个句子,涉及事件。 MovieQA: 包含408部电影和14,944个问答对,涉及电影中的问答。 MarioQA: 包含187,757个示例和92,874个问答对,涉及游戏视频中的事件推理。
ActivityNet v1.3: A video dataset containing approximately 20,000 human activities. Kinetics-600: A video dataset containing approximately 500,000 human actions, each video about 10 seconds. Moments in Time: A video dataset containing approximately 1 million videos describing actions or activities, each video about 3 seconds. AVA: Contains 57.6k video clips, involving 80 categories, used for spatiotemporal localization of atomic visual actions. UCF101: Contains 13,320 videos, involving 101 categories of human actions. HMDB51: Contains 6,766 videos, involving 51 categories of human actions. Charades: Contains 9,848 videos, involving 157 categories of daily human activities. Sports-1M: Contains approximately 1 million videos, involving 478 categories of sports activities. YouTube-8M: Contains approximately 7 million videos, involving 4716 categories of visual content. FCVID: Contains 91,223 videos, involving 239 categories of visual content. Something-Something: Contains 108,499 videos, involving 174 categories of object-related actions. SLAC: Contains 520K video clips, involving 200 categories, used for recognition and localization. THUMOS2014: Contains 9,682 video clips, used for temporal action detection. Broad Video Highlights: Contains 18,000 video clips. Jester: Contains 148,092 video clips, involving 27 categories of gestures. MPII-MD: Contains 68,337 video clips, involving movie content. MSR-VTT: Contains 10,000 video clips, involving 20 categories. Densevid: Contains 20k video clips and 100k sentences, involving events. MovieQA: Contains 408 movies and 14,944 question-answer pairs, involving questions and answers in movies. MarioQA: Contains 187,757 examples and 92,874 question-answer pairs, involving event reasoning in game videos.