
chkrishna2001/nano-psm-codex-sessions-gpt41-mini-200
收藏官方服务:
资源简介:
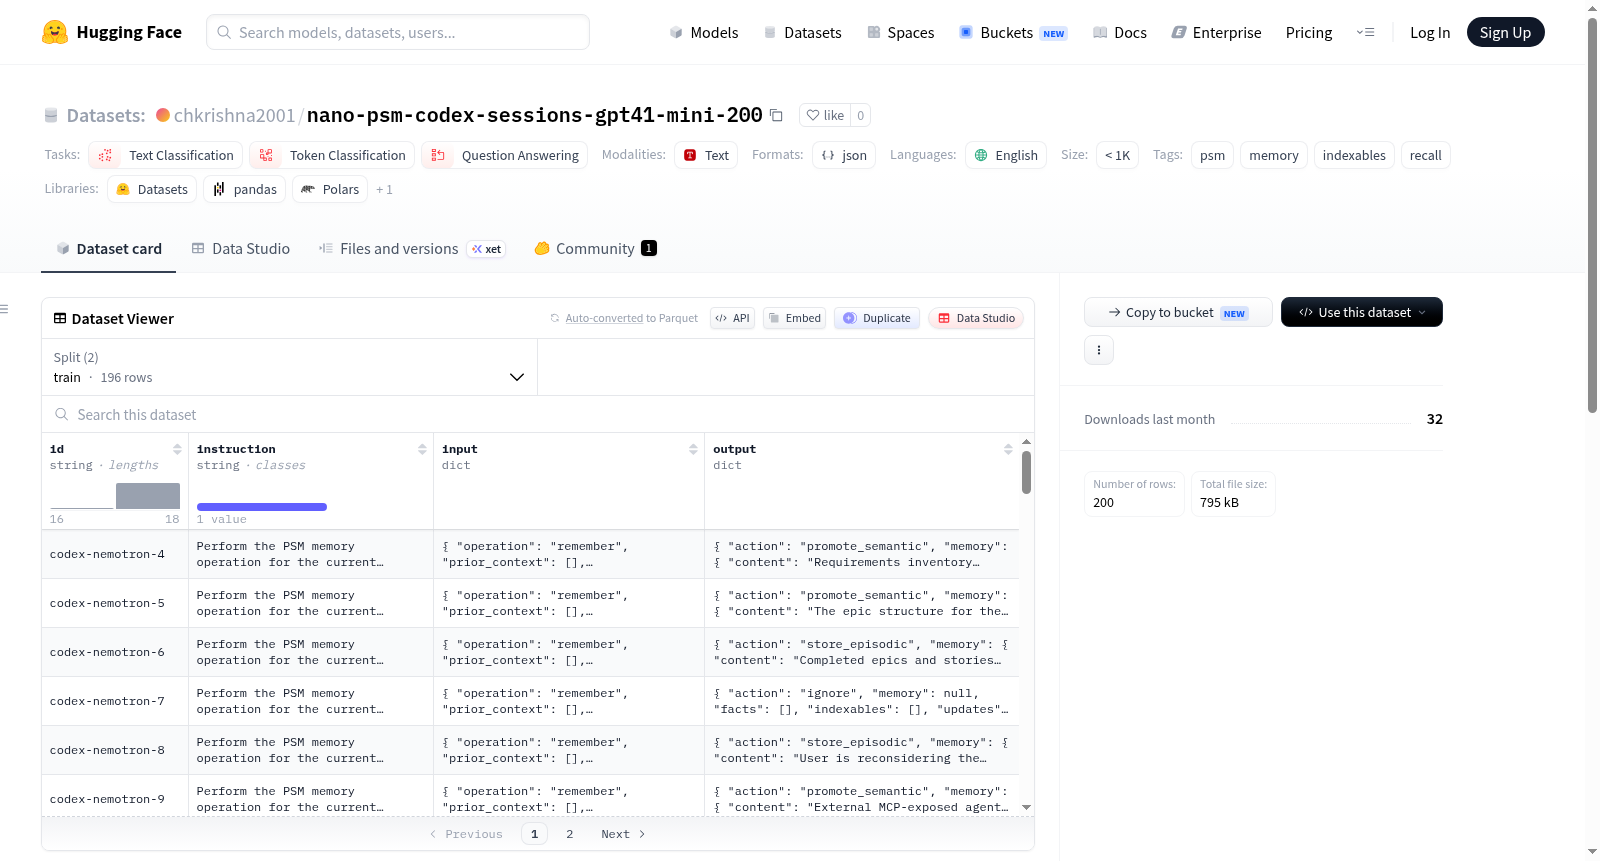
该数据集包含用于训练Nano PSM(一种结构化内存操作模型)的质量门控示例。
This dataset contains quality-gated examples for training Nano PSM, a structured memory manipulation model.
提供机构:
chkrishna2001搜集汇总
数据集介绍
构建方式
在计算语言学与记忆增强型模型的研究前沿,结构化记忆操作模型(如Nano PSM)的训练需依赖高质量、经过严格筛选的示例数据。本数据集正是为此而生,其构建历经三重质量门控流程:首先通过标准模式验证(canonical schema validation)确保数据格式的规范性与统一性;继而执行运行时兼容性验证(runtime compatibility validation)以保障数据与模型训练框架的无缝对接;最后实施数据集质量审计(dataset quality audit),从语义完整性、标注一致性及任务适配性等维度进行综合评估,仅保留通过全部门槛的优质样本。此举旨在剔除可能引入噪声或误导模型学习的低质量或非标准数据,从而为Nano PSM的记忆操作能力提供纯净的培育土壤。
使用方法
使用本数据集时,研究者应遵循预设的规范流程以最大化其效能。首先,需加载train.jsonl与validation.jsonl文件,分别用于模型训练与性能评估;随后可借助metadata.json理解数据全局属性,并通过审查质量审计报告(如quality-audit.json)及审查样本(review-sample.jsonl)确认数据分布的合理性。建议在Nano PSM框架内直接引用数据,避免额外预处理以防引入偏差。同时,务必遵守质量门控条件,仅使用经过完整验证的官方导出版本,从而确保实验结果的可复现性与模型记忆操作学习过程的有效性,为探索结构化记忆机制奠定可靠基础。
背景与挑战
背景概述
该数据集nano-psm-codex-sessions-gpt41-mini-200由研究团队创建,旨在支持Nano PSM(一种结构化记忆操作模型)的训练。Nano PSM专注于从对话或文本中提取、索引并召回结构化的记忆单元,以增强模型在长上下文或持续交互场景下的信息保持与推理能力。数据集创建时间应与相关模型开发周期同步,其核心研究问题在于如何通过文本分类、令牌分类和问答等任务,系统性地构建高质量的记忆操作示例,从而推动语言模型在记忆与检索机制上的突破。该数据集对研究结构化记忆与语言模型整合的领域具有潜在影响力,为后续模型训练提供了经过质量门控筛选的基准资源。
当前挑战
数据集面临的领域挑战在于语言模型对复杂、持续对话中结构化记忆的自动构建与准确召回能力不足,现有模型常受限于上下文窗口大小或记忆混淆,难以在长序列中维持一致的记忆状态。构建过程中,团队克服了质量门控的多重障碍,包括规范模式验证、运行时兼容性测试及数据集质量审计,确保每条示例均符合结构化记忆操作的高标准。此外,从多样化的源数据中提取并混合动作类型,需平衡不同记忆操作的覆盖范围与样本代表性,避免引入噪声或冗余信息,这构成了数据集构建的另一显著难点。
常用场景
经典使用场景
在结构化记忆操作模型的研究中,nano-psm-codex-sessions-gpt41-mini-200数据集被广泛应用于文本分类、词元分类和问答等经典自然语言处理任务。该数据集经过严格的质量门控流程,确保数据符合规范模式、运行兼容性和质量审计标准,为训练Nano PSM这类具备记忆操作能力的模型提供了可靠基础。研究者通常利用该数据集来构建和评估模型在结构化记忆存储与检索过程中的性能表现,特别是在需要精准控制信息索引和召回的场景下。通过精心设计的对话会话与记忆操作示例,数据集支持模型学习如何将动态交互中的关键信息进行结构化编码,从而在后续推理任务中高效调用。
解决学术问题
该数据集的核心价值在于解决结构化记忆操作模型训练中普遍面临的数据质量与标准化困境。在学术层面,它有效应对了模型在记忆存储与检索过程中出现的模式不兼容、运行时错误以及性能不可控等问题。通过引入多重质量门控机制,包括规范模式验证、运行兼容性验证和质量审计,数据集确保了训练样本的一致性与可靠性,从而提升了模型在复杂场景下的泛化能力。这一工作推动了记忆增强型自然语言处理范式的发展,使得模型能够更加稳定地处理长程依赖任务,如多轮对话中的上下文保持、动态知识库问答等,为理解记忆的显式操作机制提供了标准化的实验平台。
实际应用
在实际应用层面,该数据集所训练的Nano PSM模型有望被部署于各类需要长期记忆与结构化信息管理的智能系统中。例如,在虚拟助手场景中,模型能够在多轮对话过程中精准记录用户偏好、历史状态和任务进度,实现无缝的上下文切换与个性化服务。在知识管理系统中,模型可协助对非结构化文本进行结构化索引,提升信息检索的准确性和效率。此外,在教育辅导、医疗问诊等领域,模型可以基于对话历史有效跟踪用户需求变化,避免信息遗忘导致的重复询问。这些应用场景都依赖于数据集所提供的标准化记忆操作示例。
数据集最近研究
最新研究方向
该数据集聚焦于结构化记忆操作模型(Nano PSM)的训练优化,是探索大语言模型(LLM)长程记忆与精准检索能力的前沿阵地。伴随以GPT-4.1 mini为代表的轻量级推理模型在智能助手中的普及,如何通过“索引-召回”机制替代传统上下文窗口限制成为热点。nano-psm-codex-sessions-gpt41-mini-200通过250余条高质量、经严格质量门控(含模式验证、运行时兼容检查与审计)的样本,为模型学习显式记忆操作指令(如存储、检索、遗忘)提供了稀缺的标注资源。该数据集的意义在于补全LLM从“被动上下文学习”向“主动结构化记忆”转型的关键训练地基,直接影响下一代具备持久化知识管理能力的智能体的落地效果。
以上内容由遇见数据集搜集并总结生成


