
chkrishna2001/nano-psm-retention-dominant-codex-9k
收藏官方服务:
资源简介:
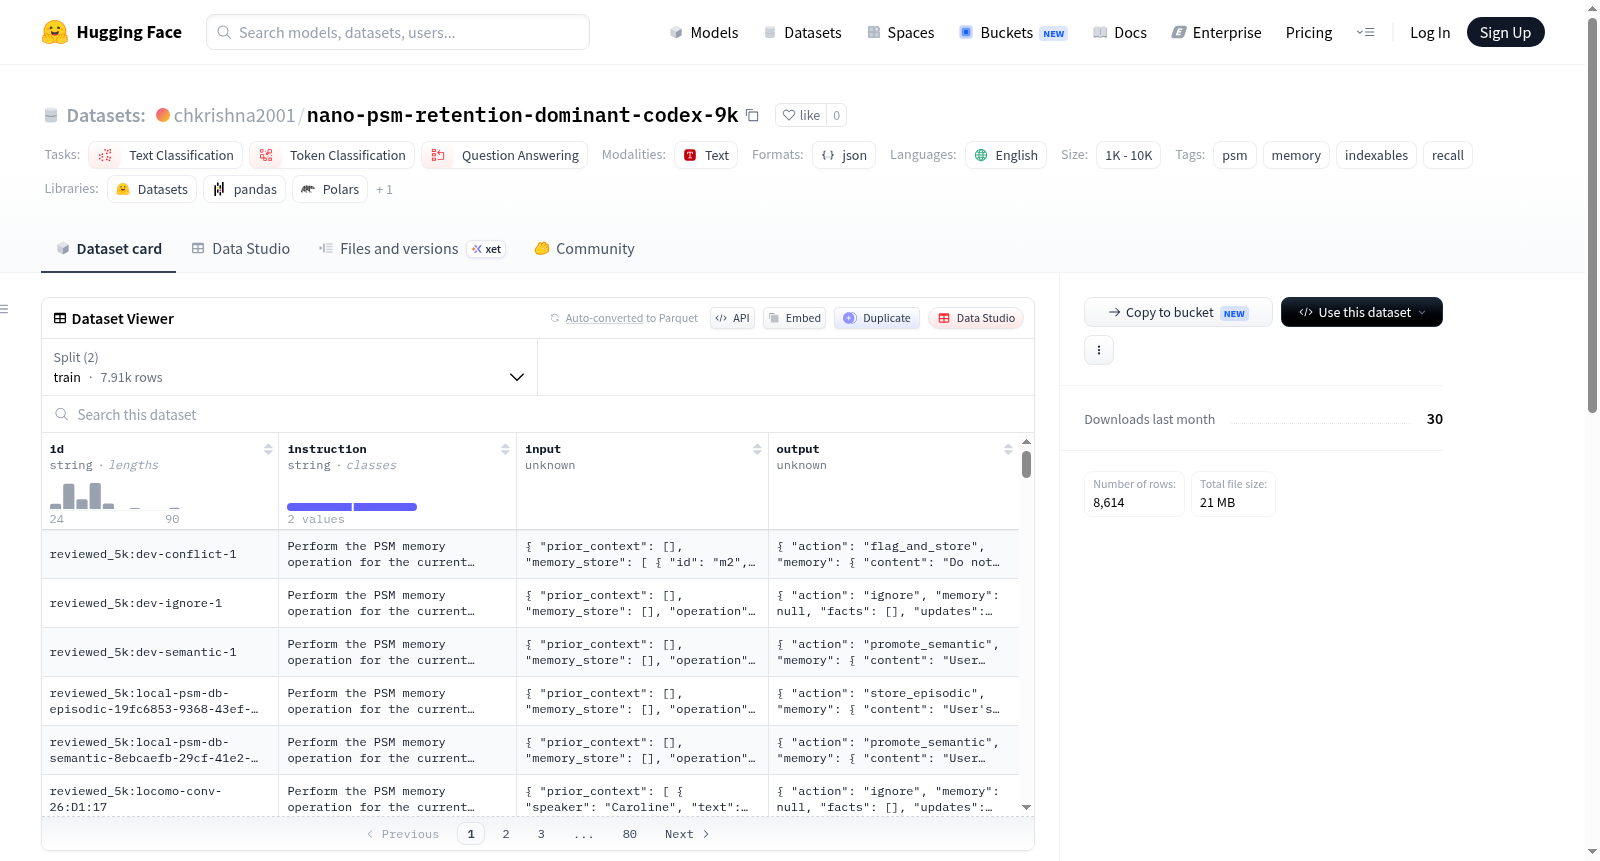
该数据集包含经过质量门控的示例,用于训练Nano PSM(一种结构化内存操作模型)。数据集经过规范模式验证、运行时兼容性验证和数据集质量审核,确保数据质量,适用于文本分类、标记分类和问答等任务。
This dataset contains quality-gated examples tailored for training Nano PSM, a structured memory manipulation model. It has undergone standard schema validation, runtime compatibility verification, and dataset quality audit to ensure data quality, making it suitable for tasks such as text classification, token classification, and question answering.
提供机构:
chkrishna2001搜集汇总
数据集介绍
构建方式
该数据集nano-psm-retention-dominant-codex-9k专门为训练Nano PSM这一结构化记忆操作模型而构建。其构建过程严格遵循质量门控机制,首先通过规范模式验证确保数据格式符合预定标准,随后进行运行时兼容性验证以保障模型训练环境的适配性,最后执行数据集质量审计以筛选出优质示例。所有数据均来源于具备保留主导特性的Codex样本,经过层层过滤与精炼,最终形成约9000条高质量训练与验证样本。
特点
该数据集的核心特色在于其高质量与专注性,专为高效的记忆操作建模而设计。所有样本均经过严格质量审计,确保仅保留最符合Nano PSM模型训练需求的示例。此外,数据集包含详尽的元数据与报告文件,如动作混合报告、来源混合报告及质量审计报告,为模型训练提供了透明的数据溯源与质量控制依据。这种严谨的筛选机制使其在同类数据集中脱颖而出,尤其适合对数据纯净度有极高要求的记忆增强型任务。
使用方法
使用该数据集时,用户可直接加载提供的训练集与验证集JSONL文件进行Nano PSM模型的训练与评估。为确保模型性能,建议遵循数据集的原始设计意图,避免在未经质量门控筛选的原始数据上进行训练。同时,可参考元数据文件及多份质量报告(如dataset-summary.json、action-mix.json等)来深入理解数据分布与样本构成,从而优化训练策略。该数据集特别适用于文本分类、序列标注及问答等需结构化记忆交互的任务场景。
背景与挑战
背景概述
在神经符号计算与结构化记忆建模的交叉领域,nano-psm-retention-dominant-codex-9k数据集于近期由专注于小样本记忆操作模型的研究团队构建,旨在支撑Nano PSM这一结构化记忆操作模型的训练与评估。该数据集聚焦于英文文本中的保留主导型序列处理,核心研究问题在于如何通过质量严格把控的示例数据,使模型习得对索引项(indexables)的精确召回与操作能力,从而提升语言模型在长程依赖与记忆密集型任务中的表现。其影响力体现在为轻量级记忆增强架构提供了标准化训练素材,弥补了现有数据集在结构化记忆操作任务上的不足,有望推动自然语言处理中记忆机制研究的工程化与可复现性。
当前挑战
该数据集所解决的领域问题核心挑战在于:传统语言模型在需要显式记忆操作的任务(如跨段落实体追溯、结构化问答)中表现脆弱,而现有数据集缺乏对保留主导型序列操作(PSM)的细粒度标注与质量约束,导致模型难以稳定习得记忆写入与检索的鲁棒策略。构建过程中的挑战则体现在多层级质量门的设置:需通过规范模式验证确保数据格式与预设操作原语兼容,通过运行时兼容性验证消除动态执行环境中的歧义,以及通过质量审计过滤噪声示例,同时维护动作类型与来源数据的混合比例均衡,以保障训练数据在结构复杂性与泛化性之间的平衡。
常用场景
经典使用场景
在结构化记忆操作模型的研究中,nano-psm-retention-dominant-codex-9k数据集被广泛用于训练和评估Nano PSM模型。该数据集包含经过质量门控的示例,专注于记忆操作、索引化与召回任务,为模型学习如何高效管理结构化记忆信息提供了高质量的基准数据。文本分类、令牌分类与问答等多任务标签的设计,使得该数据集成为探究记忆增强型神经网络行为的理想选择。
衍生相关工作
该数据集衍生了一系列关于结构化记忆操作模型的重要工作,包括但不限于索引化记忆网络的架构优化、基于召回机制的记忆增强Transformer改进,以及质量门控策略对模型训练稳定性的影响研究。这些工作不仅验证了数据集所包含示例的有效性,还探索了如何在更广泛的语言理解任务中应用记忆操作原理,推动了记忆增强机器学习的前沿进展。
数据集最近研究
最新研究方向
该数据集专注于结构化记忆操作模型Nano PSM的训练,前沿研究方向聚焦于将记忆机制与可索引化召回深度融合,推动语言模型在长文本依赖与复杂推理任务中的性能突破。近期热点事件包括针对持久状态记忆(PSM)的质量门控筛选技术,通过严格规范验证与运行时兼容性审计,确保训练数据的高保真与鲁棒性,这标志着数据集构建从数量扩展向质量控制的关键转型。该成果有望显著提升模型在文本分类、Token级标注及问答等场景下的上下文保持能力,为可解释人工智能与长期记忆系统的落地提供可靠数据基座。
以上内容由遇见数据集搜集并总结生成


