nanoGentzen
收藏资源简介:
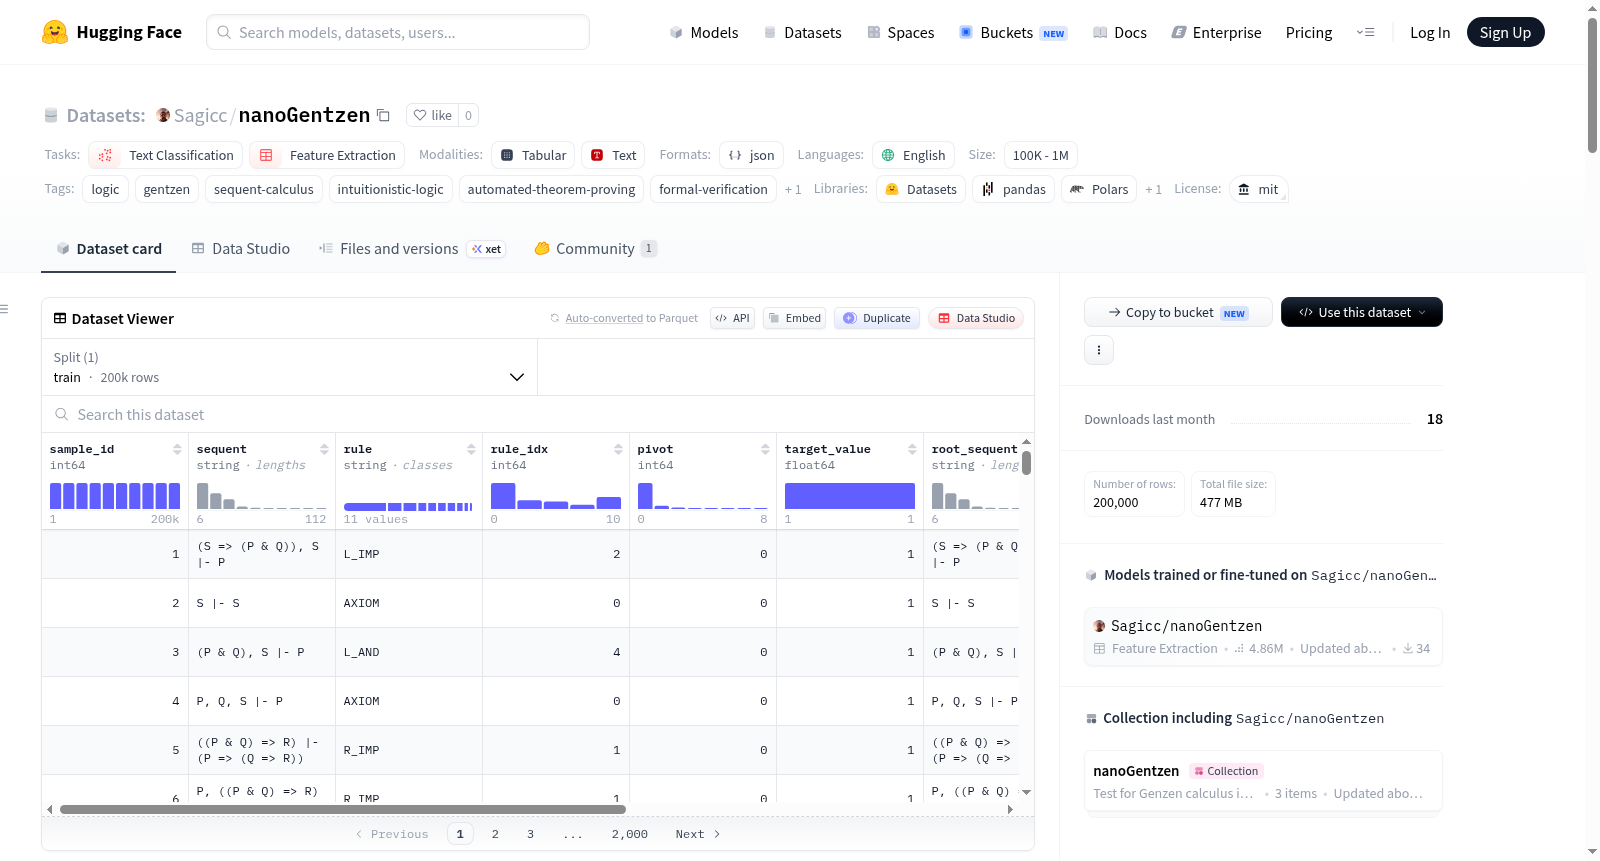
nanoGentzen 合成推导数据集(200k 转换)是一个为自动定理证明设计的形式化合成数据集,专注于直觉逻辑(LI)和经典逻辑(LK,通过 Glivenko 定理)的 Gentzen 序列演算。每条记录表示一个 AND-OR 证明搜索树中的单一状态-动作推导转换,提供多任务监督信号,用于推理规则选择、前件前提定位和分支可证明性估计。数据集包含 200,000 条转换记录,以 PyTorch 张量(.pt)和 JSON Lines(.jsonl)两种格式提供。每条记录包含字段:样本标识符、当前序列(sequent,形式字符串表示)、目标推理规则(如 AXIOM、R_IMP 等)、规则索引(0-10 的整数类别标签)、前件假设索引(pivot,0-15)、分支可证明性真值(target_value,0.0 或 1.0)、根定理(root_sequent)、推导步骤编号、总步骤数、token 化整数序列(input_ids)以及 token 长度。规则标签映射覆盖 11 种 Gentzen 规则:AXIOM(0)、R_IMP(1)、L_IMP(2)、R_AND(3)、L_AND(4)、R_OR_1(5)、R_OR_2(6)、L_OR(7)、R_NOT(8)、L_NOT(9)、L_CONTR(10)。数据集通过两种分布生成:30% 的硬定理模式(如传递性、假言推理、拒取式等)和 70% 的随机命题语法树(深度 1-3,前件前提 0-4),并通过确定性反向求解器验证(证明深度 ≤8,收缩预算=1)。该数据集适用于训练神经符号定理证明器、策略网络、价值网络以及序列到序列推理模型。
The nanoGentzen Synthetic Derivation Dataset (200k transitions) is a formal synthetic dataset designed for automated theorem proving, focusing on Gentzen sequent calculi for intuitionistic logic (LI) and classical logic (LK via Glivenkos theorem). Each record represents a single state-action derivation transition in an AND-OR proof search tree, providing multi-task supervision signals for inference rule selection, antecedent premise localization, and branch provability estimation. The dataset contains 200,000 transition records, available in both PyTorch tensor (.pt) and JSON Lines (.jsonl) formats. Each record includes fields: sample identifier, current sequent (string representation), target inference rule (e.g., AXIOM, R_IMP), rule index (integer category label 0-10), antecedent premise index (pivot, 0-15), branch provability truth value (target_value, 0.0 or 1.0), root theorem (root_sequent), derivation step number, total number of steps, tokenized integer sequence (input_ids), and token length. The rule label mapping covers 11 Gentzen rules: AXIOM (0), R_IMP (1), L_IMP (2), R_AND (3), L_AND (4), R_OR_1 (5), R_OR_2 (6), L_OR (7), R_NOT (8), L_NOT (9), L_CONTR (10). The dataset is generated via two distributions: 30% hard theorem patterns (e.g., transitivity, modus ponens, modus tollens) and 70% random propositional syntax trees (depth 1-3, antecedent premises 0-4), and verified by a deterministic backward solver (proof depth ≤8, contraction budget=1). This dataset is suitable for training neuro-symbolic theorem provers, policy networks, value networks, and sequence-to-sequence reasoning models.
数据集概述
nanoGentzen Synthetic Deduction Dataset 是一个用于自动定理证明的形式化合成数据集,专注于直觉主义逻辑(LI)和经典逻辑(LK,通过 Glivenko 定理)的 Gentzen 相继式演算。
基本信息
- 规模: 200,000 条推导转移记录(约 205 MB)
- 语言: 英语
- 许可证: MIT License
- 标注类型: 合成数据(synthetic)
- 任务类别: 文本分类、特征提取
- 标签: 逻辑、Gentzen、相继式演算、直觉主义逻辑、自动定理证明、形式化验证、神经符号
数据文件格式
| 文件 | 格式 | 规模/大小 | 描述 |
|---|---|---|---|
gentzen_dataset.pt |
PyTorch 二进制 | 200,000 行(~205 MB) | 预张量化的训练张量(input_ids、target_rule、target_pivot、target_value) |
gentzen_dataset.jsonl |
JSON Lines | 200,000 条转移记录 | 包含 AST 相继式和 token 序列的完整推导追踪记录 |
数据模式与字段定义
每条记录包含用于逆向 Gentzen 证明步骤监督的结构化元数据,字段如下:
sample_id(int): 训练转移步骤的唯一顺序索引sequent(str): 当前 Gentzen 相继式(形式化字符串表示,如Γ ⟶ Δ)rule(str): 目标推导规则(包括AXIOM,R_IMP,L_IMP,R_AND,L_AND,R_OR_1,R_OR_2,L_OR,R_NOT,L_NOT,L_CONTR)rule_idx(int): 规则策略头的离散整数类别标签(0 到 10)pivot(int): 左侧规则针对的 Γ 中前提假设的索引(0 到 15)target_value(float): 分支可证明性真值,范围[0.0, 1.0](1.0表示在 LI 中可构造性证明,0.0表示不可证明的反模型)root_sequent(str): 推导出该子目标的顶层目标定理trace_step(int): 当前逆向归约路径中的步骤编号total_trace_steps(int): 完整证明推导的总归约步数input_ids(List[int]): 使用LogicTokenizer对sequent字符串编码生成的 token 化整数序列(映射到vocab.json)token_length(int): 填充前的有效 token 序列长度
规则标签映射
rule_idx |
规则符号 | 名称 | 形式化相继式归约 |
|---|---|---|---|
0 |
AXIOM |
恒等/爆炸公理 | Γ, A ⊢ A 或 0, Γ ⊢ Δ |
1 |
R_IMP |
右蕴含 | Γ ⊢ (A ⇒ B) ⟹ A, Γ ⊢ B |
2 |
L_IMP |
左蕴含 | (A ⇒ B), Γ ⊢ Δ ⟹ Γ ⊢ A 和 B, Γ ⊢ Δ |
3 |
R_AND |
右合取 | Γ ⊢ (A & B) ⟹ Γ ⊢ A 和 Γ ⊢ B |
4 |
L_AND |
左合取 | (A & B), Γ ⊢ Δ ⟹ A, B, Γ ⊢ Δ |
5 |
R_OR_1 |
右析取 1 | Γ ⊢ (A |
6 |
R_OR_2 |
右析取 2 | Γ ⊢ (A |
7 |
L_OR |
左析取 | (A |
8 |
R_NOT |
右否定 | Γ ⊢ ~A ⟹ A, Γ ⊢ 0 |
9 |
L_NOT |
左否定 | ~A, Γ ⊢ Δ ⟹ Γ ⊢ A |
10 |
L_CONTR |
左收缩 | 重复假设 Γ[i] 用于多前提定理 |
生成方法
使用并行 CPU 工作池合成 200,000 个样本,涵盖两种生成分布:
- 硬定理模式(30% 分布权重): 固定结构定理模式(传递性、肯定前件、否定后件、构造性德摩根、Glivenko 收缩定理)
- 随机命题语法树(70% 分布权重): 深度 1 到 3 递归生成的公式,Γ 中 0 到 4 个前提;通过确定性逆向求解器穷举验证,证明深度预算 ≤ 8,收缩预算 = 1
加载方式
支持三种加载方式:
- PyTorch 张量加载器 (
gentzen_dataset.pt): 直接匹配train.py中DataLoader的输入字典,张量形状为input_ids(200000, 256),target_rule、target_pivot、target_value形状均为 (200000,) - JSON Lines 加载器 (
gentzen_dataset.jsonl): 逐行解析 JSON 记录 - Hugging Face Datasets Hub: 使用
load_dataset("json", data_files="data/gentzen_dataset.jsonl")加载
设计目标
该数据集专为训练 Policy-Value Transformer 设计,用于自动定理证明,每条记录表示 AND-OR 证明搜索树上的单一状态-动作推导转移,为推理规则选择、前提定位和分支可证明性估计提供多任务监督信号。