
遇见数据集

nemotron-code-oracle-filtered-qwen3.5-122b-131k-opencode-sft-serveparity

收藏
Hugging Face2026-07-21 更新2026-07-22 收录
官方服务:

资源简介:

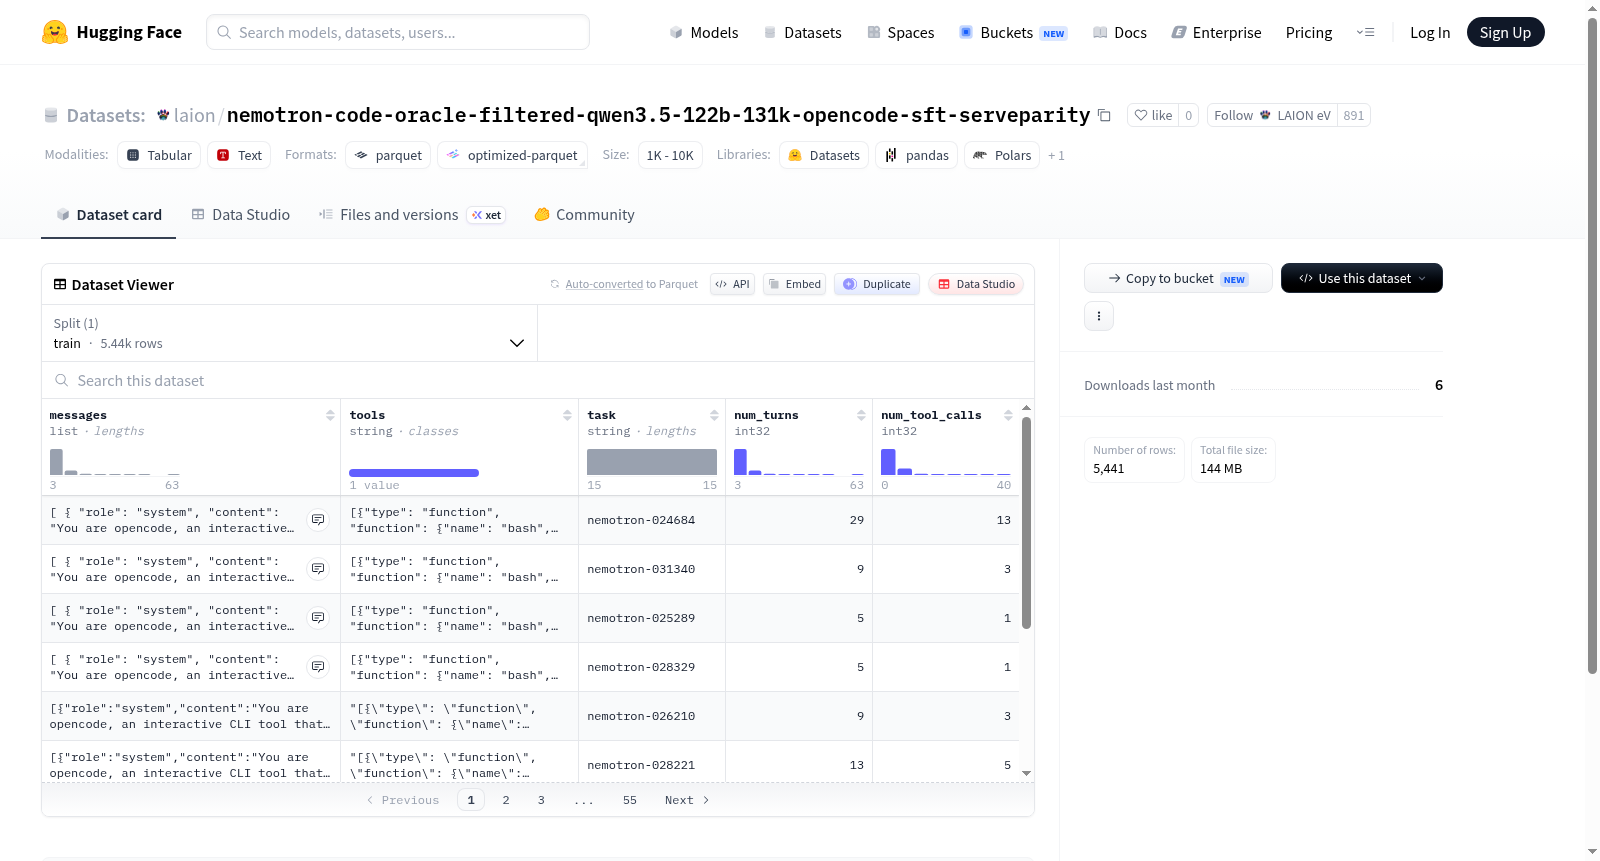
该数据集是一个专门为工具调用(函数调用)任务设计的对话数据集。数据集包含5,441个训练样本,总大小约259MB。每个样本包含以下核心字段:1)messages:多轮对话消息列表,每条消息包含角色(role)、内容(content)和可选的工具调用记录(tool_calls);2)tools:工具定义信息;3)task:任务类型标识;4)num_turns:对话轮数;5)num_tool_calls:工具调用次数。其中tool_calls字段详细记录了函数调用的类型(type)和具体函数信息(包括函数名name和参数arguments)。数据集适用于训练和评估支持工具调用的对话系统,特别是需要理解用户指令、选择适当工具并执行函数调用的场景。

This is a dialogue dataset specifically tailored for tool calling (function calling) tasks. It contains 5,441 training samples with a total size of approximately 259 MB. Each sample includes the following core fields: 1) messages: a list of multi-turn dialogue messages, where each message contains a role, content, and an optional tool call record (tool_calls); 2) tools: tool definition information; 3) task: task type identifier; 4) num_turns: number of dialogue turns; 5) num_tool_calls: number of tool calls. The tool_calls field specifically records the type of function call (type) and specific function information including the function name (name) and parameters (arguments). This dataset is applicable for training and evaluating dialogue systems that support tool calling, particularly scenarios requiring the understanding of user instructions, selection of appropriate tools, and execution of function calls.
提供机构:
LAION eV
创建时间:
2026-07-21
搜集汇总
数据集介绍
nemotron-code-oracle-filtered-qwen3.5-122b-131k-opencode-sft-serveparity 数据集图片
构建方式
该数据集名为nemotron-code-oracle-filtered-qwen3.5-122b-131k-opencode-sft-serveparity,其构建过程融合了多阶段筛选与精细格式化技术。原始数据源自OpenCode语料库,经Qwen3.5-122B模型进行初步生成与过滤,剔除了低质量或重复样本。随后,通过Oracle验证机制对代码生成结果进行功能性校验,确保样例具备实效性。最终,数据以对话形式组织,每条记录包含多轮消息(messages)、工具调用信息(tool_calls)、关联工具声明(tools)、任务类型(task)及交互轮次统计,结构清晰且适配指令微调场景。
特点
数据集的核心特点体现在其高度结构化的对话格式与工具增强能力。每条样本包含角色交替的对话记录,支持多轮交互与函数调用(tool_calls),可模拟真实环境中智能体与工具的协作流程。工具定义以JSON字符串形式独立存储,便于下游模型学习调用外部API。此外,数据规模达5441条训练样本,总大小约259MB,涵盖多样化的编程任务,且通过过滤保证了响应与上下文的语义一致性,特别适合用于训练具备代码生成与工具使用能力的对话模型。
使用方法
该数据集专为监督式微调(SFT)设计,可直接加载至HuggingFace的Datasets库进行使用。用户可通过指定配置名'default'读取训练分割,获取包含'messages'、'tools'、'task'等字段的样本。在训练中,需将对话消息序列化为模型输入,并利用'tool_calls'字段监督模型在适当时刻生成函数调用。建议配合支持多轮对话与工具调用的框架(如Transformers或vLLM),并参考OpenCode协议进行任务适配。数据已按标准格式打包于'data/train-*'文件中,便于分片加载。
背景与挑战
背景概述
该数据集名为nemotron-code-oracle-filtered-qwen3.5-122b-131k-opencode-sft-serveparity,由NVIDIA研究团队于2024年创建,旨在推动代码生成领域的大语言模型对齐研究。其核心研究问题聚焦于如何通过高质量指令微调数据提升模型在复杂编程任务中的工具调用与多轮对话能力。数据集通过筛选OpenCode数据集并联合Qwen3.5-122B模型进行服务等价性过滤,确保样本的实用性和准确性,为代码智能体训练提供了宝贵资源。该数据集的发布对代码智能体、工具增强型语言模型及服务等价性评估领域产生了深远影响,促进了模型在真实编程场景中的泛化能力与稳定性研究。
当前挑战
数据集当前面临多层次的挑战。在领域问题层面,核心挑战在于如何弥合大语言模型在代码生成中的语义理解与执行结果之间的偏差,尤其在多轮交互中需精准解析用户意图并调用适当工具。构建过程中,数据筛选面临工具调用序列的复杂性与多样性,需从海量代码数据中提取高执行一致性的样本,同时确保多轮对话的上下文连贯性。此外,服务等价性过滤需平衡模型输出与真实服务的执行匹配度,避免引入噪声或过度约束,这对数据质量控制和评估标准提出了严格挑战。
常用场景
经典使用场景
该数据集聚焦于代码智能与工具调用领域,为多轮对话中函数级代码生成与工具编排任务提供了高质量的训练语料。其核心设计围绕“消息-工具-任务”三元结构展开,每条样本包含完整的对话历史、预定义工具集合以及对应的任务标签,特别适合用于微调大语言模型使其具备精确理解工具描述、自动规划调用顺序并生成符合语法规范的函数参数的能力。这一设计使其成为研究代码生成、API调用决策与多步骤任务拆解等经典场景的基石性资源。
解决学术问题
该数据集系统性地解决了现有代码语料库在工具调用结构化建模方面的空白。传统代码数据集多聚焦于单一函数的生成或补全,缺乏对复杂工具调用链、多轮交互状态跟踪以及参数类型约束的建模。本数据集通过引入显式的工具描述字段与多轮工具调用记录,使研究者能够深入探索模型在外部工具依赖环境下的推理能力,有效推动了面向服务编排的代码生成、上下文感知的函数选择以及工具调用闭环验证等前沿学术问题的突破。
衍生相关工作
基于该数据集的数据结构和设计理念,衍生出了一系列具有影响力的研究工作。在数据层面,研究者借鉴其“工具描述-对话轮次”的标注范式,构建了面向特定领域(如金融交易、医疗诊断)的工具调用专用数据集。在模型层面,有工作提出基于此数据的高效微调策略,通过对比不同工具排列顺序对生成准确率的影响,揭示了上下文放缩法则在工具调用任务中的适用性。同时,该数据集也被用于评估开源与闭源模型在函数级代码召回率上的差异,催生了面向工具调用的基准测试框架及检索增强生成方法的改进方案。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

