
SlideRL
收藏资源简介:
SlideRL是由塔夫斯公司、德克萨斯大学达拉斯分校和德克萨斯农工大学联合构建的开源数据集,包含288条多轮次轨迹数据,覆盖6种大型语言模型在48个商业演示任务中的完整生成过程。该数据集记录了每轮工具调用、环境观察、步骤奖励和质量评分,旨在支持智能体在幻灯片自动生成任务中的强化学习研究。数据通过Claude Opus 4.6生成的专家轨迹进行标注,应用于评估模型在内容规划、视觉设计和逆向规范奖励等方面的表现,为复杂创意任务的工具使用与多维度质量评估提供基准。
SlideRL is an open-source dataset jointly constructed by Tufts Company, The University of Texas at Dallas, and Texas A&M University. It contains 288 multi-turn trajectory samples, covering the complete generation processes of 6 large language models (LLMs) across 48 commercial demonstration tasks. The dataset records per-round tool calls, environmental observations, step rewards, and quality scores, with the goal of supporting reinforcement learning research on AI Agents for automated slide generation tasks. All data is annotated using expert trajectories generated by Claude Opus 4.6, and is utilized to evaluate model performance in content planning, visual design, inverse normative reward, and other related domains. It serves as a benchmark for tool usage and multi-dimensional quality assessment in complex creative tasks.
SlideRL Multi-Turn Rollouts 数据集概述
数据集基本信息
- 许可证: MIT
- 任务类别: 文本生成、强化学习
- 标签: sliderl, multi-turn, rollouts, tool-use, presentation-generation, grpo, rl
- 数据集名称: SlideRL Multi-Turn Rollouts
- 数据规模: n<1K
数据集内容
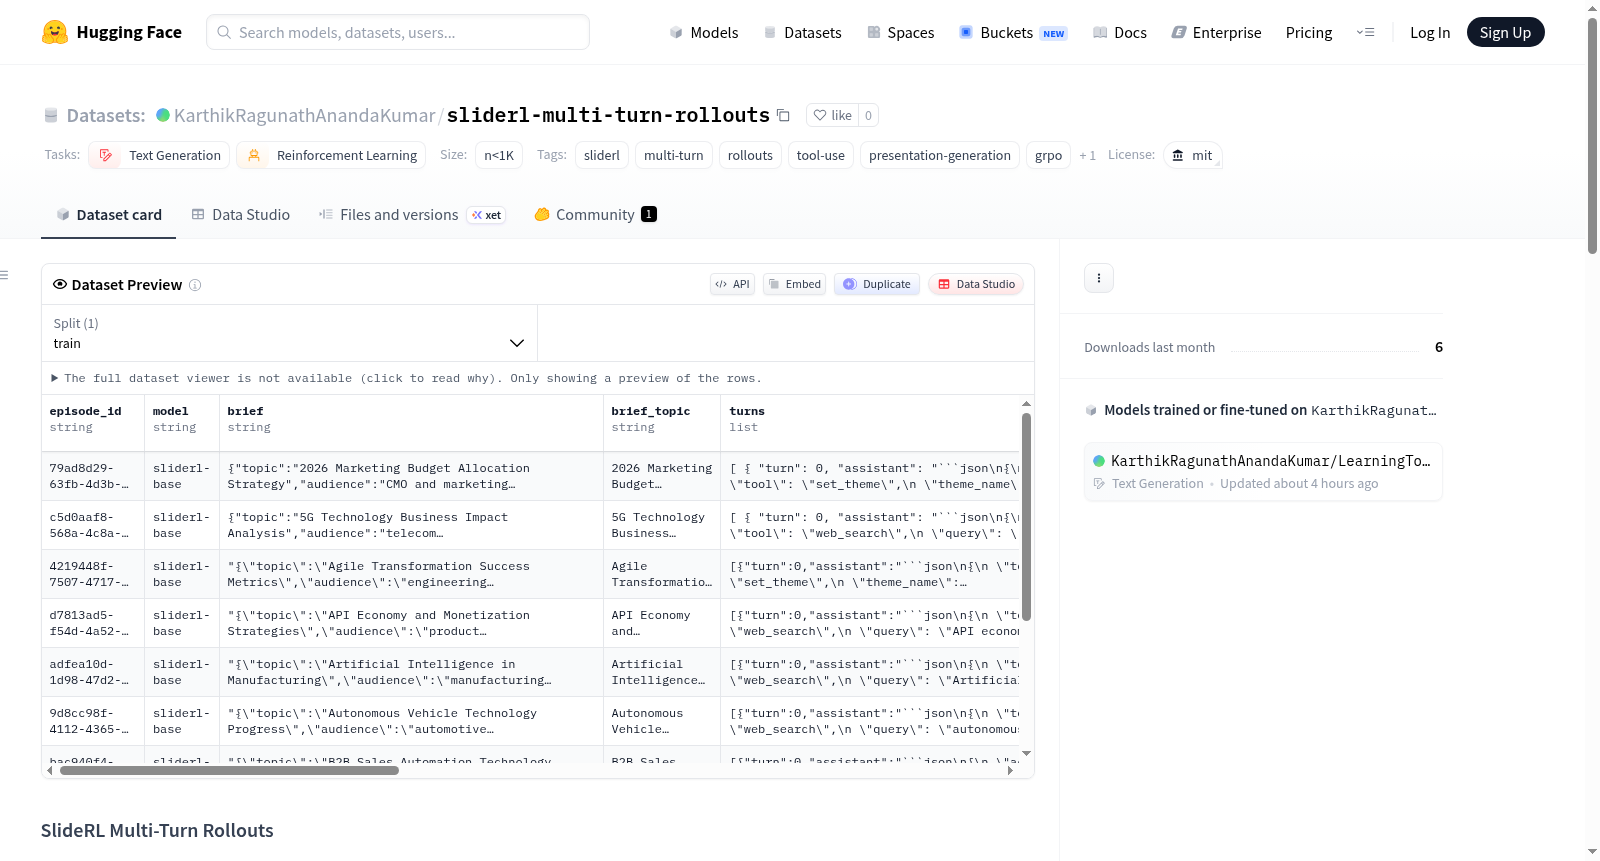
该数据集包含来自 SlideRL 环境的多轮交互轨迹,涵盖了6个不同模型。每条轨迹记录了智能体在 SlideRL 幻灯片生成环境中通过多轮工具使用进行交互的过程。
包含的模型与文件
数据集包含以下6个JSON文件,每个文件包含48个交互轨迹:
| 文件 | 模型 | 轨迹数量 | 描述 |
|---|---|---|---|
claude_opus_4_6_trajectories.json |
Claude Opus 4.6 | 48 | Anthropic Claude Opus 4.6 |
claude_sonnet_4_6_trajectories.json |
Claude Sonnet 4.6 | 48 | Anthropic Claude Sonnet 4.6 |
llama_4_scout_trajectories.json |
Llama 4 Scout | 48 | Meta Llama 4 Scout |
gpt_oss_120b_trajectories.json |
GPT-OSS-120B | 48 | OpenAI GPT-OSS-120B |
finetuned_model_trajectories.json |
SlideRL Finetuned | 48 | GRPO微调后的模型 |
base_model_trajectories.json |
SlideRL Base | 48 | 微调前的基座模型 |
轨迹数据结构
每个JSON文件包含一个轨迹列表,每个轨迹包含以下字段:
episode_id: 唯一标识符model: 模型名称brief: 任务简报,包含主题、受众、幻灯片数量等信息brief_topic: 主题名称turns: 交互轮次列表,每轮包含:turn: 轮次编号assistant: 模型响应文本tool_call: 工具调用信息observation: 环境反馈success: 是否成功phase: 当前阶段(RESEARCH|PLAN|BUILD|REFINE)slide_count: 幻灯片数量done: 是否完成step_reward: 单步奖励cumulative_reward: 累计奖励
total_steps: 总步数final_phase: 最终阶段completed: 是否完成slides_created: 创建的幻灯片数量cumulative_reward: 累计奖励final_quality: 最终质量评估slides_html: 幻灯片HTML代码列表elapsed_seconds: 耗时(秒)
环境描述
SlideRL 环境是一个多轮工具使用环境,智能体通过以下步骤创建演示文稿幻灯片:
- 研究: 通过网络搜索研究主题
- 规划: 制定大纲
- 构建: 使用HTML/CSS创建幻灯片
- 优化: 优化幻灯片质量
智能体通过结构化工具调用(web_search、create_outline、set_theme、add_slide、replace_slide、delete_slide等)进行交互,并接收带有质量反馈的环境观察结果。
评估主题
所有模型均在相同的48个商业演示简报上进行评估,主题涵盖金融、技术、营销、网络安全、医疗保健等领域。
项目背景
该数据集是 SlideRL 项目的一部分——一个用于在多轮工具使用任务上训练LLM智能体的开放式强化学习环境。
- 1Learning to Present: Inverse Specification Rewards for Agentic Slide Generation塔夫斯公司; 德克萨斯大学达拉斯分校; 德克萨斯农工大学 · 2026年


