
遇见数据集

sahilmaniyar888/Indian_Climate_Disaster_data

收藏
Hugging Face2026-04-30 更新2026-05-03 收录
官方服务:

资源简介:

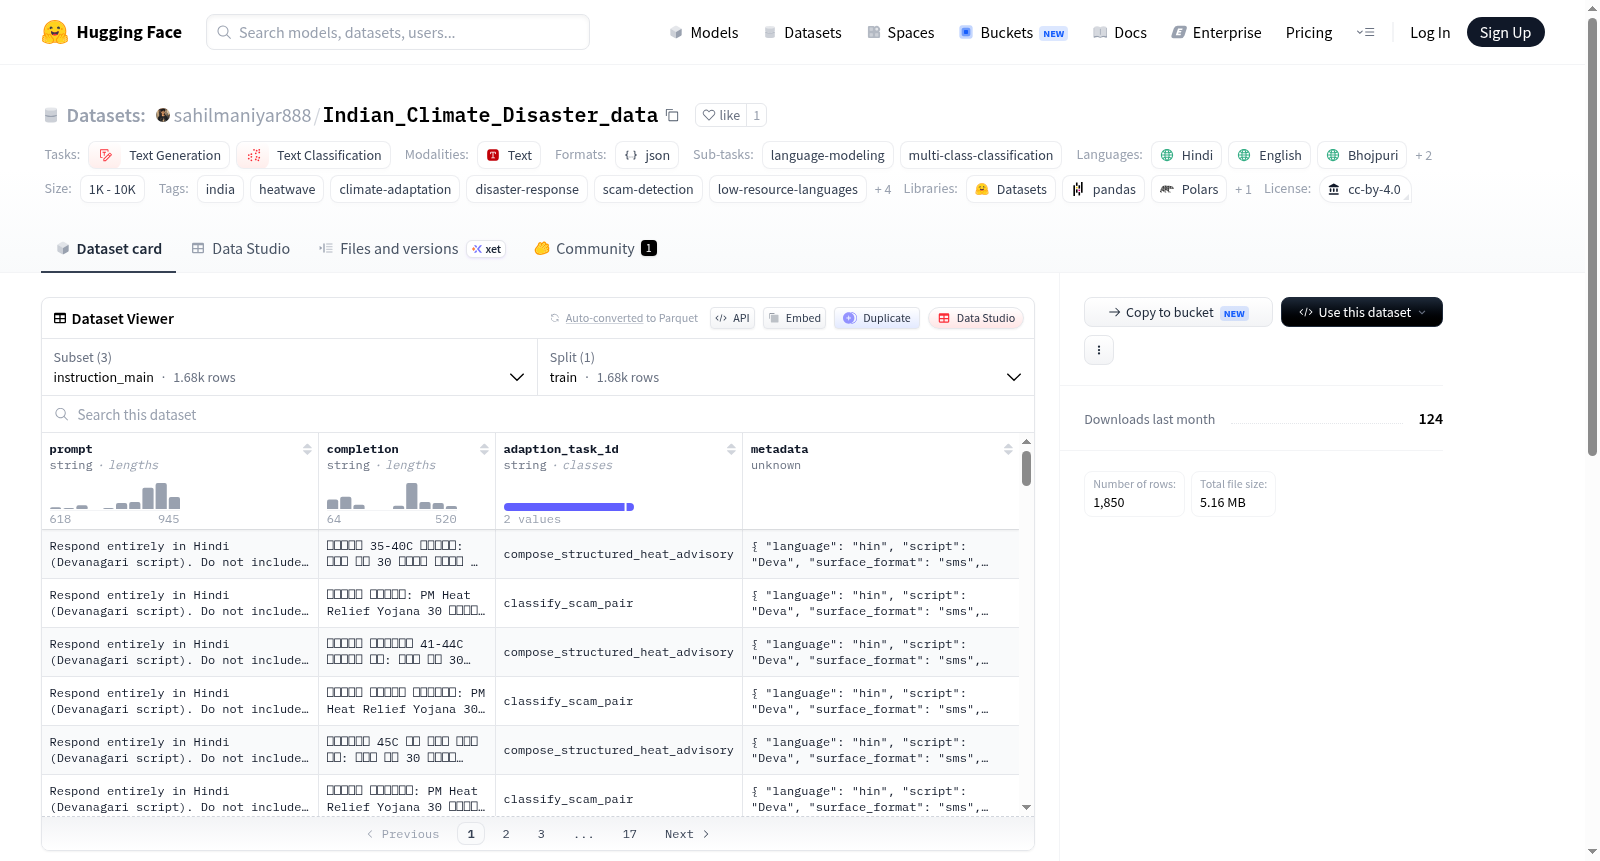
BharatCRIC印度气候灾害数据集(热浪建议+诈骗对)是一个多语言数据集,包含印度多个地区的热浪建议和诈骗对。数据集支持印地语、英语、博杰普尔语、迈蒂利语和桑塔利语(Ol Chiki脚本),覆盖比哈尔邦、北方邦和贾坎德邦等地区。数据集包含结构化指令上传、烟雾测试和真实的与诈骗的偏好对。数据集适用于文本生成和文本分类任务,特别是语言建模和多类分类。数据集的文件包括完整的结构化指令上传、50行的烟雾测试、以及真实的与诈骗的偏好对。数据集严格遵守验证热线仅在真实行中的规则,诈骗行明确标记为`variant_type=heat_scam`并包含故意的假号码/支付/OTP标记。桑塔利行仅通过手动/本地验证,没有自动扩展。

BharatCRIC: Indian Climate Disaster Data (Heatwave Advisories + Scam Pairs) is a multilingual dataset containing heatwave advisories and scam pairs from various regions in India. The dataset supports Hindi, English, Bhojpuri, Maithili, and Santali (Ol Chiki script), covering states like Bihar, Uttar Pradesh, and Jharkhand. It includes structured instruction uploads, smoke tests, and genuine-vs-scam preference pairs. The dataset is designed for text-generation and text-classification tasks, specifically language modeling and multi-class classification. The files include full structured instruction uploads, a 50-row smoke test, and mirrored genuine-vs-scam preference pairs. The dataset adheres to strict rules: validated helplines only in genuine rows; scam rows are explicitly tagged `variant_type=heat_scam` and carry intentional fake-number/payment/OTP markers. Santali rows are manual/native-validated only, with no automatic Adaption expansion.
提供机构:
sahilmaniyar888
搜集汇总
数据集介绍
sahilmaniyar888/Indian_Climate_Disaster_data 数据集图片
构建方式
BharatCRIC印度气候灾害数据集由脚本“grade_a_rebuild.py”依据蓝图“grade_a_2026_04_30”自动生成。该数据集以指令微调为核心,构建了包含1680条样本的完整结构化指令数据集、50条样本的烟雾测试集(涵盖5种语言×5种格式×2个样本的均匀分布),以及120对真实与诈骗镜像偏好对。每一条真实数据均经过严格验证,仅收录有效的求助热线号码;诈骗数据则明确标注“variant_type=heat_scam”,并植入虚假号码、支付或OTP诱导信息。桑塔利语条目完全由母语者手工验证,未采用自动扩展,以确保高危场景下的数据准确性。
使用方法
该数据集提供三种配置供用户调用:配置“instruction_main”加载训练集主指令文件“instruction_dataset_main.jsonl”,适合完整训练;“instruction_smoke”加载烟雾测试集“instruction_dataset_smoke.jsonl”,可用于快速验证流程;配置“preference_pairs”加载诈骗偏好对文件“preference_pairs_scams.jsonl”,适用于对比学习或偏好排序任务。数据均以JSONL格式存储,可直接用于文本生成与文本分类模型,支持在低资源语言场景下进行语言建模或多类分类实验。
背景与挑战
背景概述
在气候变化日益严峻的背景下,热浪等极端天气事件对南亚地区,尤其是印度人口稠密的比哈尔邦、北方邦和贾坎德邦,构成了严重威胁。该区域语言多样且资源匮乏,加之灾害响应信息中频繁出现的诈骗活动,使得有效的气候适应与灾害应对面临巨大挑战。BharatCRIC Indian Climate Disaster Data数据集由专业团队于近期创建,其核心研究问题聚焦于构建一个多语言、多格式的热浪预警与诈骗检测的指令数据集,涵盖印地语、英语、博杰普尔语、迈蒂利语及桑塔利语(使用Ol Chiki文字)五种语言,并包含短信、WhatsApp、官方公告、广播脚本及社区帖子五种表面格式。该数据集作为Adaption Uncharted Data Challenge的一部分,不仅为低资源语言的自然语言处理研究提供了宝贵资源,也为气候适应与灾害响应中的信息真实性验证领域树立了新的标杆,对推动相关领域的技术进步与社会应用具有显著影响力。
当前挑战
该数据集所解决的领域问题挑战在于,现有资源缺乏针对印度本土多语言环境下热浪预警信息的结构化数据集,且灾害信息中广泛存在的诈骗内容严重干扰了公众的准确判断与响应。构建过程中也遇到诸多挑战:其一,必须确保桑塔利语条目仅通过人工与母语者验证,严格避免自动化扩展,以维护语言的原生性与准确性;其二,需设计硬性规则,在真实条目中仅收录经过验证的求助热线,而在诈骗条目中明确标记为“heat_scam”并嵌入虚假号码、付款或OTP标记,实现真实与诈骗样本的镜像对照;其三,面对五种语言与五种格式的交叉组合,要生成结构统一的指令数据集,同时保持语法与文化的适应性,这对数据质量与一致性提出了极高要求。
常用场景
经典使用场景
在气候变化与灾害应对的交叉领域,Indian Climate Disaster Data数据集为多语言、低资源环境下的热浪预警文本建模提供了独特的基准资源。其经典使用场景在于构建面向印度北部比哈尔、北方邦及贾坎德邦等受极端高温严重影响地区的灾害信息生成与分类系统。研究人员可利用该数据集训练语言模型,以自动产生结构化的官方预警公告、社区公告、广播脚本及即时通讯消息等多种体裁的文本,同时实现预警信息中真实救助渠道与诈骗信息的精准识别,从而在信息匮乏的方言社区中建立可靠的灾害沟通管道。
解决学术问题
该数据集核心解决了低资源印度语言(如博杰普尔语、迈蒂利语、桑塔利语)在灾害文本处理领域标注数据稀缺的学术困境。传统气候适应研究多集中于英语等主流语言,忽视了多语社会边缘群体的信息可达性。BharatCRIC通过专家与机器协同生成的高质量标注,首次为热浪场景下的多语言指令遵循、多类别欺诈检测及偏好对齐提供了可控实验平台。其设计使研究者能够系统探究非对称信息环境下欺诈文本的语言学特征,并验证小样本条件下跨语言迁移学习的有效性,推动了语言技术与公共安全交叉领域的实证进展。
实际应用
在实际应用层面,该数据集直接服务于印度政府及非政府组织构建的社区级热浪预警系统。具体而言,其生成的模型可被部署于WhatsApp与短信广播平台,自动将官方英文警报翻译并适配为当地方言的多格式通知,同时过滤嵌入虚假求助电话或支付链接的诈骗信息。在比哈尔邦的农村试点中,此类工具显著缩短了预警从发布到方言社区触达的响应时间,并降低了弱势群体遭受次生诈骗的风险。此外,基于偏好对数据的模型优化还可用于评估不同人机交互界面中预警信息的可信度,从而提升公众对官方渠道的依赖程度。
数据集最近研究
最新研究方向
该数据集聚焦印度低资源语言区域的气候灾害响应与诈骗检测交叉前沿,通过构建包含热浪预警指令及真假诈骗偏好对的多语料库,推动多模态文本生成与分类任务在灾害治理中的应用。其特色在于融合印地语、比哈尔语、迈蒂利语及桑塔利文书写的桑塔利语等少数民族语言,引入严格验证的官方求助热线与虚构欺诈标记的对比机制,为低资源环境下灾害谣言识别、自适应预警系统开发提供了稀缺的标注基准。结合印度比哈尔、北方邦、贾坎德邦等热浪频发地区的实际场景,该数据集的发布正助力构建鲁棒性更强的气候适应语言模型,支撑灾后信息可信度评估与多语种紧急通信策略的实证研究,对提升南亚地区数字鸿沟下的防灾韧性具有范式意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

