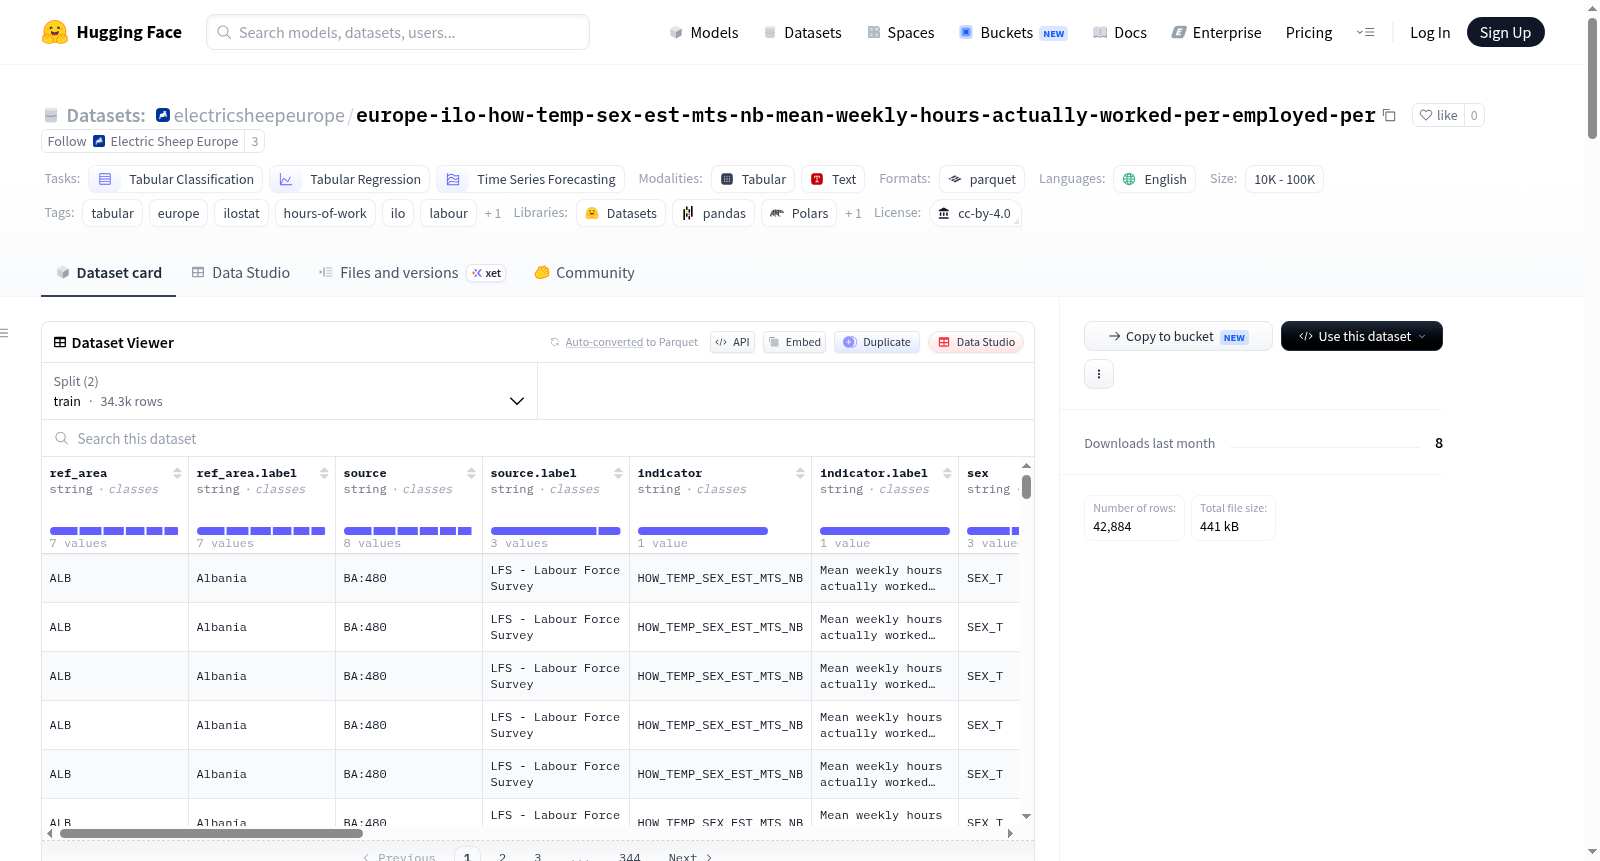
electricsheepeurope/europe-ilo-how-temp-sex-est-mts-nb-mean-weekly-hours-actually-worked-per-employed-per
收藏资源简介:
该数据集包含来自国际劳工组织(ILO)ILOSTAT数据库的欧洲国家工作时间统计数据,具体指标为‘按性别、企业规模和婚姻状况统计的就业人员平均每周实际工作时间’。数据集涵盖9个欧洲国家(阿尔巴尼亚、奥地利、波斯尼亚和黑塞哥维那、捷克、希腊、北马其顿、摩尔多瓦、塞尔维亚、斯洛伐克),时间跨度为1992年至2025年,共包含42,884个观测值。数据通过ILOSTAT REST API获取,并经过 harmonisation 处理以确保国际可比性。数据集结构包括国家代码、数据来源、指标代码、性别分类(总计、男性、女性)、企业规模分类、婚姻状况分类、观测年份、观测值(平均每周工作时间,单位为小时)以及数据状态标志等字段。数据频率为年度,适用于表格分类、回归和时间序列预测等任务。
license: 知识共享署名4.0(cc-by-4.0) language: - 英语(en) task_categories: - 表格分类(tabular-classification) - 表格回归(tabular-regression) - 时间序列预测(time-series-forecasting) multilinguality: 单语言(monolingual) size_categories: - 10K<n<100K tags: - 表格数据(tabular) - 欧洲(europe) - ILOSTAT - 工作时长(hours-of-work) - 国际劳工组织(ilo) - 劳工(labour) - 就业(employment) pretty_name: "按性别、企业规模与婚姻状况分的欧洲就业人员周均实际工作时长(ILOSTAT)" --- # 按性别、企业规模与婚姻状况分的欧洲就业人员周均实际工作时长(ILOSTAT) 🇪🇺 **42,884 条观测数据** · **9个欧洲国家** · **1992–2025年** · *由[Electric Sheep Europe](https://huggingface.co/electricsheepeurope)重新整理*      ## 简短摘要(TL;DR) 本数据集包含**42,884条观测数据**,涵盖**9个欧洲国家**的**工作时长(Hours of work)**数据,时间跨度为**1992–2025年**,仅包含**1项独立指标**。 ## 数据源说明 **国际劳工组织统计数据库(ILOSTAT)** 是国际劳工组织(ILO)的核心统计数据库,也是全球领先的劳工统计权威来源。其收录的指标覆盖就业、失业、工资、工作时长、童工、非正规经济、社会保障、职业伤害以及可持续发展目标(Sustainable Development Goals, SDG)体面工作目标等领域,数据来源于全国劳动力调查、家庭收入调查、企业调查与行政记录。该数据库覆盖全球200余个经济体,由国际劳工组织统计司负责数据的标准化整合。 - **原始数据源**:[ILOSTAT](https://www.ilo.org/shinyapps/bulkexplorer/?id=HOW_TEMP_SEX_EST_MTS_NB) - **发布方**:国际劳工组织(ILO) - **许可协议**:[知识共享署名4.0(cc-by-4.0)](https://creativecommons.org/licenses/by/4.0/) - **主题**:工作时长 ## 数据处理方法 本数据集直接从ILOSTAT的REST API接口`https://rplumber.ilo.org/data/indicator?id=HOW_TEMP_SEX_EST_MTS_NB`拉取原始数据,并筛选出欧洲地区的ISO 3166-1 alpha-3国家编码数据。ILOSTAT采用国际劳工统计学家会议(International Conference of Labour Statisticians, ICLS)的定义对原始调查微观数据进行标准化整合;数据来源信息将在`source.label`字段中标记,以确保可追溯性。 ## 地理覆盖范围 9个欧洲国家,以下按数据行数排序展示前几行示例: | 国家 | 行数 | 起始年份 | 结束年份 | |---------|-----:|-----------:|----------:| | `MDA` | 7,678 | 2003 | 2025 | | `MKD` | 6,292 | 2007 | 2025 | | `CZE` | 6,229 | 1998 | 2020 | | `AUT` | 5,808 | 2004 | 2025 | | `BIH` | 5,364 | 2001 | 2020 | | `ALB` | 4,670 | 2007 | 2024 | | `SRB` | 4,336 | 2007 | 2020 | | `SVK` | 2,003 | 2001 | 2020 | | `GRC` | 504 | 1992 | 2005 | ## 指标示例 - `HOW_TEMP_SEX_EST_MTS_NB` — 按性别、企业规模与婚姻状况分的就业人员周均实际工作时长 ## 数据架构 | 字段名 | 数据类型 | 字段说明 | 示例值 | |--------|------|-------------|---------| | `ref_area` | `string` | ISO 3166-1 alpha-3 国家代码 | `ALB` | | `ref_area.label` | `string` | 英文国家名称 | `阿尔巴尼亚(Albania)` | | `source` | `string` | ILOSTAT 数据源代码(如劳动力调查(Labour Force Survey, LFS)) | `BA:480` | | `source.label` | `string` | 英文数据源名称 | `LFS - 劳动力调查` | | `indicator` | `string` | ILOSTAT 指标代码 | `HOW_TEMP_SEX_EST_MTS_NB` | | `indicator.label` | `string` | 英文指标名称 | `Mean weekly hours actually worked per…` | | `sex` | `string` | 性别分组维度(SEX_T=总计,SEX_M=男性,SEX_F=女性) | `SEX_T` | | `sex.label` | `string` | 分组维度说明 | `总计` | | `classif1` | `string` | 第一分类变量(年龄、教育程度、就业状态等) | `EST_AGGREGATE_TOTAL` | | `classif1.label` | `string` | 分类变量说明 | `企业规模(总计)` | | `classif2` | `string` | 可选第二分类变量 | `MTS_AGGREGATE_TOTAL` | | `classif2.label` | `string` | 分类变量说明 | `婚姻状况(总计)` | | `time` | `int64` | 观测年份 | `2024` | | `obs_value` | `float64` | 观测指标值(单位详见指标定义) | `41.33` | | `obs_status` | `string` | 观测状态标记(如暂定、不可靠) | `U` | | `obs_status.label` | `string` | 状态标记说明 | `不可靠` | | `note_indicator` | `string` | 指标备注代码 | `T11:142` | | `note_indicator.label` | `string` | 备注说明 | `工作覆盖范围:当前从事的主要工作` | | `note_source` | `string` | 数据源备注代码 | `R1:3513` | | `note_source.label` | `string` | 备注说明 | `存储库:ILO统计司 - 微观数据…` | ## 分组维度 以下字段提供数据分组维度: - **`sex`**(共3个唯一取值):`SEX_T`、`SEX_M`、`SEX_F` ## 数据质量与注意事项 - 本数据集采用年度频率数据,部分指标同时发布月度或季度序列,但本数据集未包含此类数据。 - 当同一国家×年份的同一指标存在多个数据源时,将采用国际劳工组织选定的“最优数据源”。 - 分组字段(`sex`、`classif1`、`classif2`)仅在指标支持对应分组时才会非空。 ## 使用方法 python from datasets import load_dataset ds = load_dataset("electricsheepeurope/europe-ilo-how-temp-sex-est-mts-nb-mean-weekly-hours-actually-worked-per-employed-per") df = ds["train"].to_pandas() print(df.head()) ### 筛选单个国家数据 python germany = df[df["ref_area"] == "DEU"] ### 单个指标的时间序列数据 python sample = (df[df["indicator"] == "HOW_TEMP_SEX_EST_MTS_NB"] .sort_values("time")) sample.plot(x="time", y="obs_value", title="HOW_TEMP_SEX_EST_MTS_NB") ### 转换为国家×年份矩阵 python matrix = (df[df["indicator"] == "HOW_TEMP_SEX_EST_MTS_NB"] .pivot_table(index="time", columns="ref_area", values="obs_value")) print(matrix.tail()) ## 引用格式 bibtex @misc{europe_ilo_how_temp_sex_est_mts_nb_mean_weekly_hours_actually_worked_per_employed_per_2025, title = {Mean weekly hours actually worked per employed person by sex, establishment size and marit | Europe (ILOSTAT)}, author = {International Labour Organization (ILO)}, year = {2025}, url = {https://www.ilo.org/shinyapps/bulkexplorer/?id=HOW_TEMP_SEX_EST_MTS_NB}, publisher = {HuggingFace Datasets, repackaged by Electric Sheep Europe}, howpublished = {url{https://huggingface.co/datasets/electricsheepeurope/europe-ilo-how-temp-sex-est-mts-nb-mean-weekly-hours-actually-worked-per-employed-per}} } ## 许可协议 本数据集采用[知识共享署名4.0(cc-by-4.0)](https://creativecommons.org/licenses/by/4.0/)许可协议发布。 原始数据版权归国际劳工组织(ILO)所有。使用本数据集时,请同时引用上述原始数据源与Electric Sheep Europe的重新整理版本。 ## 关于Electric Sheep Electric Sheep Europe是Electric Sheep项目的一部分,该项目旨在构建面向欧洲地区的统一、可直接用于机器学习的数据集层,托管于HuggingFace平台。我们从权威开源数据源拉取数据,对数据架构进行标准化处理,以Parquet格式打包,并发布为格式统一的数据集卡片,使研究人员与开发者可通过`load_dataset()`函数在数秒内开始使用数据。 浏览完整数据集集合:[huggingface.co/electricsheepeurope](https://huggingface.co/electricsheepeurope) --- _数据溯源:2026年5月27日通过Electric Sheep数据管道完成数据摄取。源URL:https://www.ilo.org/shinyapps/bulkexplorer/?id=HOW_TEMP_SEX_EST_MTS_NB_