
遇见数据集

AmazonQAC

收藏
Hugging Face2024-10-23 更新2024-12-12 收录
官方服务:

资源简介:

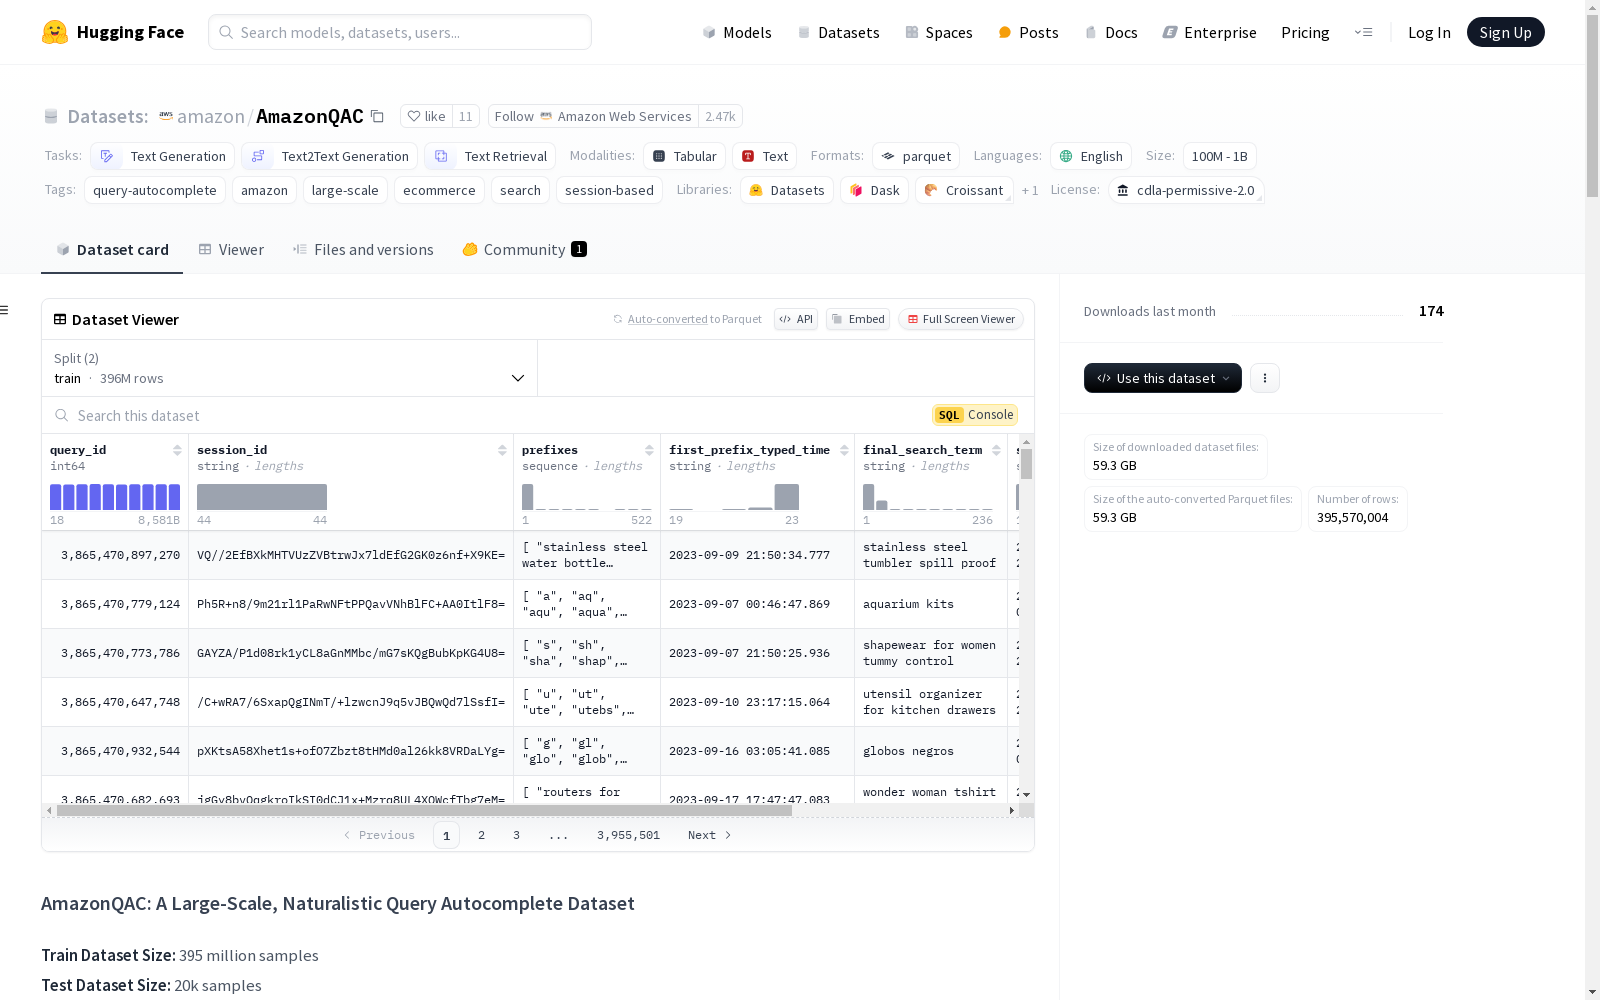
AmazonQAC是一个大规模的查询自动完成(Query Autocomplete, QAC)数据集,源自真实的亚马逊搜索日志。该数据集包含用户输入的前缀序列和最终搜索词,以及丰富的会话元数据,如时间戳和会话ID。训练集包含3.95亿个样本,测试集包含2万个样本。数据集支持上下文感知的查询完成研究,提供真实、大规模和自然的用户行为数据。数据集的结构包括训练集和测试集,每个数据条目包含查询ID、会话ID、前缀序列、首次输入前缀的时间、最终搜索词、搜索时间以及搜索词的流行度。测试集还包括用户过去的搜索词及其时间戳。数据集的评估指标包括Success@10和Reciprocal Rank@10。所有数据均已匿名化,并移除了个人身份信息(PII)。

AmazonQAC is a large-scale Query Autocomplete (QAC) dataset derived from real Amazon search logs. This dataset contains user-input prefix sequences and final search queries, along with rich session metadata such as timestamps and session IDs. The training set includes 395 million samples, while the test set contains 20,000 samples. It supports research on context-aware query completion by providing real, large-scale and natural user behavior data. The dataset is structured into training and test splits, with each data entry comprising query ID, session ID, prefix sequence, timestamp of the first prefix input, final search query, search time, and the popularity of the search query. The test set additionally includes the user's past search queries and their corresponding timestamps. The evaluation metrics for this dataset include Success@10 and Reciprocal Rank@10. All data has been anonymized, and personally identifiable information (PII) has been removed.
提供机构:
Amazon Web Services
创建时间:
2024-10-12
搜集汇总
数据集介绍
AmazonQAC 数据集图片
构建方式
AmazonQAC数据集的构建基于亚马逊搜索日志,涵盖了2023年9月至10月期间的真实用户搜索行为。数据集通过匿名化处理,确保用户隐私得到保护,并过滤了出现次数少于4次的搜索词,以避免用户特定信息的泄露。训练集包含3.95亿个样本,测试集则包含2万个样本,分别用于模型训练和性能评估。每个样本记录了用户输入的搜索前缀序列、最终搜索词以及相关的会话元数据,如会话ID和时间戳,为上下文感知的查询自动补全研究提供了丰富的数据支持。
特点
AmazonQAC数据集以其大规模和自然性著称,训练集包含3.95亿个样本,测试集包含2万个样本,均来自真实的用户搜索行为。数据集不仅记录了用户输入的搜索前缀序列和最终搜索词,还提供了会话ID、时间戳等元数据,支持上下文感知的建模。此外,数据集还包含了搜索词的流行度信息,为研究用户行为提供了额外的维度。测试集的设计模拟了真实的查询自动补全服务,包含用户过去搜索词的序列,进一步增强了数据集的实用性和挑战性。
使用方法
AmazonQAC数据集适用于多种自然语言处理任务,如文本生成、文本到文本生成以及文本检索。研究人员可以通过加载Parquet格式的数据文件,使用训练集进行模型训练,并通过测试集评估模型性能。数据集的核心评估指标包括Success@10和Reciprocal Rank@10,分别衡量模型在提供10个建议时是否包含正确搜索词以及正确搜索词的排名。通过结合会话元数据,研究人员可以探索上下文感知的查询自动补全方法,提升模型的预测准确性和用户体验。
背景与挑战
背景概述
AmazonQAC数据集由亚马逊搜索日志构建,旨在推动查询自动补全(QAC)系统的研究。该数据集由Dante Everaert、Rohit Patki、Tianqi Zheng和Christopher Potts等研究人员于2024年发布,收录了2023年9月至10月期间的美国用户搜索行为数据,包含3.95亿条训练样本和2万条测试样本。QAC作为搜索引擎中的关键功能,能够根据用户输入的前缀预测完整查询,然而,此前缺乏大规模、真实场景的数据集限制了该领域的研究进展。AmazonQAC通过提供真实的用户前缀序列、会话ID和时间戳等元数据,填补了这一空白,为上下文感知的查询补全研究提供了重要支持。该数据集的发布不仅为QAC系统的优化提供了基准,也为自然语言处理领域的研究者提供了丰富的实验数据。
当前挑战
AmazonQAC数据集在解决查询自动补全问题时面临多重挑战。首先,QAC系统的核心在于准确预测用户意图,然而用户输入的前缀往往较短且模糊,增加了预测难度。其次,上下文信息的利用是提升QAC性能的关键,但如何有效建模用户会话中的历史搜索行为仍是一个未完全解决的难题。在数据集构建过程中,研究人员需处理大规模搜索日志的匿名化问题,确保用户隐私得到保护,同时保留数据的真实性和多样性。此外,数据集的文化和语言背景局限于美国市场,可能限制了其在不同语言和文化环境中的泛化能力。尽管微调后的语言模型在实验中表现最佳,但其性能仍远未达到理论上限,表明QAC问题仍具有较大的研究空间。
常用场景
经典使用场景
AmazonQAC数据集在查询自动补全(QAC)任务中展现了其经典应用场景。通过提供大规模、自然化的用户搜索日志数据,该数据集为研究者和开发者提供了一个理想的平台,用于训练和评估各种QAC系统。特别是在处理用户输入的前缀时,AmazonQAC能够模拟真实的搜索环境,帮助系统预测用户可能输入的完整查询。
衍生相关工作
AmazonQAC数据集的发布催生了一系列相关研究工作,特别是在基于大语言模型(LLMs)的查询自动补全系统方面。研究者们利用该数据集对前缀树、语义检索和LLMs等不同方法进行了评估,发现经过微调的LLMs在结合上下文信息时表现最佳。这些研究成果不仅推动了QAC技术的发展,还为未来的研究提供了新的方向和基准。
数据集最近研究
最新研究方向
在电子商务和搜索引擎领域,查询自动补全(Query Autocomplete, QAC)技术作为提升用户体验的关键功能,近年来备受关注。AmazonQAC数据集的发布为这一领域的研究提供了大规模、自然化的数据支持,推动了基于上下文感知的QAC系统的发展。当前研究热点主要集中在如何利用大型语言模型(LLMs)进行微调,并结合会话上下文信息提升预测准确性。尽管现有系统在测试数据上表现优异,但其性能仅达到理论潜力的一半,表明QAC问题仍具有极大的挑战性。AmazonQAC的引入不仅为学术界提供了丰富的实验数据,也为工业界优化搜索引擎性能提供了新的思路。未来研究方向可能包括跨语言、跨文化的QAC系统适应性研究,以及如何在保护用户隐私的前提下进一步提升模型的泛化能力。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

