遇见数据集

lirus18/deepfashion_with_captions_blowout

收藏
Hugging Face2023-05-16 更新2024-03-04 收录
官方服务:

资源简介:

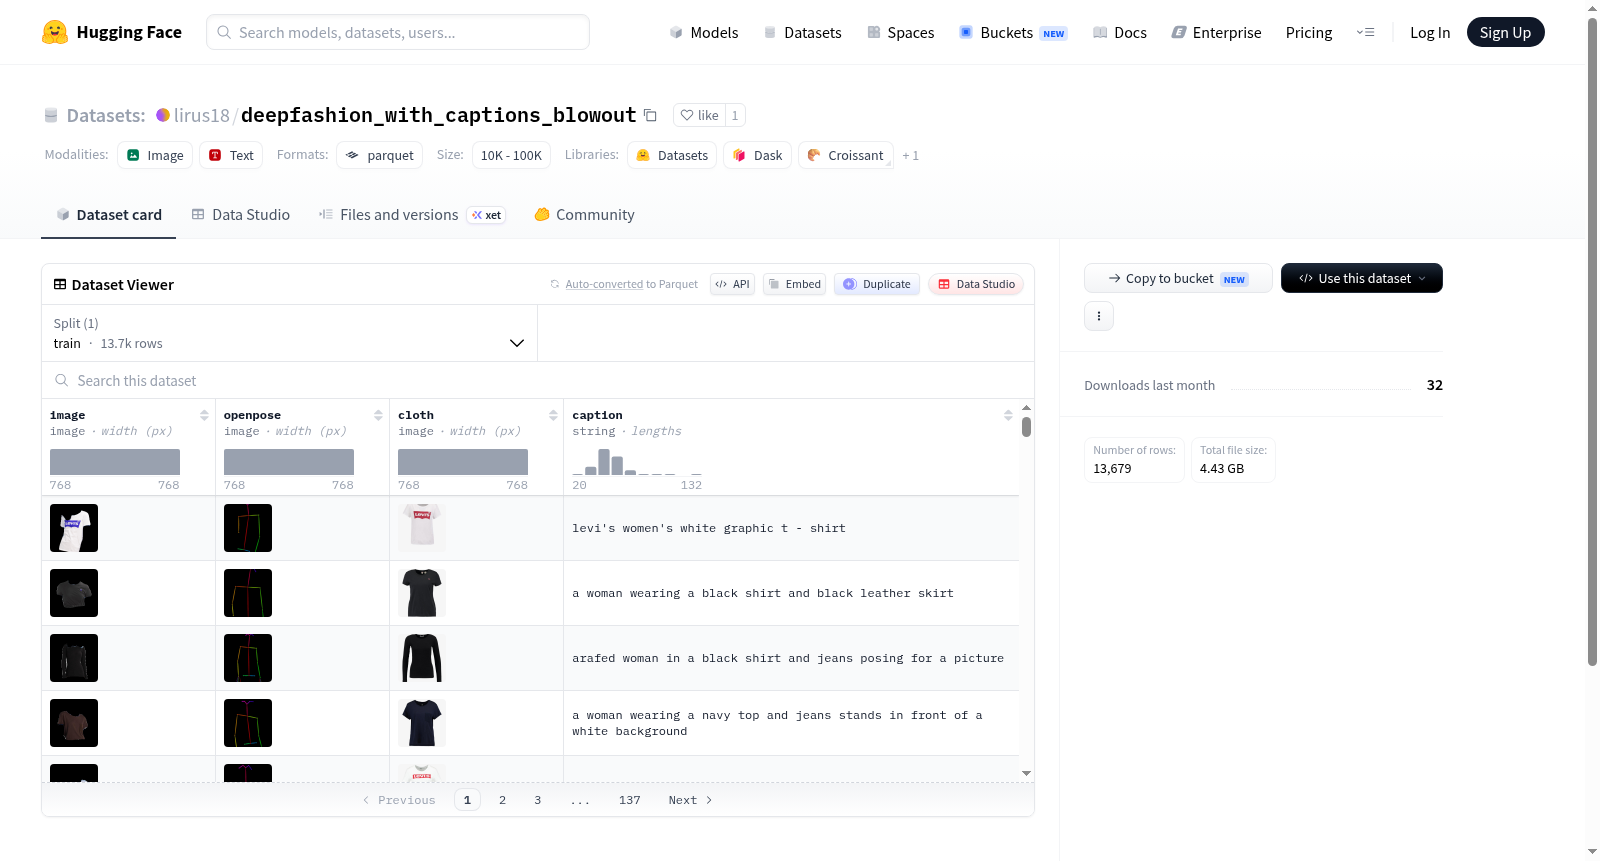
--- dataset_info: features: - name: image dtype: image - name: openpose dtype: image - name: cloth dtype: image - name: caption dtype: string splits: - name: train num_bytes: 4597369002.709 num_examples: 13679 download_size: 4429889834 dataset_size: 4597369002.709 --- # Dataset Card for "deepfashion_with_captions_blowout" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

--- dataset_info: 特征项: - 字段名:image,数据类型:图像 - 字段名:openpose,数据类型:图像 - 字段名:cloth,数据类型:图像 - 字段名:caption,数据类型:字符串 数据划分: - 划分名称:train 数据字节数:4597369002.709 样本数量:13679 下载大小:4429889834 数据集总大小:4597369002.709 --- # 「deepfashion_with_captions_blowout」数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
lirus18
原始信息汇总

数据集概述

数据集名称

deepfashion_with_captions_blowout

数据集特征

  • image: 图片类型
  • openpose: 图片类型
  • cloth: 图片类型
  • caption: 字符串类型

数据集划分

  • train:
    • 示例数量: 13679
    • 数据大小: 4597369002.709 字节

数据集大小

  • 下载大小: 4429889834 字节
  • 总数据大小: 4597369002.709 字节
搜集汇总
数据集介绍
lirus18/deepfashion_with_captions_blowout 数据集图片
构建方式
该数据集基于DeepFashion数据库构建,通过整合服装图像及其对应的文本描述,形成了一个多模态的时尚数据集。具体而言,数据集收录了13,679张训练样本,每张图像均配备了高精度的OpenPose姿态关键点标注、独立的服装区域裁剪图像以及详细的自然语言描述文本。这些描述通过自动化标注流程生成,确保了文本与图像内容的高度一致性。数据集的构建旨在为时尚领域的图像生成、检索及编辑任务提供基础支持。
特点
数据集的核心特点在于其多模态信息的有机融合。每个样本包含原始图像、姿态骨架图、服装局部图以及描述性文本,这种结构使得模型能够同时学习服装的外观特征、空间姿态信息以及语义描述。此外,数据集在图像质量和标注精度上表现出色,所有图像均经过标准化处理,确保了数据的一致性和可用性。这种多维度的数据组织形式,为时尚领域的跨模态研究提供了宝贵的资源。
使用方法
使用时,可通过HuggingFace Datasets库直接加载该数据集,利用其提供的图像与文本字段进行模型训练或评估。具体而言,研究者可提取'image'字段进行图像生成任务,结合'caption'字段开展文本到图像的生成,或利用'openpose'与'cloth'字段进行姿态引导的服装编辑。数据集已划分为训练集,无需额外预处理即可直接用于深度学习框架,降低了使用门槛并提升了研究效率。
背景与挑战
背景概述
在计算机视觉与时尚产业深度融合的背景下,图像描述生成技术成为连接视觉内容与自然语言理解的关键桥梁。DeepFashion数据集作为时尚领域最具影响力的基准之一,自2016年由香港中文大学研究团队发布以来,为服装识别、属性预测及姿态估计等任务提供了丰富的标注资源。然而,原始版本缺乏文本描述信息,限制了多模态研究的深入发展。lirus18/deepfashion_with_captions_blowout数据集应运而生,其创建时间较晚,旨在弥补这一空白,通过为DeepFashion图像附加详细文本描述,推动时尚图像检索、智能穿搭推荐及虚拟试衣等应用场景的研究。该数据集包含13,679个训练样本,每张图像均关联了人体姿态、服装区域及对应标题,为跨模态对齐与生成任务奠定了坚实基础。
当前挑战
该数据集面临的核心挑战源于时尚图像本身的复杂性与多模态融合的固有难度。在领域问题层面,服装款式、纹理与配饰的细微差异要求模型具备高精度细粒度识别能力,而人体姿态多样性及遮挡现象进一步加剧了视觉内容解析的难度。构建过程中,数据清洗与标注一致性成为关键瓶颈:如何从海量原始图像中筛选出清晰、无歧义的样本,并确保文本描述准确反映服装属性(如颜色、图案、风格),需要大量人工校验与领域知识。此外,姿态估计与服装分割的自动化流程可能引入噪声,例如关节定位偏差或掩膜边界不精确,这些误差会传递至下游任务,影响模型鲁棒性。跨域泛化问题同样突出,训练数据中特定场景或模特姿态的偏斜,可能导致模型在真实应用场景中性能骤降。
常用场景
经典使用场景
在时尚视觉理解与生成领域,DeepFashion with Captions Blowout数据集凭借其丰富的图像-文本配对资源,成为多模态学习研究的基石。该数据集包含超过一万三千张高质量时尚图像,每张图像不仅提供原始服装照,还附带人体姿态骨架图(OpenPose)与衣物分割掩码,并配有自然语言描述。这一结构使其广泛应用于基于文本的时尚图像检索、可控服装图像生成以及跨模态时尚推荐系统。研究者常利用其对齐的图像与文本特征,训练能够根据文字描述精准合成或检索对应服装的模型,从而推动时尚领域视觉与语言融合技术的进步。
解决学术问题
该数据集有效解决了时尚领域细粒度语义对齐的学术难题。传统方法在将抽象文本描述(如“宽松的米色亚麻衬衫”)映射到具体视觉特征时,常因缺乏像素级标注而表现不佳。DeepFashion with Captions Blowout通过提供姿态、衣物区域与文本的联合监督,使得模型能够学习到服装属性、款式与人体结构的精确对应关系。这为研究衣物形变下的鲁棒特征提取、文本引导的语义分割以及多模态表示学习提供了标准化的评估基准,显著推动了时尚图像理解从粗粒度分类向细粒度语义控制的范式转变。
衍生相关工作
围绕该数据集,学术界涌现出一系列经典衍生工作。在可控图像生成方向,研究者基于其OpenPose与衣物掩码信息,提出了名为FashionGAN的框架,实现了姿态与文本双重条件约束下的高质量服装图像合成。在跨模态检索领域,DeepFashion-CLIP模型利用该数据微调视觉语言预训练模型,显著提升了时尚领域文本-图像匹配的准确率。此外,还有工作通过引入对抗训练策略,解决了数据集中衣物区域与背景复杂耦合的难题,衍生出更鲁棒的时尚图像解析器。这些工作不仅验证了数据集的价值,更推动了时尚AI从单一任务向多任务统一建模的演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务