
遇见数据集

bio-nlp-umass/MedThinkVQA

收藏
Hugging Face2026-05-20 更新2026-05-10 收录
官方服务:

资源简介:

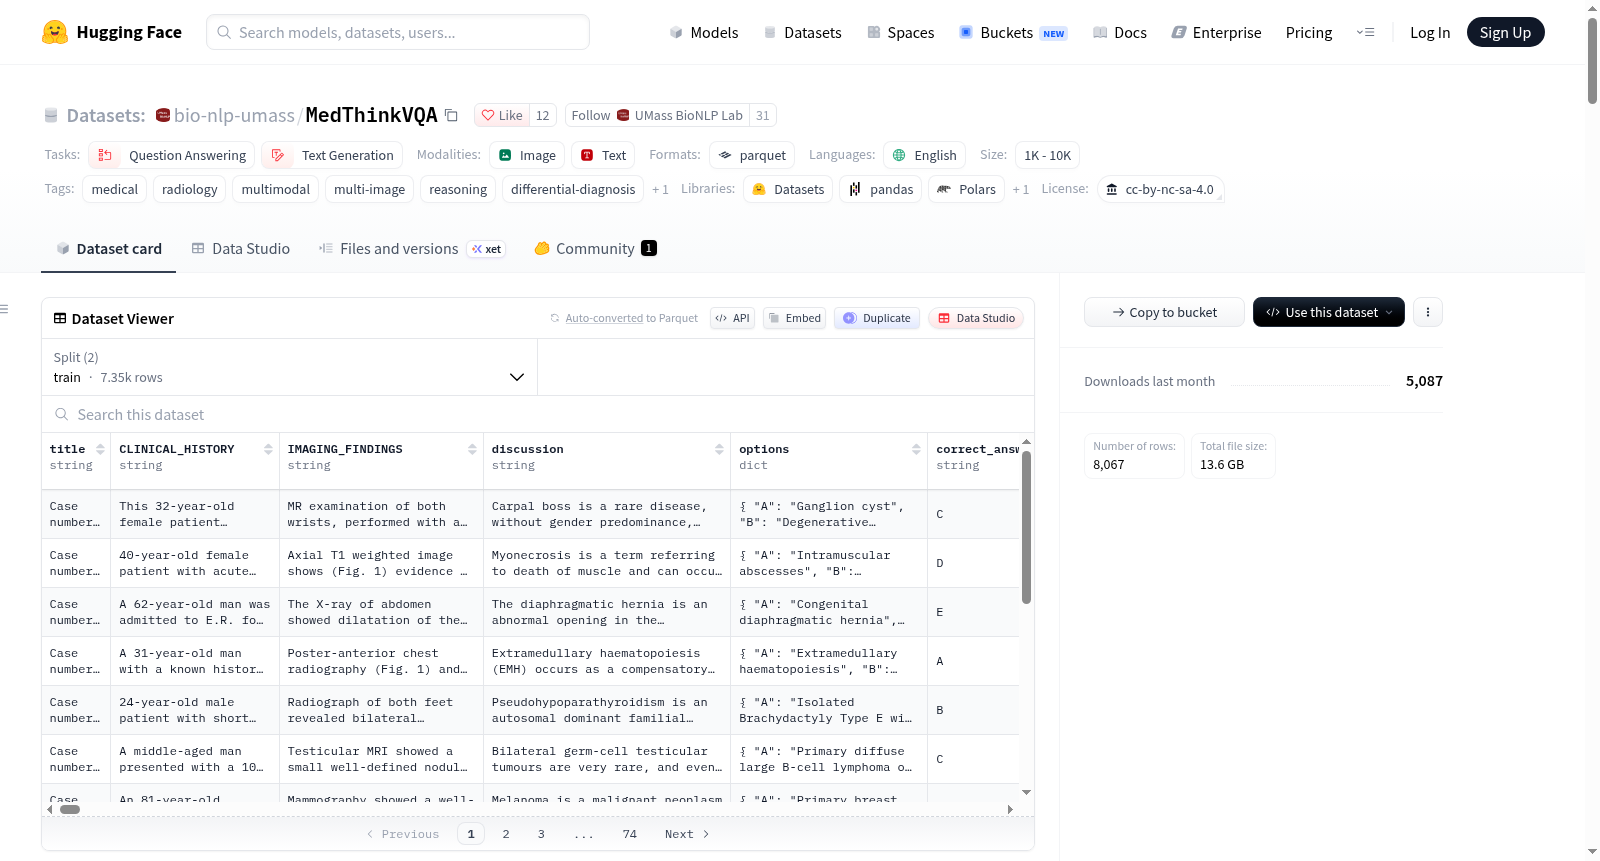
MedThinkVQA是一个专家标注的基准数据集,专注于放射学中的多图像诊断推理。与以往最多包含单图像的医学视觉问答基准不同,该数据集要求模型从每个图像中提取证据、整合跨视图信息,并进行鉴别诊断推理。它是一个多图像、多模态且部分纵向的基准,包含8,067个案例(7,347个训练案例和720个测试案例),平均每个案例有6.62张图像(测试集为8.12张),涉及CT、MRI、X射线、超声、病理学、临床摄影、核医学与分子成像、内窥镜等多种医学影像模态,30.4%的测试案例具有纵向结构。数据集围绕Think-with-Images工作流设计,提供明确的中间监督,包括三个步骤:单图像发现、集成影像总结和鉴别诊断推理,并包含医学教育案例讨论任务。

MedThinkVQA is an expert-annotated benchmark dataset focused on multi-image diagnostic reasoning in radiology. Unlike previous medical visual question answering (VQA) benchmarks that mostly contain only single images, this dataset requires models to extract evidence from each image, integrate cross-view information, and perform differential diagnostic reasoning. It is a multi-image, multimodal and partially longitudinal benchmark, consisting of 8,067 cases (7,347 training cases and 720 test cases), with an average of 6.62 images per case (8.12 images for the test set), covering various medical imaging modalities including CT, MRI, X-ray, ultrasound, pathology, clinical photography, nuclear medicine and molecular imaging, endoscopy, etc. 30.4% of the test cases have a longitudinal structure. Designed around the Think-with-Images workflow, the dataset provides explicit intermediate supervision, including three steps: single-image discovery, integrated image summarization, and differential diagnostic reasoning, and also includes medical education case discussion tasks.
提供机构:
bio-nlp-umass
搜集汇总
数据集介绍
bio-nlp-umass/MedThinkVQA 数据集图片
构建方式
在医学视觉问答与多图像放射诊断推理交汇的领域背景下,MedThinkVQA 依托 Eurorad(欧洲放射学会)经授权且经去标识化处理的病例资源构建。其构建以临床场景、多幅医学图像和五个候选诊断为基本单元,并配有影像学发现、逐图说明、ICD 层级标签、纵向时间信息与模态标注。为保障图像证据的必要性,构建过程过滤了文本可解和图像泄漏病例,同时采用专家标注与 Think-with-Images 工作流,对逐图发现、跨视图整合及鉴别诊断三阶段提供显式中间监督。最终形成 8,067 例数据,其中训练集 7,347 例、测试集 720 例。
使用方法
面向多图像医学诊断推理评测与医学教育应用,MedThinkVQA 可通过 Hugging Face datasets 库加载,选择 train 或 test 划分,并访问临床病史、候选选项、正确答案、图像路径、图注、模态与子模态等字段。使用前建议下载 images.zip,以保持 images/caseXXXXX/<img_id>.jpg 的目录结构。模型可依 Think-with-Images 流程运行:逐图生成放射学发现,合成病例级影像摘要,对照五个候选诊断进行鉴别推理并选定诊断,亦可生成教学式病例讨论。评估涵盖步骤一至二的 ROUGE/RadCliQ 指标,以及步骤三和教育讨论的结构化人工或大模型评判。数据许可为 CC BY-NC-SA 4.0,限研究与教育用途,禁止商业、临床设备及诊疗分诊用途。
背景与挑战
背景概述
在医学影像智能分析迈向多图证据整合的脉络中,MedThinkVQA 于2026年4月5日发布,由与马萨诸塞大学及耶鲁大学相关联的研究者维护,聚焦放射学多图诊断推理。该基准以专家标注病例为核心,收录8067例,涵盖CT、MRI、X射线、超声、病理与内镜等多模态,测试集平均每例8.12幅图像,30.4%具纵向结构。其核心问题是模型能否逐图提取影像发现、整合跨视图证据并完成鉴别诊断,力图弥补单图医学视觉问答的局限,为临床推理与医学教育评测提供高难度标尺。
当前挑战
面向放射学鉴别诊断的真实临床场景,MedThinkVQA 所回应的领域难题在于传统医学视觉问答通常至多涵盖单幅图像,难以评价多序列、多模态及纵向影像中的证据抽取、跨视图整合与干扰诊断排除。构建层面亦面临多重挑战:病例去标识与专家标注成本高,需确保图像对答案必要并过滤文本可解及泄漏样本,还需协调多模态、时间点与五候选诊断的复杂结构,并为逐图发现、综合影像摘要、鉴别诊断推理及医学教育讨论设置多阶段监督和不止于最终准确率的评估。
常用场景
经典使用场景
在放射学多模态诊断推理由单图问答转向跨视图证据融合的学术脉络中,MedThinkVQA的经典使用场景集中于多图像、多模态与部分纵向病例的鉴别诊断评测。该基准要求模型沿Think-with-Images流程,逐图提炼放射学发现,汇合跨视角证据形成病例级影像摘要,再对齐五个候选诊断并给出图像锚定的排除理由与最终判断。其标注覆盖CT、MRI、X线、超声、病理、核医学等多种模态,亦支持医学教育病例讨论任务,促使模型生成基于病例的教学式解释。评估既考察最终选项,也以ROUGE、RadCliQ及结构化评判审视中间推理质量。
解决学术问题
医学视觉问答长期受限于单图设定、浅层匹配与文本捷径,难以检验真正的跨图像证据整合和鉴别诊断能力。MedThinkVQA通过每例多图、多模态及纵向时点设计,并过滤文本可解与泄漏病例,回应了多视图证据聚合、图像必要性验证、候选诊断排除和可解释推理监督等研究难题。其显式中间监督将每图发现、整合摘要与DDx推理纳入评测,使模型性能差异可归因于证据提取与整合,而非仅答案命中。意义在于为多模态医学推理建立更接近放射科认知流程的基准,推动过程可评估、结果可复现的学术范式。
实际应用
面向医学人工智能研发与放射教育场景,MedThinkVQA可作为多模态模型的能力探针与教学案例库。研究人员可用其测试模型在跨模态、跨视图和纵向影像中的诊断推理表现,比较不同规模模型、推理努力与图像数量对性能的影响。医学教育者可借助病例讨论任务构建基于真实影像的互动教学,训练住院医师整合临床病史、影像发现与鉴别诊断。因许可限定为非商业研究与教育用途,且明确禁止作为临床设备、诊断、治疗或分诊依据,其实际部署应停留在科研评测、模型迭代与教学辅助等合规边界。
数据集最近研究
最新研究方向
在医学多模态推理由单图感知迈向跨视图临床决策的背景下,MedThinkVQA 的最新研究聚焦多图像放射学鉴别诊断与可解释推理。其核心方向是围绕 Think-with-Images 工作流,监督逐图征象提取、跨视角影像整合与五候选鉴别诊断推理,并拓展医学教育案例讨论。数据集以 8067 个病例、测试集平均 8.12 幅图像及 30.4% 纵向病例,突破传统医学 VQA 单图范式。近期评测显示,增加图像、提升推理强度及采用更大同族多模态模型均能改善表现,故其意义在于推动多图证据融合、临床可解释性与纵向多模态大模型评测。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

