lingua-patria
收藏资源简介:
LINGUA PATRIA是一个多语言平行语料库,专注于非洲宪政治理、反腐败和世袭主权领域。其开放子集v1.0包含77个三语(英语、法语、葡萄牙语)对齐的平行文本片段,每种语言约21,000词,总计约63,000词。数据来源于Armand Salouo于2026年出版的著作《The Patrimonial Revolution: Public Goods & Africas Third Independence》。该数据集是GOVBENCH AFRICA多语言NLP评估基准(正在开发中)的开放数据基础,旨在评估语言模型在非洲治理任务(涉及Twi/Akan、Wolof和Lingala等语言)上的性能。数据内容围绕非洲治理研究,分为四个主题类别:制度治理与主权(A类,约占28%)、反腐败与透明度(B类,约占30%)、宪法与立法文本(C类,约占19%)、独立、发展与地缘政治(D类,约占22%)。涵盖了从“殖民腐败根源”到“非洲第三次独立”等八个核心章节。文本类型包括分析性文本(约14,114英文词)、立法性文本(约6,153英文词)和判例法文本(约1,183英文词)。数据集以CSV格式(UTF-8编码)提供,每个数据行代表一个对齐的平行片段,主要字段包括唯一片段标识符、源页码、章节名、主题类别、子类别代码、地理参考区域、文档类型、质量评分、各语言词数以及英语、法语、葡萄牙语的文本内容。此外,为未来版本预留了Twi/Akan、Wolof和Lingala的翻译字段。每个片段都附有完整的书目来源引用。数据集遵循FAIR原则,具有持久标识符(DOI),可免费获取。语料文本采用CC BY 4.0许可,元数据采用CC0许可,评估代码采用Apache 2.0许可。数据集旨在支持非洲治理与反腐败政策研究、低资源语言的NLP模型评估与跨语言对齐、公民教育材料开发等,并与联合国可持续发展目标(SDG 16和平、正义与强大机构,SDG 10减少不平等,SDG 4优质教育)高度契合。数据集由Kurukan Publishing(喀麦隆)发布,并由Transparency Africa(法国)共同签署治理。
LINGUA PATRIA is a multilingual parallel corpus focused on the fields of African constitutional governance, anti-corruption, and hereditary sovereignty. Its open subset v1.0 contains 77 aligned parallel text segments in three languages (English, French, Portuguese), with approximately 21,000 words per language, totaling around 63,000 words. The data is sourced from Armand Salouo’s 2026 published work *The Patrimonial Revolution: Public Goods & Africa’s Third Independence*. This dataset serves as the open data foundation for the GOVBENCH AFRICA multilingual NLP evaluation benchmark (under development), which aims to assess the performance of language models on African governance tasks involving languages such as Twi/Akan, Wolof, and Lingala. The dataset content centers on African governance research and is divided into four thematic categories: Institutional Governance and Sovereignty (Category A, accounting for ~28%), Anti-Corruption and Transparency (Category B, ~30%), Constitutional and Legislative Texts (Category C, ~19%), and Independence, Development and Geopolitics (Category D, ~22%). It covers eight core chapters ranging from "The Roots of Colonial Corruption" to "Africa’s Third Independence". Text types include analytical texts (approximately 14,114 English words), legislative texts (approximately 6,153 English words), and case law texts (approximately 1,183 English words). The dataset is distributed in CSV format (UTF-8 encoding), with each data row representing an aligned parallel segment. The core fields include unique segment identifier, source page number, chapter name, thematic category, subcategory code, georeferenced region, document type, quality score, word count per language, and the text content in English, French, and Portuguese. In addition, translation fields for Twi/Akan, Wolof, and Lingala are reserved for future releases of the dataset. Each segment is accompanied by a complete bibliographic citation. The dataset adheres to the FAIR principles, possesses a persistent identifier (DOI), and is freely accessible. The corpus text is licensed under CC BY 4.0, the metadata under CC0, and the evaluation code under Apache 2.0. This dataset is designed to support research on African governance and anti-corruption policies, NLP model evaluation and cross-lingual alignment for low-resource languages, development of civic education materials, and other related work, and is highly aligned with the United Nations Sustainable Development Goals (SDG 16: Peace, Justice and Strong Institutions, SDG 10: Reduced Inequalities, SDG 4: Quality Education). The dataset is published by Kurukan Publishing (Cameroon) and co-governed by Transparency Africa (France).
数据集概述:LINGUA PATRIA — Open Subset v1.0
LINGUA PATRIA 是一个三语对齐的平行语料库,专注于非洲宪政治理、反腐败和主权治理领域。该开放子集 v1.0 包含 77 个对齐段落(每种语言约 21,000 词),涵盖 英语、法语和葡萄牙语,摘自 The Patrimonial Revolution: Public Goods & Africas Third Independence(Armand Salouo,2026)。该数据集是 GOVBENCH AFRICA 多语言 NLP 评估基准的开放数据基础,后续版本(v2.0)计划扩展至 Twi/Akan、Wolof 和 Lingala 语言。
数据集基本信息
| 属性 | 说明 |
|---|---|
| 数据集名称 | LINGUA PATRIA — Open Subset v1.0 |
| 版本 | 1.0(2026 年 6 月) |
| 语言 | 英语(EN)、法语(FR)、葡萄牙语(PT) |
| 目标语言(v2.0) | Twi/Akan、Wolof、Lingala(开发中) |
| 数据规模 | 77 个对齐段落;英语约 21,450 词,法语约 21,072 词,葡萄牙语约 20,072 词 |
| 领域 | 宪政治理、反腐败、公共主权 |
| 格式 | CSV(UTF-8);JSON-L(即将推出) |
| 许可证 | 语料文本:CC BY 4.0;元数据/架构:CC0 1.0;评估代码:Apache 2.0 |
| 发布者 | Kurukan Publishing(喀麦隆雅温得) |
| 治理联合签署方 | Transparency Africa(法国巴黎) |
| DOI | 10.5281/zenodo.20578745 |
| 数字公共产品提名 | 是 |
主题覆盖
语料库按四个主题类别组织,具体分布如下:
| 类别 | 主题 | 英文词数 | 占比 |
|---|---|---|---|
| A | 制度治理与主权 | 5,988 | 28% |
| B | 反腐败与透明度 | 6,539 | 30% |
| C | 宪法与立法文本 | 4,113 | 19% |
| D | 独立、发展与地缘政治 | 4,810 | 22% |
涵盖的章节:总论——世袭主权框架;第 1 章——非洲腐败的殖民根源;第 2 章——后殖民遗产的 60 年;第 3 章——反腐败:受挫的承诺;第 4 章——方法论的巨大僵局;第 5 章——公共主权的新范式;第 6 章——公共产品宪法化(世袭盾牌);第 7 章——新国家、新公民与新人文主义;第 8 章——非洲的第三次独立;结论——摆脱悖论。
文档类型分布:
- 分析性文本:14,114 词(治理分析、政策论点、理论框架)
- 立法性文本:6,153 词(宪法条款、立法机制、法律提案)
- 判例性文本:1,183 词(法院参考、法律先例、监管裁决)
数据结构
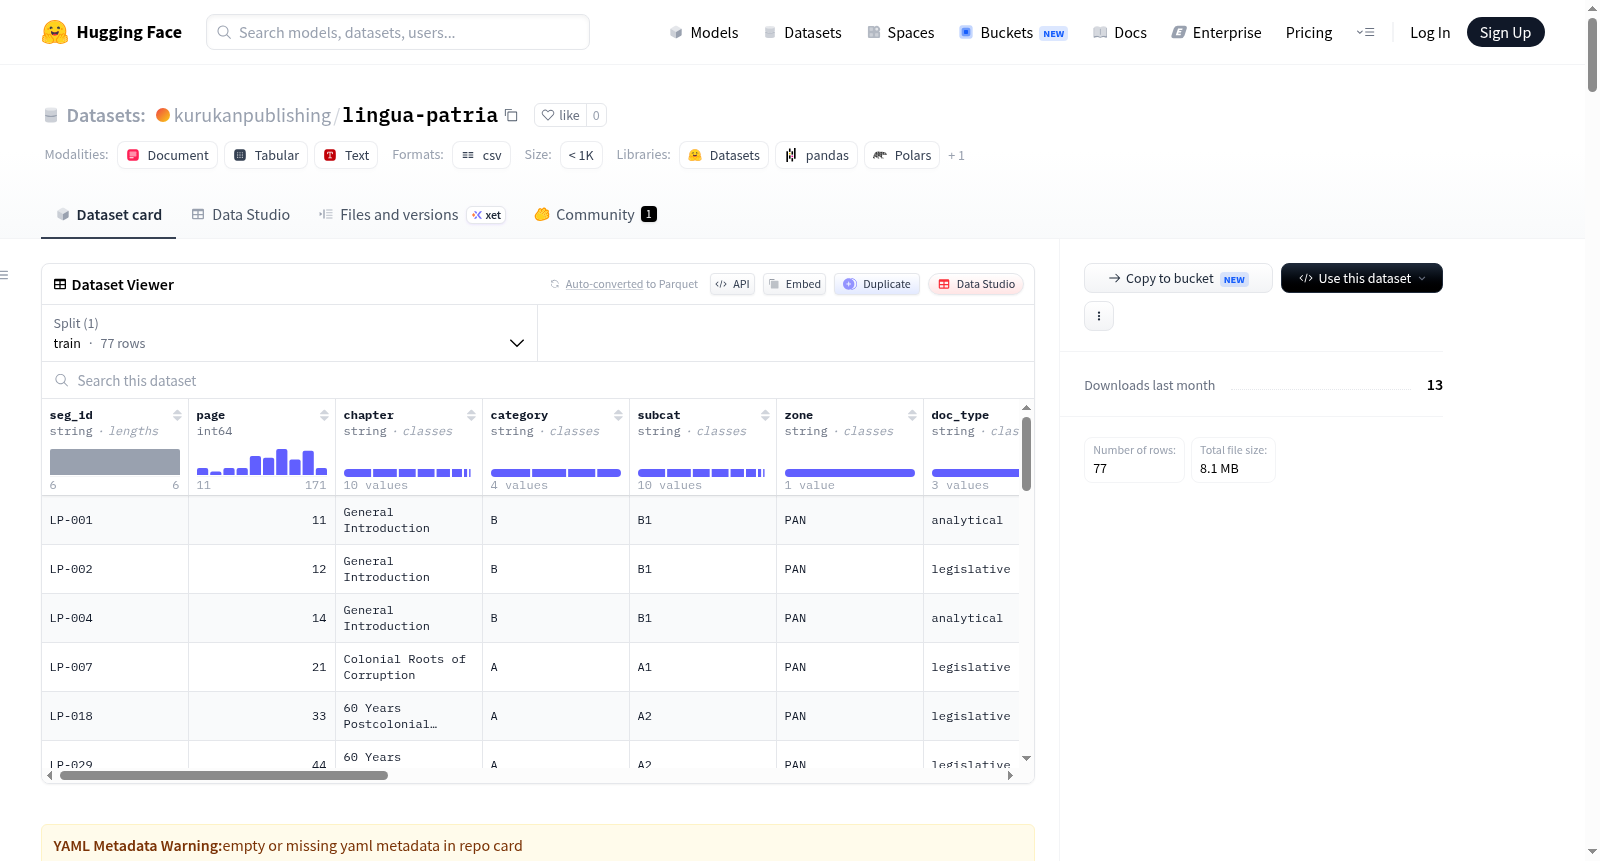
CSV 文件中每一行代表一个对齐段落,包含以下字段:
| 字段 | 描述 |
|---|---|
seg_id |
唯一段落标识符(LP-001 至 LP-077) |
page |
源文本页码 |
chapter |
章节名称 |
category |
主题类别(A / B / C / D) |
subcat |
子类别代码(A1–A5, B1–B5, C1–C4, D1–D4) |
zone |
地理参考(PAN = 泛非) |
doc_type |
文档类型(analytical / legislative / jurisprudence) |
score |
质量评分(4–8),基于术语密度、语义自主性和可翻译性 |
words_en / words_fr / words_pt |
各语言词数 |
text_en / text_fr / text_pt |
各语言段落文本 |
text_twi / text_wol / text_lin |
Twi/Akan、Wolof、Lingala 翻译(v2.0 中填充) |
license |
段落许可证(CC BY 4.0) |
source_title |
完整书目参考 |
质量评分标准:每个段落根据三项标准(每项 1–3 分,总分 3–9)评分:
- 术语密度:治理/反腐败术语的丰富程度
- 语义自主性:无需相邻段落即可理解的程度
- 可翻译性:适合翻译成低资源非洲语言的程度
当前子集评分分布:4(×1)、5(×10)、6(×28)、7(×23)、8(×15)。中位评分:6。不包括评分低于 4 的段落。
预期用途与限制
✅ 适当用途:
- 非洲治理、反腐败政策和宪法法律研究
- NLP 模型评估与基准测试(非洲语言)
- 低资源语言的跨语言对齐和迁移学习
- 公民教育材料与政策素养工具
- SDG 16(和平、正义与强大机构)研究的开放数据
❌ 禁止用途(详见 负责任使用政策):
- 监视、政治针对或压制活动人士或异见者
- 对个人或社区进行歧视性画像
- 操纵治理基准以歪曲机构表现
- 任何破坏非洲民主进程或人权的行为
与可持续发展目标(SDGs)的关联
| SDG | 关联性 |
|---|---|
| SDG 16 — 和平、正义与强大机构 | 核心对齐:反腐败、宪政治理、法治、透明机构 |
| SDG 10 — 减少不平等 | 语言公平:使治理知识以非洲语言可访问 |
| SDG 4 — 优质教育 | 公民素养:支持宪法权利和公共问责制的教育 |
FAIR 原则遵守情况
- 可发现:具有持久标识符(Zenodo DOI + HuggingFace 数据集 ID + GitHub),并提供都柏林核心和 Croissant 格式的结构化元数据。
- 可访问:可免费下载 CSV 格式;镜像存储于 HuggingFace Datasets、Zenodo 和 GitHub,无需注册。
- 可互操作:UTF-8 编码;标准 CSV 格式;段落 ID 与未来 JSON-L 和 Croissant 元数据版本兼容。
- 可重用:CC BY 4.0 许可;完整来源记录;质量评分和选择方法已公开。
来源与方法论
源作品:The Patrimonial Revolution: Public Goods & Africas Third Independence(Armand Salouo,Kurukan Publishing,2026 年),有英语(173 页)、法语(181 页)和葡萄牙语(156 页)版本。
选择方法:
- 使用 pdfplumber 从 PDF 来源进行全文提取
- 按页分段(平均 276 词/段),保留段落结构
- 三项标准质量评分(术语密度、语义自主性、可翻译性)
- 基于四个主题类别进行配额选择,确保代表性
- 手动验证英语/法语/葡萄牙语版本的页面对齐
- 排除脚注密集的页面(每页超过 3 个脚注引用)
发展路线图
- v1.0(2026 年 6 月,当前版本):77 个英语/法语/葡萄牙语对齐段落;主题分类与质量评分;发布负责任使用政策。
- v2.0(目标:2026 年 Q4):翻译为 Twi/Akan(加纳/科特迪瓦)、Wolof(塞内加尔/冈比亚/毛里塔尼亚)、Lingala(刚果民主共和国/刚果共和国);发布 GOVBENCH AFRICA 评估基准任务(v1.0);推出 JSON-L 和 Croissant 元数据格式。
- v3.0(目标:2027 年):扩展至葡萄牙语非洲语言:Umbundu、Kimbundu(安哥拉)、Makhuwa(莫桑比克);完成 GOVBENCH AFRICA 基准套件并包含人工评估。
治理与负责任使用
由 Kurukan Publishing(喀麦隆雅温得,知识产权持有者与技术作者)和 Transparency Africa(法国巴黎,治理联合签署方)共同治理。完整的负责任使用政策涵盖数据隐私、禁止用途、风险评估、访问治理和投诉机制,可在 RESPONSIBLE_USE_POLICY.md 获取。联系邮箱:editor@cmpublishing.online
引用
bibtex @dataset{salouo2026linguapatria, author = {Salouo, Armand}, title = {LINGUA PATRIA: Open Subset v1.0 — A Multilingual Parallel Corpus on African Constitutional Governance and Anti-Corruption}, year = {2026}, publisher = {Kurukan Publishing}, address = {PoBox 16512, Yaoundé, Cameroon}, version = {1.0}, license = {CC BY 4.0}, doi = {10.5281/zenodo.20578745}, url = {https://doi.org/10.5281/zenodo.20578745}, note = {DPG Nominee — Digital Public Goods Alliance} }