
fineweb-edu-1m
收藏官方服务:
资源简介:
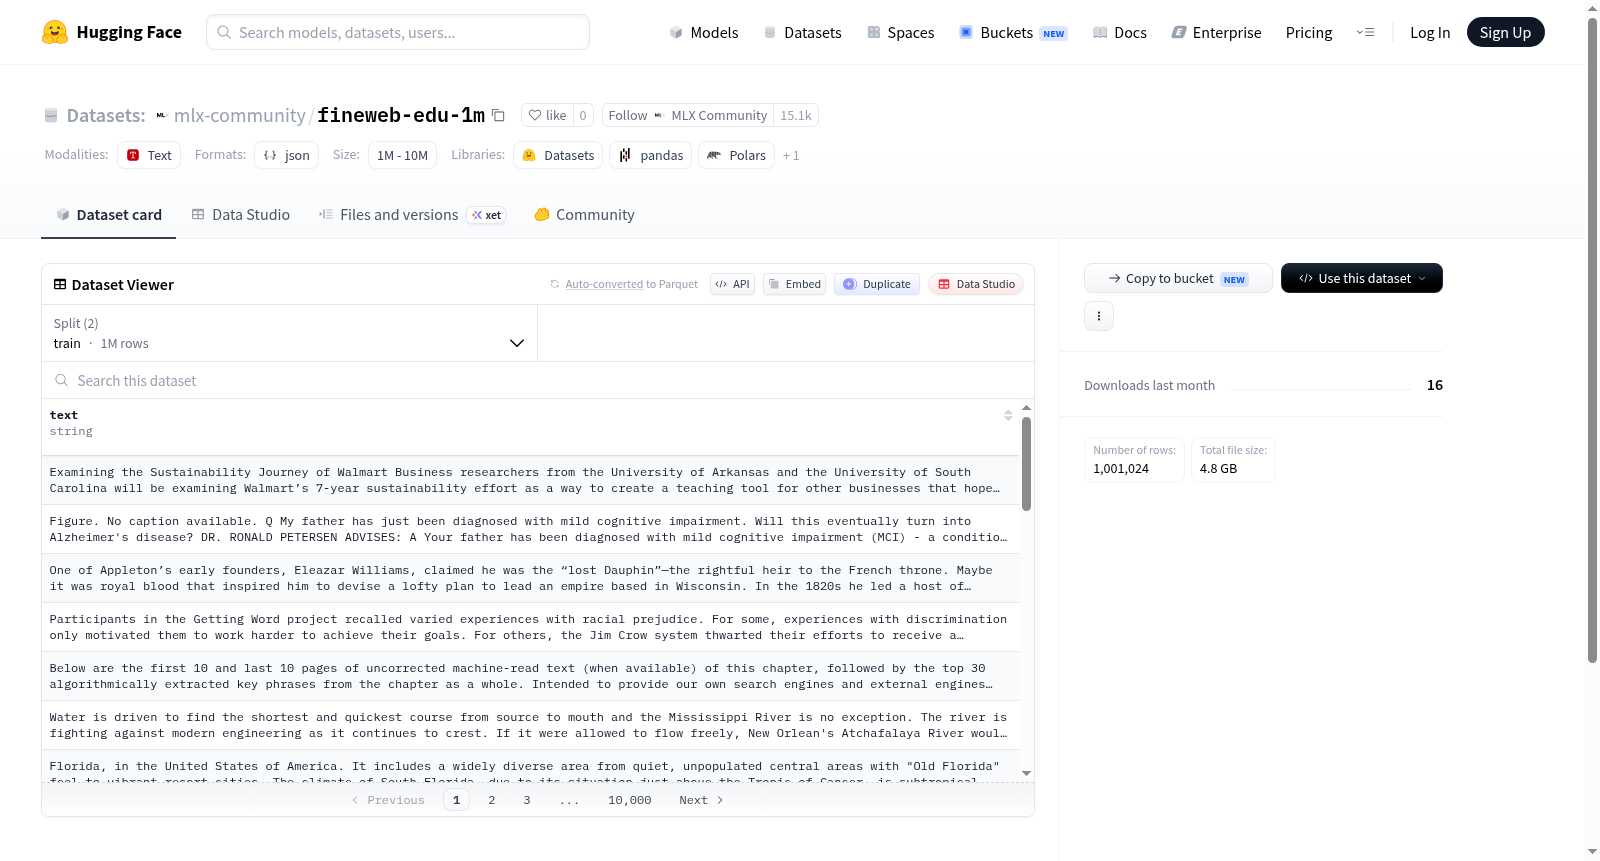
该数据集规模介于1百万到1千万样本之间,具体训练集包含约1百万个样本,验证集包含1024个样本。关于数据集的具体内容、背景、任务定义、数据字段或来源等信息未在文档中说明。
This dataset has a scale ranging from 1 million to 10 million samples. Specifically, the training set contains approximately 1 million samples, while the validation set consists of 1024 samples. No detailed information regarding the dataset's content, background, task definition, data fields or source is stated in the document.
提供机构:
MLX Community创建时间:
2026-07-14
原始信息汇总
数据集名称
mlx-community/fineweb-edu-1m
数据集规模
- 总样本数量:1M - 10M 之间
- 训练集(train):1,000,000 条数据
- 验证集(validation):1,024 条数据
数据集拆分
- train:包含 1,000,000 个样本
- validation:包含 1,024 个样本
搜集汇总
数据集介绍
构建方式
fineweb-edu-1m数据集源自大型网络文本语料库FineWeb,经过教育性内容筛选与质量评估流程构建而成。具体而言,研究团队采用预训练语言模型对原始文档进行教育价值评分,仅保留得分较高的文本段落,并从中随机抽取出约一百万条高质量样本构成训练集。验证集则包含一千零二十四条独立样本,用于模型性能评估与超参数调优。
使用方法
数据采用HuggingFace标准数据集格式发布,支持通过datasets库直接加载使用。用户可指定'splits'参数分别获取包含百万样本的训练集与千余样本的验证集。在应用层面,该数据集适用于的教育类文本生成、阅读理解模型微调及教育知识图谱构建等场景,研究人员亦可基于其教育评分机制进一步开发定制化的领域过滤模型。
背景与挑战
背景概述
FineWeb-Edu-1M 数据集于2024年由HuggingFace团队创建,旨在为教育领域的大型语言模型提供高质量、可扩展的预训练语料。该数据集从FineWeb中筛选出100万个经过教育质量标注的文本样本,每个样本附带教育评分,以解决通用语料在教育场景下知识密度不足的问题。其核心研究问题在于如何通过自动化质量筛选机制,构建针对教育任务更高效的训练数据,从而提升模型在习题解答、知识推理等任务上的表现。该数据集的出现,为教育NLP领域提供了标准化基准,推动了数据驱动下教育智能体的发展。
当前挑战
数据集面临的挑战包括:首先,教育文本的质量标注依赖分类器,存在标签噪声与泛化边界模糊问题,影响下游任务效果。其次,样本规模仅100万,相较于通用预训练语料,可能无法覆盖多样化的教育主题与学科分支,导致模型知识覆盖度不足。构建过程中,从FineWeb亿级数据中高效筛选并确保教育语义的完整性是技术难点,同时需平衡计算成本与筛选精度。验证集仅1024条样本,可能难以充分评估模型在泛化场景下的稳定性。
常用场景
经典使用场景
FineWeb-Edu-1M数据集作为高质量教育文本资源的精选集合,广泛应用于大型语言模型(LLM)的预训练与微调阶段。其经典使用场景在于筛选出蕴含丰富知识、逻辑严谨的教育类网页内容,为模型注入系统化的学科知识与推理能力。研究者通常利用该数据集构建更高效、更聚焦的学习语料库,以提升模型在问答、事实性知识检索及复杂推理任务中的表现,追求模型泛化能力与专业深度的平衡。
解决学术问题
该数据集有效解决了当前语言模型训练中普遍面临的低质量网络文本噪声问题,为学术研究提供了经过清洗和筛选的教育级数据源。它缓解了模型因训练数据冗杂而导致的生成内容事实性错误、逻辑混乱及知识陈旧等困境。FineWeb-Edu-1M的意义在于树立了数据质量优先的范式,推动研究者重新审视预训练数据的构成,从而提升模型在教育、科学等专业领域的可靠性,对构建可信赖的人工智能系统具有深远影响。
实际应用
在实际应用中,FineWeb-Edu-1M被广泛用于开发智能教育辅导系统、自动化知识问答平台以及学术辅助工具。例如,基于该数据集训练的模型能够为学生提供精准的课程答疑,辅助教师生成教学材料,或支撑科研人员快速检索和理解专业文献。它在降低人工标注成本的同时,确保了模型输出内容与人类知识体系的高度一致性,促进了教育资源的智能化分发与知识服务的普惠化。
数据集最近研究
最新研究方向
fineweb-edu-1m作为经过质量筛选的高质量教育类文本数据集,当前的研究重点聚焦于如何利用其构建更高效的小样本教学场景下的语言模型微调方案。随着教育领域对大规模语言模型(LLMs)在自适应学习、自动问答与知识点提炼等任务中的需求激增,研究者开始关注在有限且精炼的语料上训练出超越大规模通用数据集的模型表现。该数据集约100万条样本的设计,既兼顾了分布式训练中计算资源的现实约束,又保障了教育文本的多样性,从而成为评估知识蒸馏、课程学习及领域适配前沿方法的关键基准。这一方向的研究,正在推动AI教育应用从依赖海量无差别数据,迈向精准、高效、可解释的新阶段。
以上内容由遇见数据集搜集并总结生成


