InstructPapers-TR
收藏资源简介:
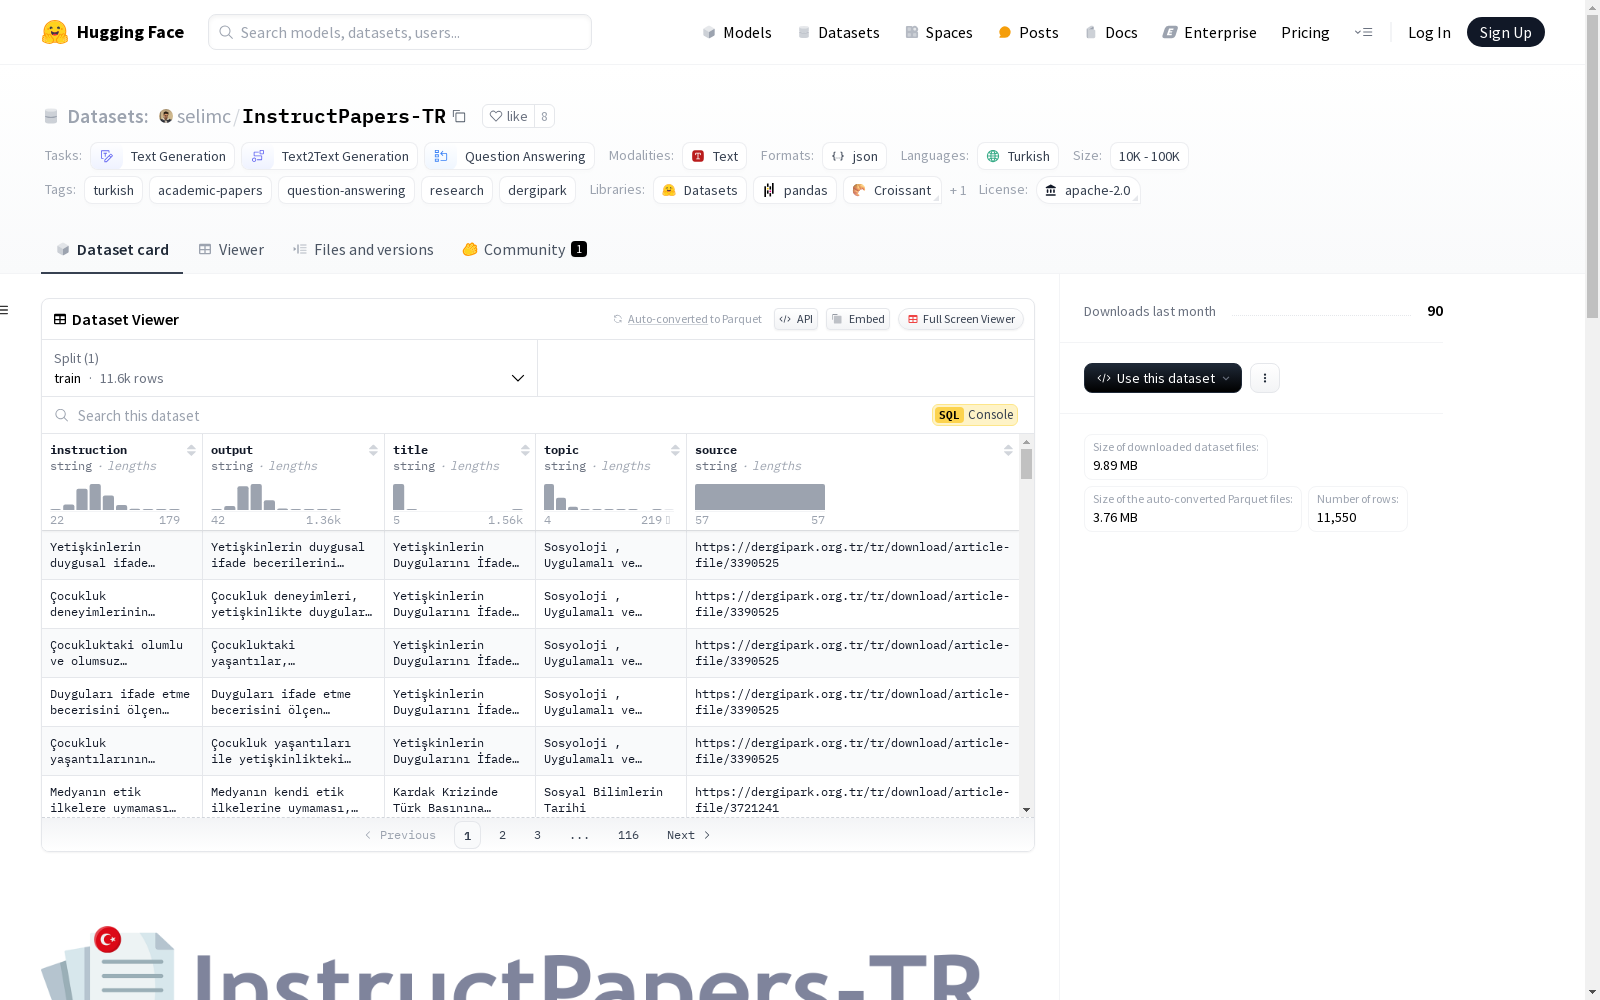
InstructPapers-TR数据集是一个专门从DergiPark上公开的土耳其学术论文中提取的问题回答数据集。数据集包含使用`gemini-1.5-flash-002`模型生成的合成QA对。每个条目都包含源论文的标题、主题和DergiPark URL等元数据。数据集的创建过程包括从DergiPark收集学术论文链接和元数据,处理和分块土耳其论文以生成QA对,使用Google的Gemini 1.5 Flash模型生成QA对,最后过滤和格式化为JSONL文件。数据集包含约11,000个实例,大小为9.89 MB,语言为土耳其语,许可证为apache-2.0。
The InstructPapers-TR dataset is a question-answering dataset specifically extracted from publicly available Turkish academic papers on DergiPark. It contains synthetic QA pairs generated using the `gemini-1.5-flash-002` model. Each entry includes metadata such as the title, subject, and DergiPark URL of the source paper. The dataset creation process includes collecting academic paper links and metadata from DergiPark, processing and chunking Turkish academic papers to generate QA pairs, generating QA pairs with Google's Gemini 1.5 Flash model, and finally filtering and formatting the dataset into JSONL files. The dataset contains approximately 11,000 instances, with a size of 9.89 MB, is in Turkish, and is licensed under Apache-2.0.
InstructPapers-TR Dataset
概述
InstructPapers-TR 是一个专门从 DergiPark 上公开的土耳其学术论文中提取的问题回答数据集。该数据集包含使用 gemini-1.5-flash-002 模型生成的合成 QA 对,每个条目都包含源论文的标题、主题和 DergiPark URL 等元数据。
数据集信息
- 实例数量: 约 11,000 条
- 数据集大小: 9.89 MB
- 语言: 土耳其语
- 许可证: apache-2.0
- 类别: 文本生成
数据字段
instruction: 土耳其语问题output: 土耳其语答案title: 源论文标题topic: 论文主题/类别source: DergiPark
数据创建过程
- 从 DergiPark 收集学术论文链接和元数据,使用 DergiPark-Project。
- 处理和分块土耳其语论文以生成 QA 对。
- 使用 Google 的 Gemini 1.5 Flash 模型生成 QA 对。
- 过滤并格式化结果为 JSONL,包含元数据。
主题分布

归属
- 源论文: DergiPark
- 抓取工具: DergiPark-Project by Alperen Ağa
- QA 生成: Google 的 Gemini 1.5 Flash 模型