
遇见数据集

stellahj/3lf

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

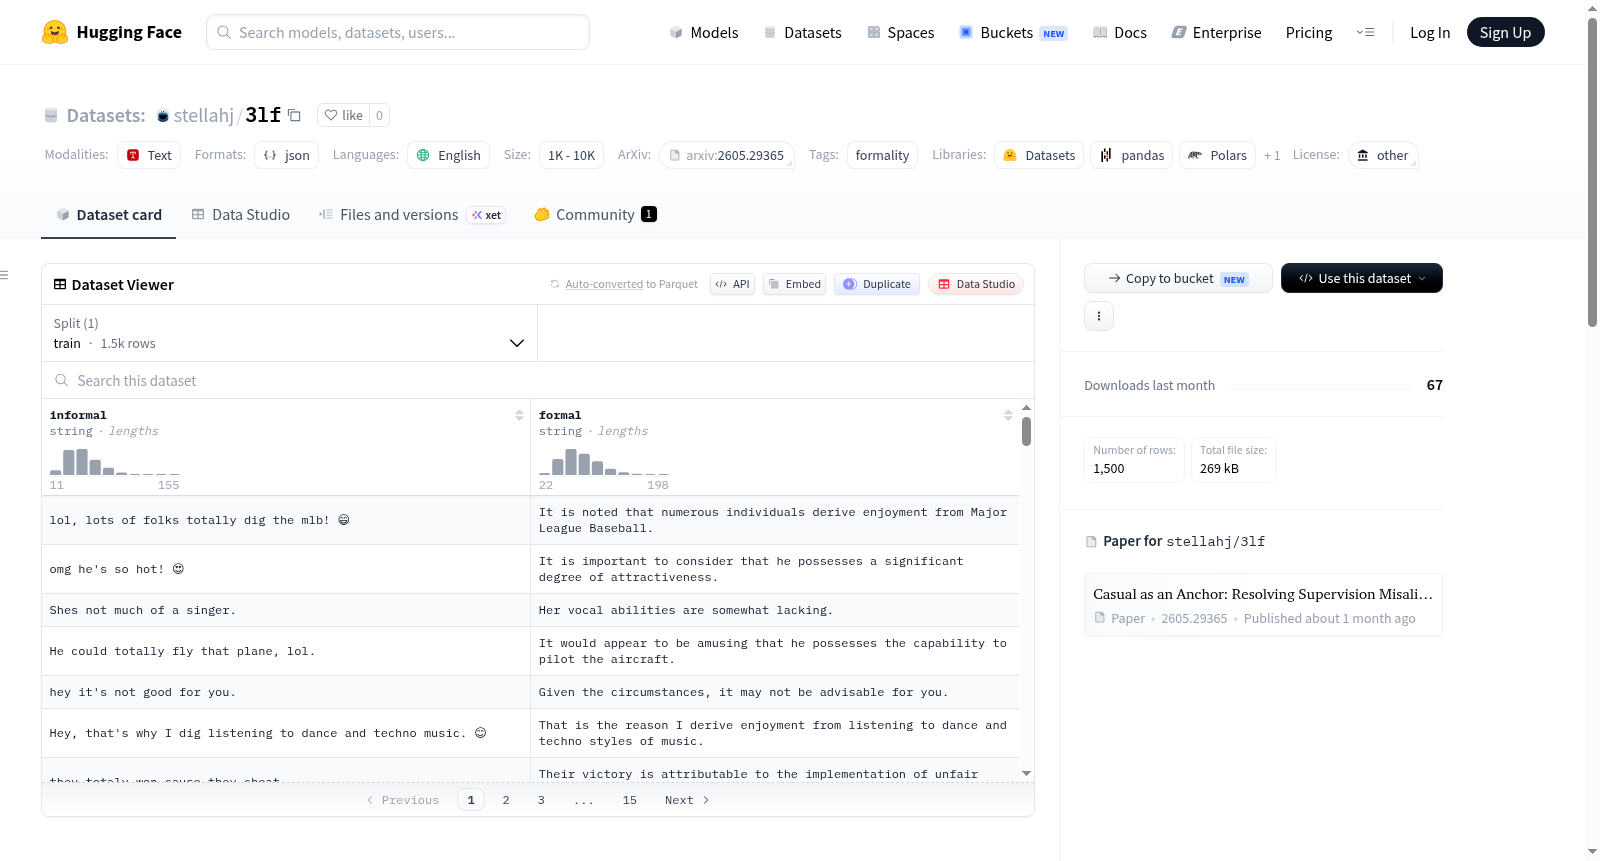
3LF是一个用于三级正式性转换的数据集,包含基于GYAFC语料库示例新创建的非正式和正式改写。

--- 许可协议:其他 语言: - 英语 标签: - 正式度迁移(Formality Transfer) 规范名称:3LF:三级正式度迁移数据集(Three-Level Formality Transfer Dataset) 规模类别: - 样本量介于1000至10000条之间 --- # 3LF:三级正式度迁移数据集(Three-Level Formality Transfer Dataset) ## 概述 3LF是面向三级正式度迁移的数据集,包含从GYAFC语料库(GYAFC Corpus)样本中全新生成的非正式与正式改写文本。配套论文可通过以下链接获取: https://arxiv.org/abs/2605.29365 ## 数据集发布 3LF基于GYAFC语料库的样本构建。为遵循GYAFC原有的分发规则,本次发布仅包含本次全新生成的非正式与正式改写文本,未重新分发GYAFC原始非正式语句。 ## 数据集结构 - `informal`:改写后的非正式语句 - `formal`:改写后的正式语句 ## 引用声明 若您在研究中使用3LF数据集,请引用以下BibTeX条目: bibtex @misc{yu2026casualanchorresolvingsupervision, title={Casual as an Anchor: Resolving Supervision Misalignment in Formality Transfer Dataset}, author={Hyojeong Yu and Hyukhun Koh and Minsung Kim and Kyomin Jung}, year={2026}, eprint={2605.29365}, archivePrefix={arXiv}, primaryClass={cs.CL}, url={https://arxiv.org/abs/2605.29365} } ## 致谢 3LF基于GYAFC语料库的样本构建。本次发布未包含GYAFC原始非正式语句。使用本数据集的用户还需引用以下文献: Rao, S. 与 Tetreault, J. (2018). 《敬启者,容我介绍GYAFC数据集:面向正式度风格迁移的语料库、基准与评测指标》,发表于NAACL-HLT 2018.
提供机构:
stellahj
搜集汇总
数据集介绍
stellahj/3lf 数据集图片
构建方式
3LF数据集专为三层次语体风格迁移任务而设计,其构建基于GYAFC语料库中的示例。为遵循原始数据分发协议,研究人员仅保留了新创作的非正式与正式改写文本,原始GYAFC语料中的随意句并未被重新分发。数据集以成对结构呈现,每一条样本均包含非正式与正式两种表达,为模型学习不同语体粒度间的转换提供了清晰的基准。
特点
该数据集的核心特色在于其细粒度的三层次语体标注,突破了传统语体迁移研究中仅区分正式与非正式的二值化局限。每一对改写文本均经过人工精心创建,确保了语体差异的自然性与真实性。数据集规模适中,涵盖千余条高质量样本,既避免了大规模噪声干扰,又为验证模型在微妙语体转换上的能力提供了可靠测试平台。
使用方法
用户可直接使用数据集中提供的'非正式'与'正式'字段进行语体迁移模型的训练与评估。建议将数据划分为训练、验证与测试子集,并采用序列到序列或基于大型语言模型的框架进行建模。在推理阶段,模型接收非正式输入,生成对应正式输出,通过BLEU、语体分类准确率等指标衡量迁移效果。引用时需同时标注3LF与GYAFC语料库的原著文献。
背景与挑战
背景概述
在文本风格迁移领域中,形式度(formality)的调控一直是自然语言生成的重要课题。2026年,由Hyojeong Yu、Hyukhun Koh、Minsung Kim和Kyomin Jung等研究者提出的3LF(Three-Level Formality Transfer Dataset)数据集,专注于解决形式度迁移任务中监督信号错配的难题。该数据集基于GYAFC语料库中的示例,通过人工创建非正式与正式的改写对,构建了一个包含三级形式度层次的高质量资源。3LF的发布为形式度迁移研究提供了更细粒度的标注数据,推动了该领域从二元形式度分类向多层次、连续化控制的演进,对文本风格迁移、对话系统及人机交互等领域具有重要的学术价值与应用潜力。
当前挑战
3LF数据集所面临的挑战主要来自两方面。首先,在领域问题层面,形式度迁移任务的核心难点在于如何准确界定与量化文本的“正式程度”,传统二元标注(正式/非正式)难以捕捉介于两者之间的细微层次,而多级标注又面临主观性偏差与标注一致性的矛盾。其次,在数据构建过程中,研究团队需从GYAFC语料库中筛选并重新改写例句,这要求在保留原始语义的前提下实现形式度的精确升降,同时避免引入人工痕迹或风格冲突。此外,由于GYAFC原始分布条件的限制,3LF仅能发布新创建的改写对,无法直接复用原文,进一步增加了数据规模与覆盖度的约束,对模型的泛化能力提出了更高要求。
常用场景
经典使用场景
3LF数据集专为三层次正式度迁移任务而设计,其经典使用场景聚焦于自然语言处理中的文本风格转换研究。通过提供成对的非正式与正式改写句子,该数据集使研究者能够训练模型在不同正式度级别间精准转换,尤其适用于从日常口语到书面语、从随意表达到礼貌措辞的跨越。这一资源填补了传统二分类迁移数据的不足,为更细粒度的语言风格调控奠定了坚实基础。
实际应用
在实际应用中,3LF数据集赋能了一系列高价值场景,例如智能写作助手的文本润色功能,可帮助用户将随性表述转化为专业邮件或学术文档;对话系统的礼貌性调节,使AI客服在正式与非正式场合间灵活切换;以及自动翻译中的语体适应,确保跨语言沟通的语境得体性。这些应用不仅提升了人机交互的自然度,还在法律、医疗等对措辞严谨性要求极高的领域展现了巨大潜力。
衍生相关工作
基于3LF数据集,研究者已衍生出多项经典工作,包括提出基于锚定机制的形式性迁移框架,利用非正式句子作为稳定参照以缓解监督偏差;开发多层次风格评估指标,量化迁移结果的形式一致性;以及将三层级标注迁移至多语言场景,拓展了低资源语言的形式性控制能力。这些工作共同构筑了形式性迁移研究的新范式,激励了后续对语言社会属性与计算建模的交叉探索。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

