Mechinterp-dataset-3digits
收藏资源简介:
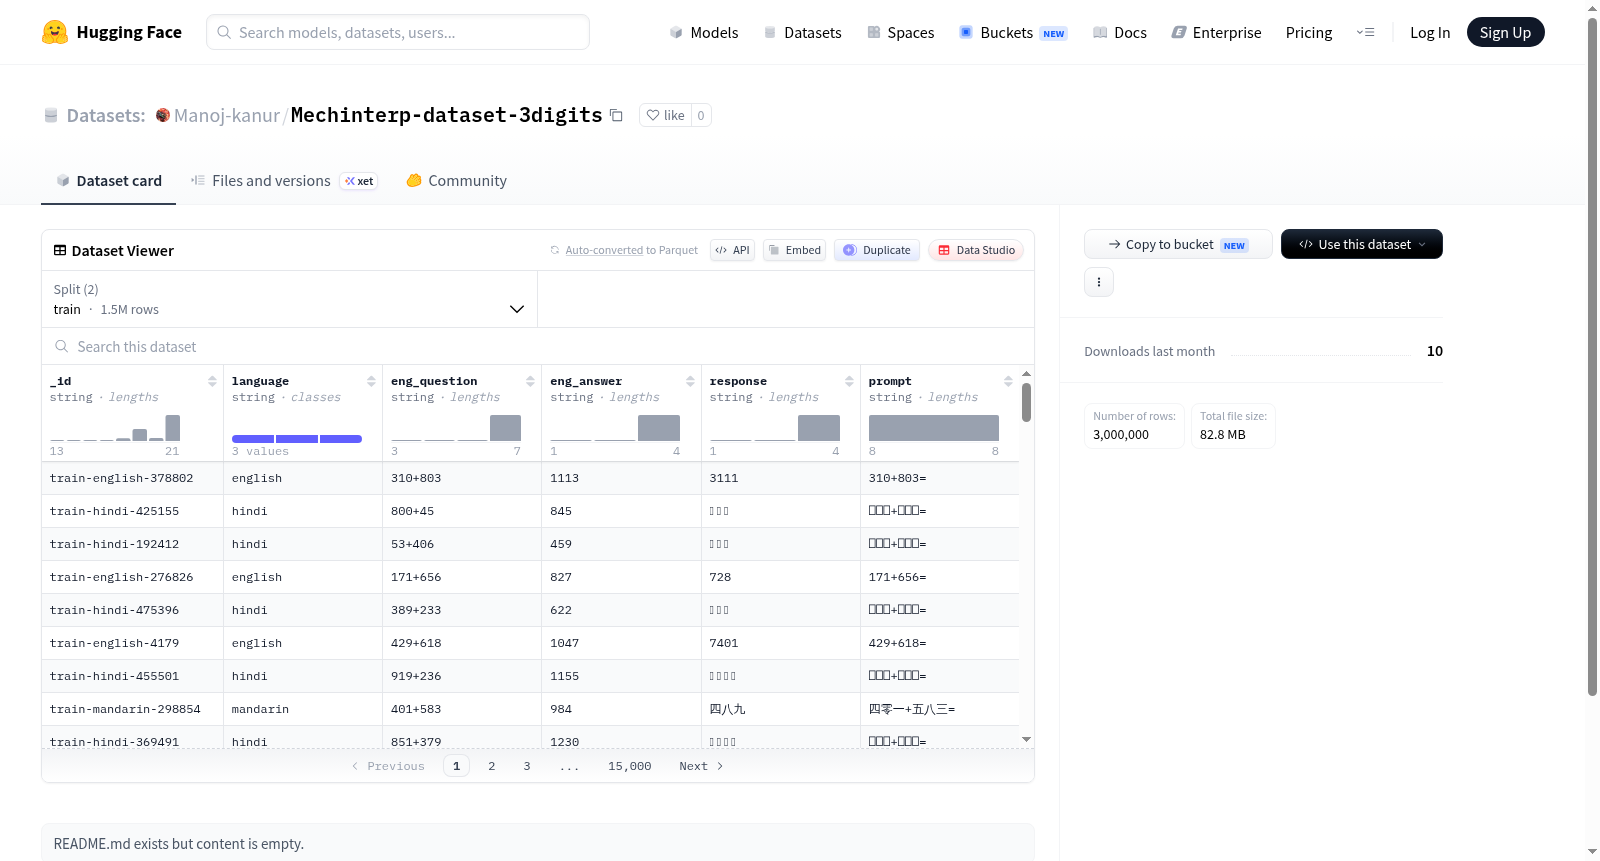
该数据集是一个大规模的多语言问答数据集,包含300万条样本,均匀分为训练集和验证集各150万条。数据集中每条记录包含以下字段:唯一标识符(_id)、语言类型(language)、英文问题(eng_question)、英文答案(eng_answer)、模型响应(response)以及提示词(prompt)。数据集总大小约250MB,下载大小约83MB。从字段结构推断,该数据集适用于多语言对话生成、问答系统训练、语言模型微调等自然语言处理任务,特别是跨语言的知识问答和对话响应生成场景。
This dataset is a large-scale multilingual question answering dataset, containing 3 million samples, which are evenly split into training set and validation set with 1.5 million samples each. Each record in the dataset includes the following fields: unique identifier (_id), language type (language), English question (eng_question), English answer (eng_answer), model response (response), and prompt. The total size of the dataset is approximately 250 MB, and the download size is about 83 MB. Inferred from its field structure, this dataset is suitable for natural language processing tasks such as multilingual dialogue generation, question answering system training, and language model fine-tuning, especially for cross-lingual knowledge question answering and dialogue response generation scenarios.
- 数据集名称:Mechinterp-dataset-3digits
- 数据集大小:约250.6 MB(下载大小约82.8 MB)
- 数据划分:
- 训练集(train):1,500,000 条样本
- 验证集(validation):1,500,000 条样本
- 特征字段:
_id:字符串类型,样本唯一标识language:字符串类型,语言标识eng_question:字符串类型,英文问题eng_answer:字符串类型,英文答案response:字符串类型,模型回复prompt:字符串类型,提示词
- 数据文件:
- 训练集:
data/train-* - 验证集:
data/validation-*
- 训练集:
- 配置:默认配置(
default)