saraiki-dpo-sft-dataset
收藏资源简介:
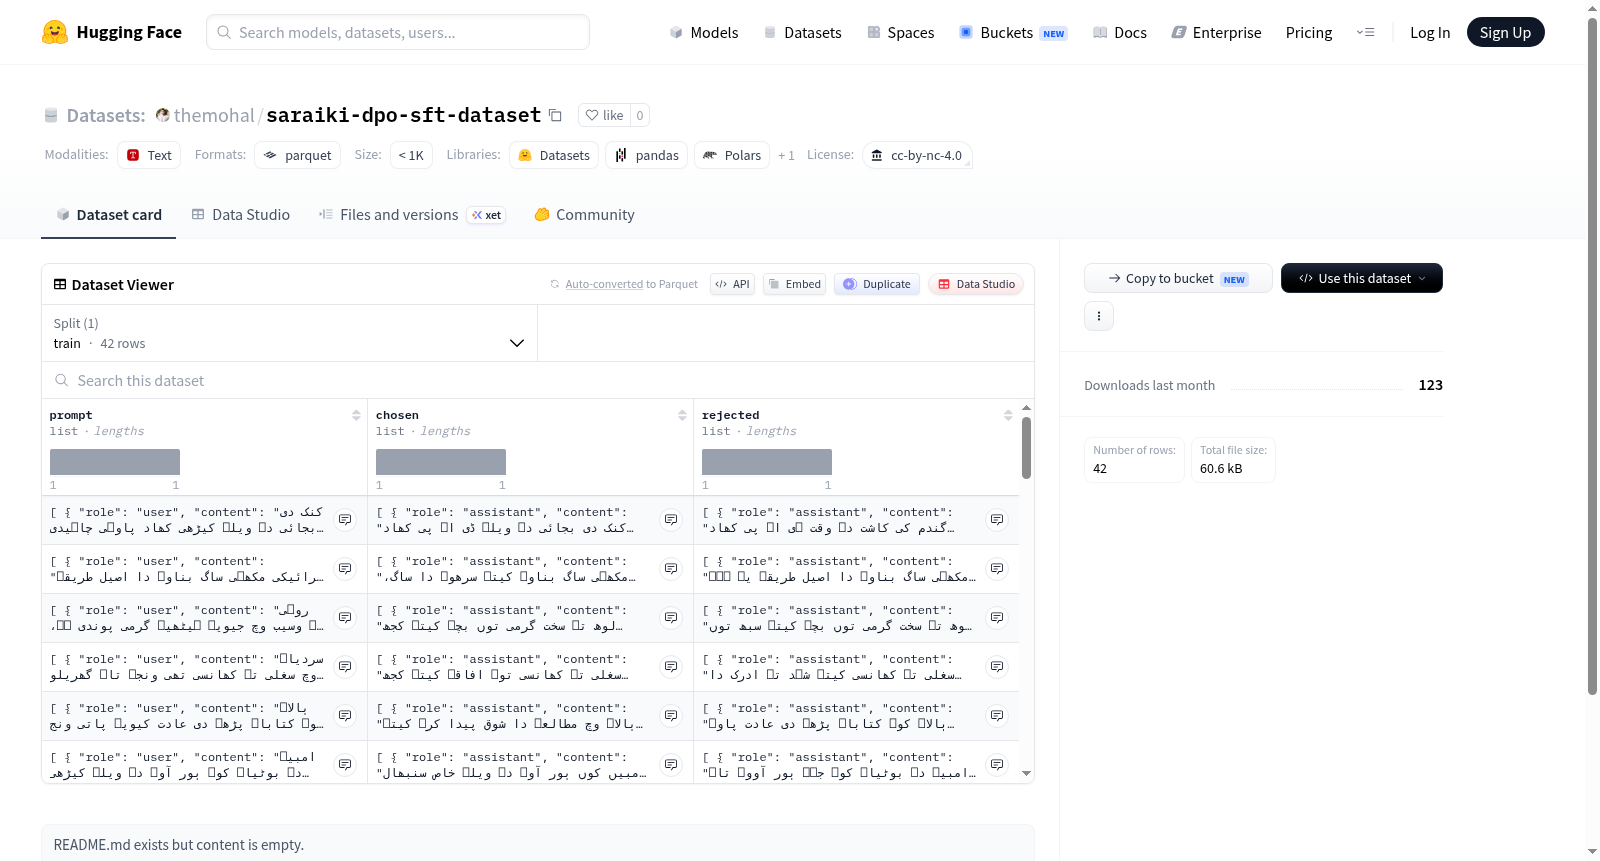
该数据集是一个用于偏好学习(如直接偏好优化 DPO)的对话数据集。数据集包含三个主要字段:prompt(提示)、chosen(被选中的答复)和 rejected(被拒绝的答复)。每个字段由多个对话轮次组成,每个轮次包含角色(role)和内容(content)两部分。数据集仅包含一个训练分割,共 42 个样本,总大小约 50KB。许可证为 CC BY-NC 4.0,适用于非商业用途。
This dataset is a conversation dataset for preference learning (e.g., Direct Preference Optimization, DPO). It contains three main fields: prompt, chosen, and rejected. Each field consists of multiple dialogue turns, each turn containing a role and content. The dataset has only one training split, with 42 samples in total, approximately 50KB in size. It is licensed under CC BY-NC 4.0 for non-commercial use.
Saraiki DPO/SFT 数据集
数据集概述
该数据集为 Saraiki 语言(巴基斯坦旁遮普省南部地区使用的一种语言)的对齐训练数据集,同时支持 DPO(直接偏好优化)与 SFT(监督微调)训练场景。
数据规模与划分
- 训练集样本数:42 条
- 训练集大小:约 50,835 字节(约 49.6 KB)
- 数据集总下载大小:57,555 字节(约 56.2 KB)
数据特征结构
每条数据包含三个字段,每个字段均采用对话格式(包含角色与内容):
| 字段名 | 说明 | 子字段 |
|---|---|---|
prompt |
提示输入(用户的指令或问题) | role(角色)、content(内容) |
chosen |
偏好回答(DPO 中的正样本,SFT 中的目标输出) | role(角色)、content(内容) |
rejected |
拒绝回答(DPO 中的负样本,仅用于 DPO 训练) | role(角色)、content(内容) |
配置文件与文件路径
- 配置名称:
default - 数据文件:位于
data/train-*路径下(实际文件在数据集仓库中) - 数据集划分:仅包含
train一个划分
许可证
本数据集采用 CC BY-NC 4.0(知识共享-署名-非商业性使用 4.0 国际版)许可证,允许非商业性使用,需注明出处。