kunhsiang/eval_exp9_sc4var_put_the_box_on_the_plate_20260527-151946
收藏资源简介:
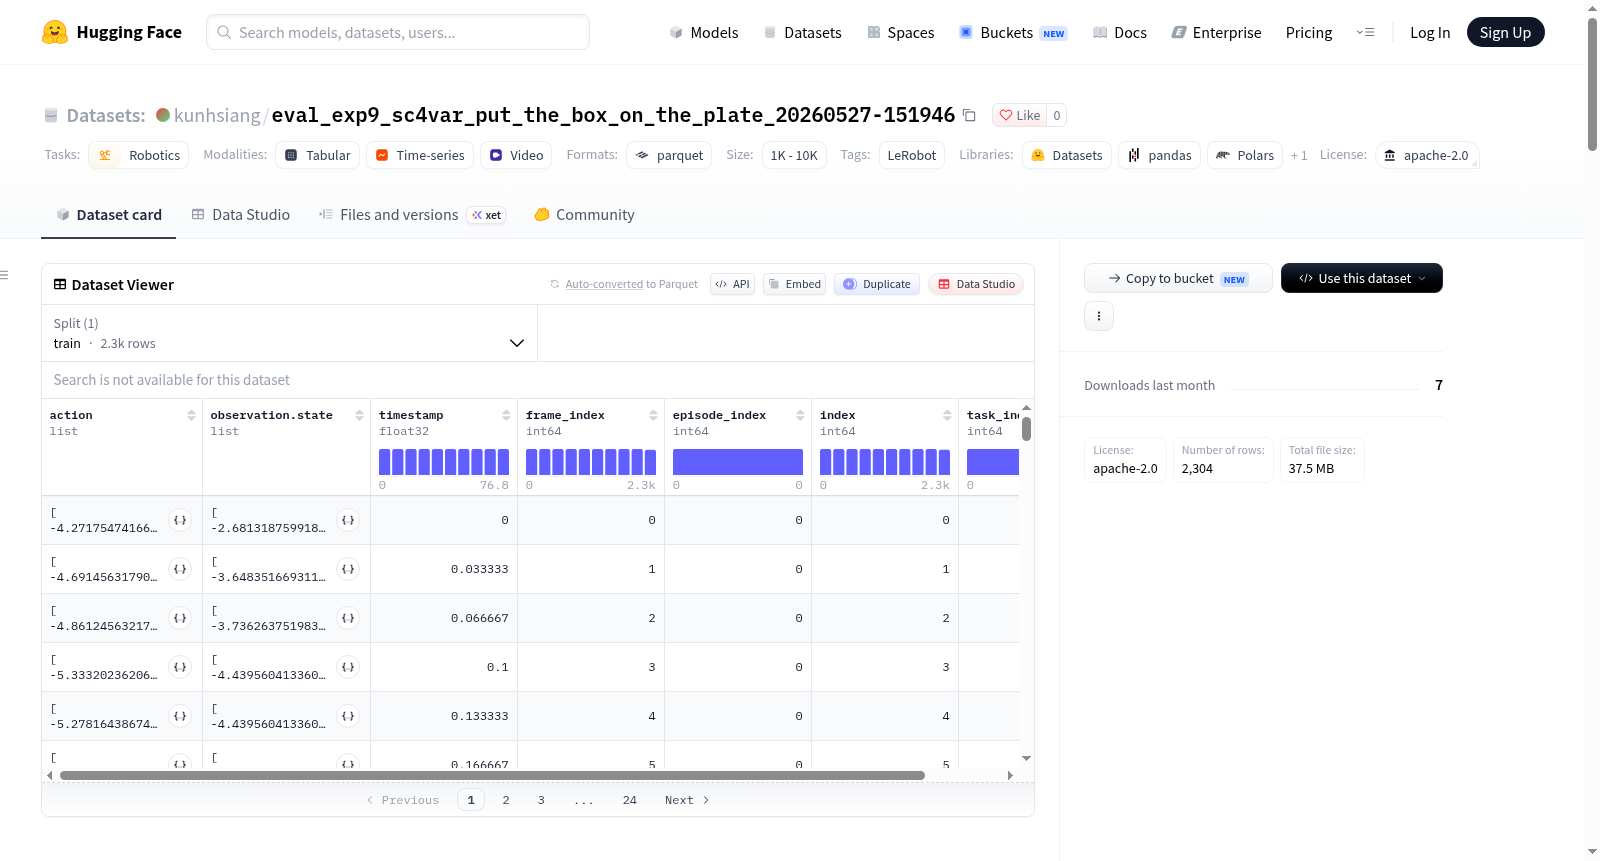
该数据集是通过LeRobot平台创建的机器人学数据集,专门用于机器人控制任务,具体任务为将盒子放在盘子上。数据集包含一个完整的训练集,总共有1个任务、1个episode和2304帧数据,数据以parquet格式存储,视频文件以mp4格式存储。数据集的特征包括机器人的动作(如肩部、肘部、手腕和夹爪的位置)、观测状态(与动作相同的位置信息)以及来自三个摄像头(前视、顶部和夹爪)的图像观测,图像分辨率为480x640,帧率为30fps。此外,还包括时间戳、帧索引、episode索引等元数据。数据集使用Apache 2.0许可证,适用于机器人学习和控制研究。
许可证:Apache-2.0 任务类别: - 机器人学 标签: - LeRobot 配置项: - 配置名称:default 数据文件路径:data/*/*.parquet 本数据集依托LeRobot(https://github.com/huggingface/lerobot)构建。 <a class="flex" href="https://huggingface.co/spaces/lerobot/visualize_dataset?path=kunhsiang/eval_exp9_sc4var_put_the_box_on_the_plate_20260527-151946"> <img class="block dark:hidden" src="https://huggingface.co/datasets/huggingface/badges/resolve/main/visualize-this-dataset-xl.svg"/> <img class="hidden dark:block" src="https://huggingface.co/datasets/huggingface/badges/resolve/main/visualize-this-dataset-xl-dark.svg"/> </a> ## 数据集说明 - **主页**:[需补充更多信息] - **论文**:[需补充更多信息] - **许可证**:Apache-2.0 ## 数据集结构 [meta/info.json]: json { "代码库版本": "v3.0", "机器人类型": "so_follower", "总回合数": 1, "总帧数": 2304, "总任务数": 1, "分块大小": 1000, "数据文件总大小(MB)": 100, "视频文件总大小(MB)": 200, "帧率": 30, "数据集划分": { "训练集": "0:1" }, "数据路径格式": "data/chunk-{chunk_index:03d}/file-{file_index:03d}.parquet", "视频路径格式": "videos/{video_key}/chunk-{chunk_index:03d}/file-{file_index:03d}.mp4", "特征项": { "动作(action)": { "数据类型": "float32", "字段名称": [ "肩关节偏航位置(shoulder_pan.pos)", "肩关节俯仰位置(shoulder_lift.pos)", "肘关节屈伸位置(elbow_flex.pos)", "腕关节屈伸位置(wrist_flex.pos)", "腕关节滚动位置(wrist_roll.pos)", "夹爪位置(gripper.pos)" ], "形状": [ 6 ] }, "观测状态(observation.state)": { "数据类型": "float32", "字段名称": [ "肩关节偏航位置(shoulder_pan.pos)", "肩关节俯仰位置(shoulder_lift.pos)", "肘关节屈伸位置(elbow_flex.pos)", "腕关节屈伸位置(wrist_flex.pos)", "腕关节滚动位置(wrist_roll.pos)", "夹爪位置(gripper.pos)" ], "形状": [ 6 ] }, "前视图像观测(observation.images.front)": { "数据类型": "视频", "形状": [ 480, 640, 3 ], "维度说明": [ "高度", "宽度", "通道数" ], "详细信息": { "视频高度": 480, "视频宽度": 640, "视频编码格式": "av1", "视频像素格式": "yuv420p", "是否为深度图": false, "视频帧率": 30, "视频通道数": 3, "是否包含音频": false } }, "顶视图像观测(observation.images.top)": { "数据类型": "视频", "形状": [ 480, 640, 3 ], "维度说明": [ "高度", "宽度", "通道数" ], "详细信息": { "视频高度": 480, "视频宽度": 640, "视频编码格式": "av1", "视频像素格式": "yuv420p", "是否为深度图": false, "视频帧率": 30, "视频通道数": 3, "是否包含音频": false } }, "夹爪视角图像观测(observation.images.gripper)": { "数据类型": "视频", "形状": [ 480, 640, 3 ], "维度说明": [ "高度", "宽度", "通道数" ], "详细信息": { "视频高度": 480, "视频宽度": 640, "视频编码格式": "av1", "视频像素格式": "yuv420p", "是否为深度图": false, "视频帧率": 30, "视频通道数": 3, "是否包含音频": false } }, "时间戳(timestamp)": { "数据类型": "float32", "形状": [ 1 ], "字段名称": null }, "帧索引(frame_index)": { "数据类型": "int64", "形状": [ 1 ], "字段名称": null }, "回合索引(episode_index)": { "数据类型": "int64", "形状": [ 1 ], "字段名称": null }, "全局索引(index)": { "数据类型": "int64", "形状": [ 1 ], "字段名称": null }, "任务索引(task_index)": { "数据类型": "int64", "形状": [ 1 ], "字段名称": null } } } ## 引用 **BibTeX格式:** bibtex [需补充更多信息]