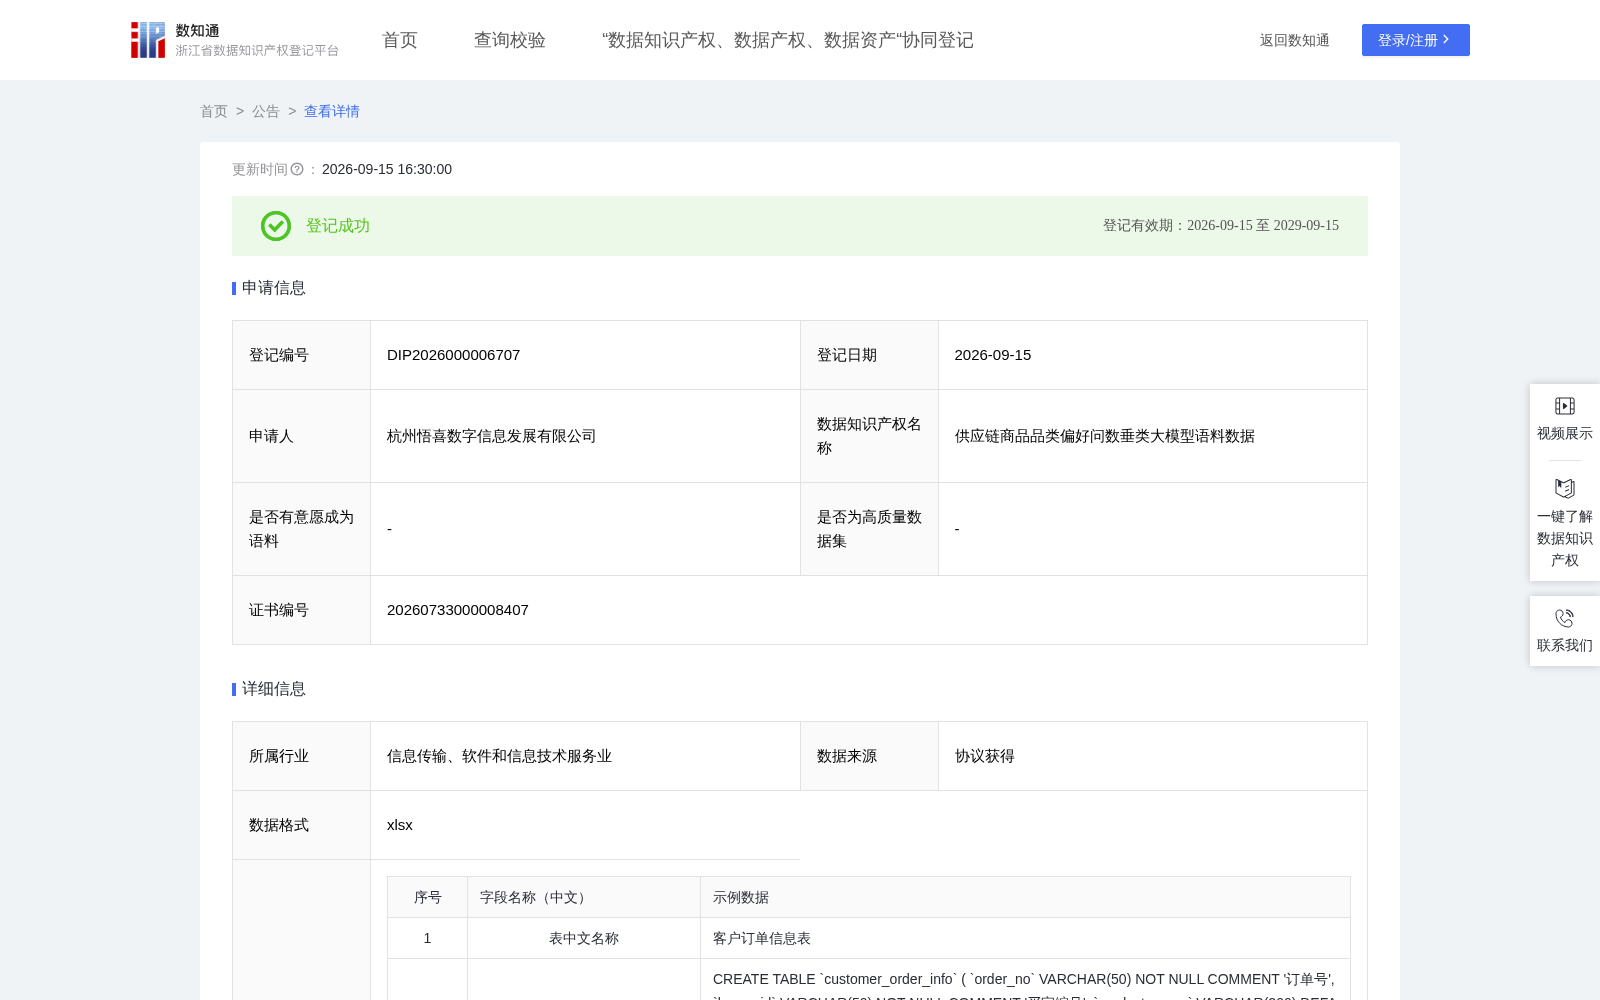
供应链商品品类偏好问数垂类大模型语料数据
收藏资源简介:
本数据专为训练供应链行业商品品类偏好分析领域垂类大语言模型而构建。当前供应链企业日常需查询各品类消费排名、品类渗透率、品类多样性、跨品类关联等数据,但依赖复杂SQL聚合和窗口函数技能导致运营人员无法自主分析。品类偏好数据分散在各订单明细中,跨品类关联和组合偏好分析困难。品类选品策略和品类优化调整响应慢,影响商品布局决策。本数据产品采用Text-to-SQL技术路径,围绕客户订单信息表设计42种典型查询场景,覆盖品类排名统计、品类渗透率计算、品类多样性分析、跨品类关联挖掘、品类组合偏好追踪等场景,生成高质量的问题-SQL-结果三元组训练语料。企业可基于本语料的指标名称问题查询等字段内容,适配自身数据表结构,快速启用文字转SQL功能进行复用。本数据产品作为稀缺的高质量垂直领域语料,对推动供应链品类分析智能化发展提供了有力支撑。1.数据清洗与标准化:按"问数需求+商品分组"去重,剔除重复语料;通过逻辑校验删除矛盾数据;保留"结果输出=无匹配数据"的样本,增强模型对数据缺失场景的处理能力,清洗后数据有效率≥98%。格式统一:统一金额精度(保留2位小数)、百分比格式(保留1位小数);对"商品分组"字段标准化(去除前后空格、统一全半角),补全率100%。2.问题分类与结构化:按"品类排名类""渗透率类""多样性类""跨品类关联类""品类对比类""品类趋势类"等场景分类,标注"查询维度""聚合类型"标签,确保覆盖品类偏好分析90%以上核心需求,构建基础语料库。3.核心算法建模:(1)语义解析与要素提取:采用"预训练模型(BERT-PCP)",对问数需求进行语义切分;通过命名实体识别提取专属要素(如"美妆洗护"为"商品分组","渗透率"映射COUNT(DISTINCT)函数,"排名"映射ROW_NUMBER() OVER窗口函数),要素提取准确率≥96%;(2)SQL生成与初步验证:基于"业务术语-字段名"映射规则,对简单问数调用预设SQL模板,对复杂问数用Seq2Seq模型生成含ROW_NUMBER() OVER窗口函数和GROUP_CONCAT聚合函数及自连接跨品类SQL;生成后通过建表结构校验,SQL语法正确率≥94%;(3)异常值检测:采用IsolationForest算法检测"品类金额为负""渗透率超过100%"等异常SQL,异常语料过滤率≥99%;(4)逻辑核验与业务对齐:结合现场业务知识判断SQL逻辑是否正确。4.语料库迭代优化:构建语料库的闭环迭代机制。新产生的业务问题及其经核验的SQL语句定期注入语料库,通过分析大语言模型在实际应用中的反馈定位薄弱环节并针对性补充,形成"应用-反馈-优化"的良性循环,持续提升语料库的覆盖度和质量。 独立训练必要性说明:本语料聚焦供应链商品品类偏好问数这一细分场景。若与其他领域语料合并训练,会因领域术语、品类层级结构与偏好评估口径的差异,稀释垂类模型对供应链问题的专项能力,并引入无关领域噪声,导致品类偏好问答准确性与稳定性下降。单独构建并训练该垂类语料,可使模型充分学习供应链品类偏好的专属知识体系与问答范式,针对性优化供应链决策支持能力,实现更精准的品类偏好研判与更高效的业务落地,故本语料独立成件、单独训练具有显著技术价值与业务价值。