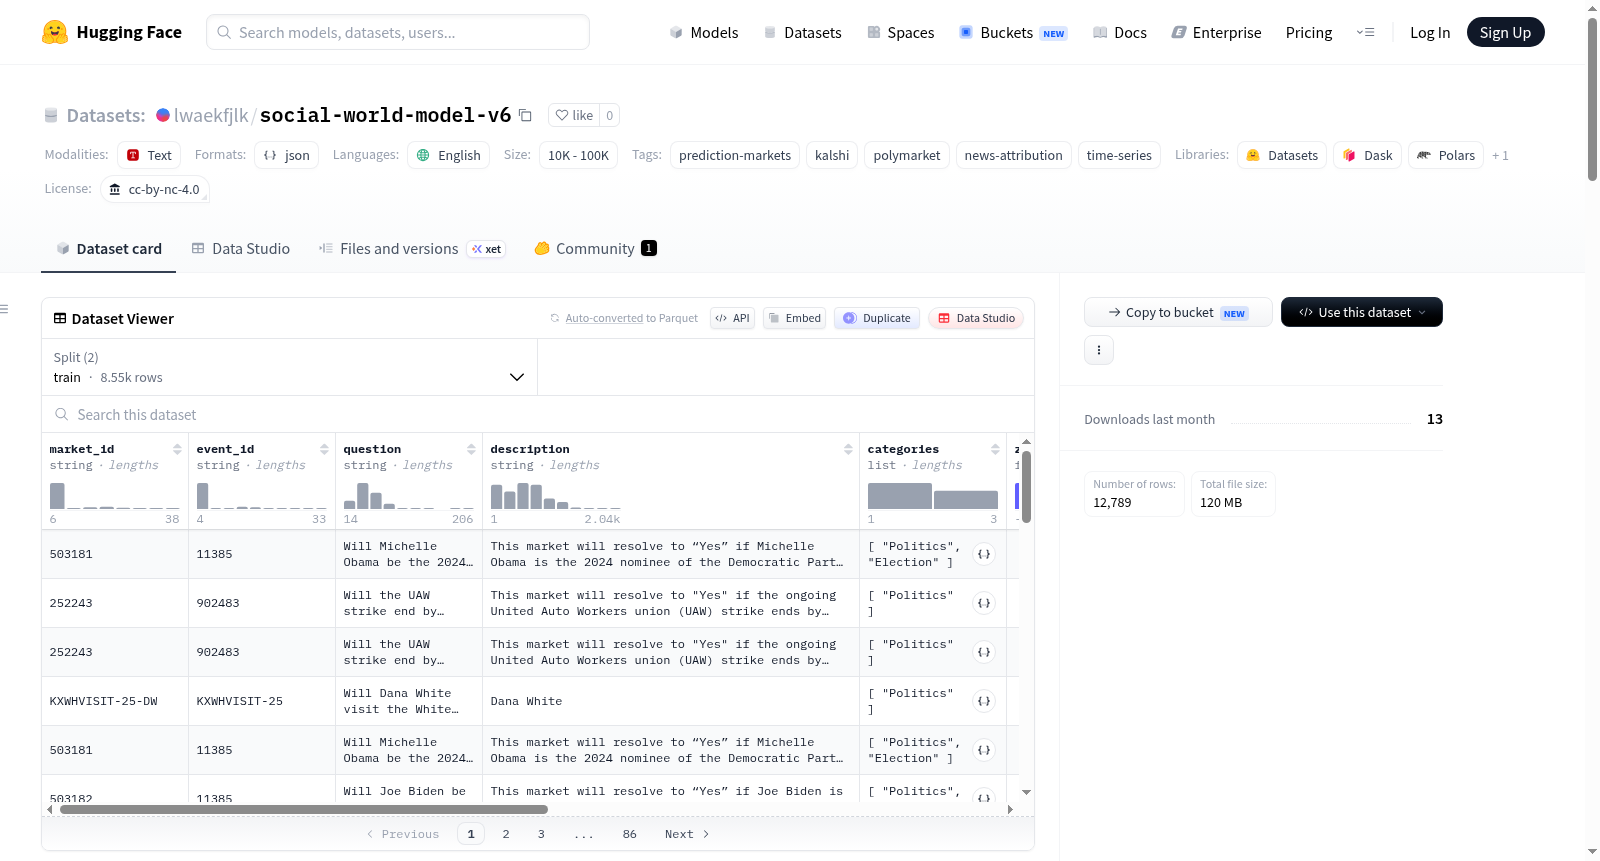
lwaekfjlk/social-world-model-v6
收藏资源简介:
social-world-model-v6是一个用于预测市场和新闻归因分析的数据集,作为v5版本的继任者,它基于Qwen3-32B模型和v3归因提示构建,并通过GNews爬取和GPT-4o-mini关键词过滤进行扩展。数据集新增了1,347条记录,重点关注z-score在[1, 4)区间的中值范围,以改善数据分布。所有记录的description字段已补充完整,并通过该字段消除了Kalshi平台中伞形问题的歧义。模式已精简为10个核心字段,包括market_id、question、description、categories、z_score、news、attributions、history和target。数据集分为训练集和测试集(基于Kalshi和Polymarket),时间分割以2025年11月1日为界。它适用于归因模型训练、预测模型训练和因果新闻检索,但需注意部分记录可能存在归因零值或新闻噪声。数据集遵循CC-BY-NC-4.0许可证,仅供研究使用。
授权协议:CC-BY-NC-4.0 语言:英语 标签: - 预测市场 - Kalshi - Polymarket - 新闻归因 - 时间序列 数据规模类别:10K < 样本数 < 100K # social-world-model-v6 **social-world-model-v6** 是 **social-world-model-v5** 的后继版本。保留了相同的构建流程(Qwen3-32B + v3归因提示词、按候选抓取GNews、GPT-4o-mini关键词过滤),新增**+1,347条新记录**,聚焦于占比偏低的|z| ∈ [1, 4)分数桶,同时完成了若干数据格式清理工作。 ## v6相较于v5的更新要点 1. **更多mid-z分数桶样本**:从|z| ∈ [1, 4)中采样16,000个新候选,按候选抓取GNews(严格3天窗口),使用Qwen3-32B + v3提示词完成归因,经相同的关键词+归因过滤流程合并后,净增1,347条记录(主要为[1, 2)桶增加739条、[2, 4)桶增加608条)。 2. **全记录回填`description`字段**:早期版本仅v3来源的记录包含该字段(约40%),当前99.99%的记录已完成填充(数据取自原始Kalshi/Polymarket处理转储文件)。 3. **通过`description`消除Kalshi通用问题歧义**:626条记录共享事件级通用问题(例如“2025年洪都拉斯将选举谁为总统?”、“特朗普总统将在2026年1月1日前赦免谁?”)。保留原始通用`question`字段不变,`description`字段承载候选/选项标签(例如`Rixi Moncada`、`Eric Adams`)。二者结合可明确每条记录对应的子市场,避免基于规则的问题重写带来的语法瑕疵。 4. **数据格式精简至10个字段**:移除冗余/仅调试用字段(`window_ts`现已可通过`history + [target]`推导得出,移除`before`、`after`、`change`、`sample_type`、`source`、`source_split`、`window_start`、`window_end`、`subtitle`、`question_original`)。 ## 数据集文件 | 文件名 | 样本数 | |---|---| | `train.jsonl` | 8,546 | | `test_kalshi.jsonl` | 760 | | `test_polymarket.jsonl` | 3,483 | **时间拆分规则**:若`target.t < 2025-11-01`则划分为训练集;否则划分为`test_{kalshi,polymarket}`。 **节奏过滤规则**:移除满足`target.t − history[-1].t > 1.5天`的记录(目标时间前的陈旧历史数据)。该操作会移除v6中约7.7%的记录(共1,071条),大多为更新频率较低的Kalshi市场数据;Polymarket记录不受影响(均有约1天的更新节奏)。 ## z分数桶分布 | 分数桶 | 训练集 | test_kalshi | test_polymarket | |---|---|---|---| | [0, 0.5) | 869 | 154 | 854 | | [0.5, 1) | 508 | 173 | 646 | | [1, 2) | 1,749 | 266 | 742 | | [2, 4) | 1,608 | 191 | 286 | | [4, 8) | 2,679 | 186 | 580 | | [8, 16) | 1,092 | 45 | 264 | | [16+) | 832 | 25 | 111 | 相较于v5版本:训练集的[1, 2)桶增加565条,[2, 4)桶增加558条;其余桶无变化。训练集的mid-z分数桶占比从27.2%提升至36.0%。 ## 数据格式(Schema) json { "market_id": "...", // Kalshi(字母前缀)或 Polymarket(数字前缀) "event_id": "...", // 市场所属的通用事件ID "question": "Will X happen by ...?", // 已针对候选修改(已应用通用问题重写) "description": "...", // 决议规则(Polymarket)或候选名称(Kalshi) "categories": ["Politics", ...], "z_score": 5.4, // 带符号分数:sign(Δp) * |z|,统一中位数绝对偏差(Median Absolute Deviation, MAD)并设置σ下限 "news": [ {"title": "...", "description": "...", "url": "...", "published_at": "2025-11-24T11:02:17Z", "source": "..."} ], "attributions": [ // 按news_idx与`news`字段对齐 {"news_idx": 0, "score": 0.0} // 得分范围0~1,由Qwen3-32B + v3提示词生成 ], "history": [{"t": ..., "p": ...}, ...], // 16个点的输入序列 "target": {"t": ..., "p": ...} // 1个点的预测目标 } ## 构建流程 1. **候选采样**:基于Kalshi + Polymarket时间序列,使用滑动17点窗口生成样本,统一z分数并设置σ下限(`z = (|Δp| − 中位数) / max(MAD × 1.4826, 0.01)`)。 2. **新闻抓取**:调用GNews API,按候选设置3天窗口(`DAYS_BEFORE=3, DAYS_AFTER=0`,严格满足`< target.t`)。 3. **实体-关键词查询**:由GPT-4o-mini从每个问题中提取类似`"Donald Trump" OR "Trump campaign"`的搜索查询,已缓存。 4. **归因**:使用Qwen3-32B(TP=8)搭配v3提示词;每条新闻的独立得分∈{0, 0.2, 0.4, 0.6, 0.8, 1.0}。|z|<1的记录将自动跳过(所有新闻得分设为0)。 5. **过滤**:保留新闻当且仅当`score > 0`或文本匹配问题关键词;过滤后无有效新闻的记录将被移除。 6. **时间拆分+去重**:按`target.t < 2025-11-01`拆分数据集;按`(market_id, target.t)`进行去重。 7. **问题/描述修复(仅v6)**:从原始数据回填缺失的`description`字段;使用`subtitle`重写通用Kalshi问题。 8. **数据格式裁剪**:仅保留上述10个必要字段。 ## 预期用途 - **归因器训练**:基于(问题、历史数据、目标值、新闻)学习每条新闻的因果权重∈[0, 1]。 - **预测器训练**:基于(问题、描述、历史数据、新闻)预测`target.p`。 - **因果新闻检索**:筛选`attributions[*].score > 0.5`以保留置信度最高的因果新闻。 ## 注意事项 - 训练集中约26%的记录归因得分全为0(仅通过关键词匹配得以保留)。|z|≥4的高z分数桶中,94%~97%的记录归因得分非零;|z| ∈ [1,4)的桶中约70%的记录归因得分非零。 - 仍有2条记录的`description`字段为空(来自Kalshi历史数据,未出现在任何原始转储文件中)。 - 对于Kalshi的按候选划分的子市场,`question`字段为原始事件级通用问题;候选标签位于`description`字段中。训练代码应同时使用这两个字段。 - Polymarket的多结果市场仍存在问题歧义(例如“谁将赢得皮内拉斯县选举?”未附带候选标签);v6版本尚未对这类情况进行消歧。 - 新闻片段来自GNews;小众市场(例如洪都拉斯总统选举)的新闻命中率较低,宽泛的查询会引入大量无关噪声(归因过滤器会过滤掉此类噪声,但训练代码应具备对噪声检索的鲁棒性)。 ## 授权协议 CC-BY-NC-4.0 — 仅可用于研究用途。GNews的新闻片段受各自来源的条款约束。