
遇见数据集

Realmbird/nla-thought-anchors-answer-step1

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

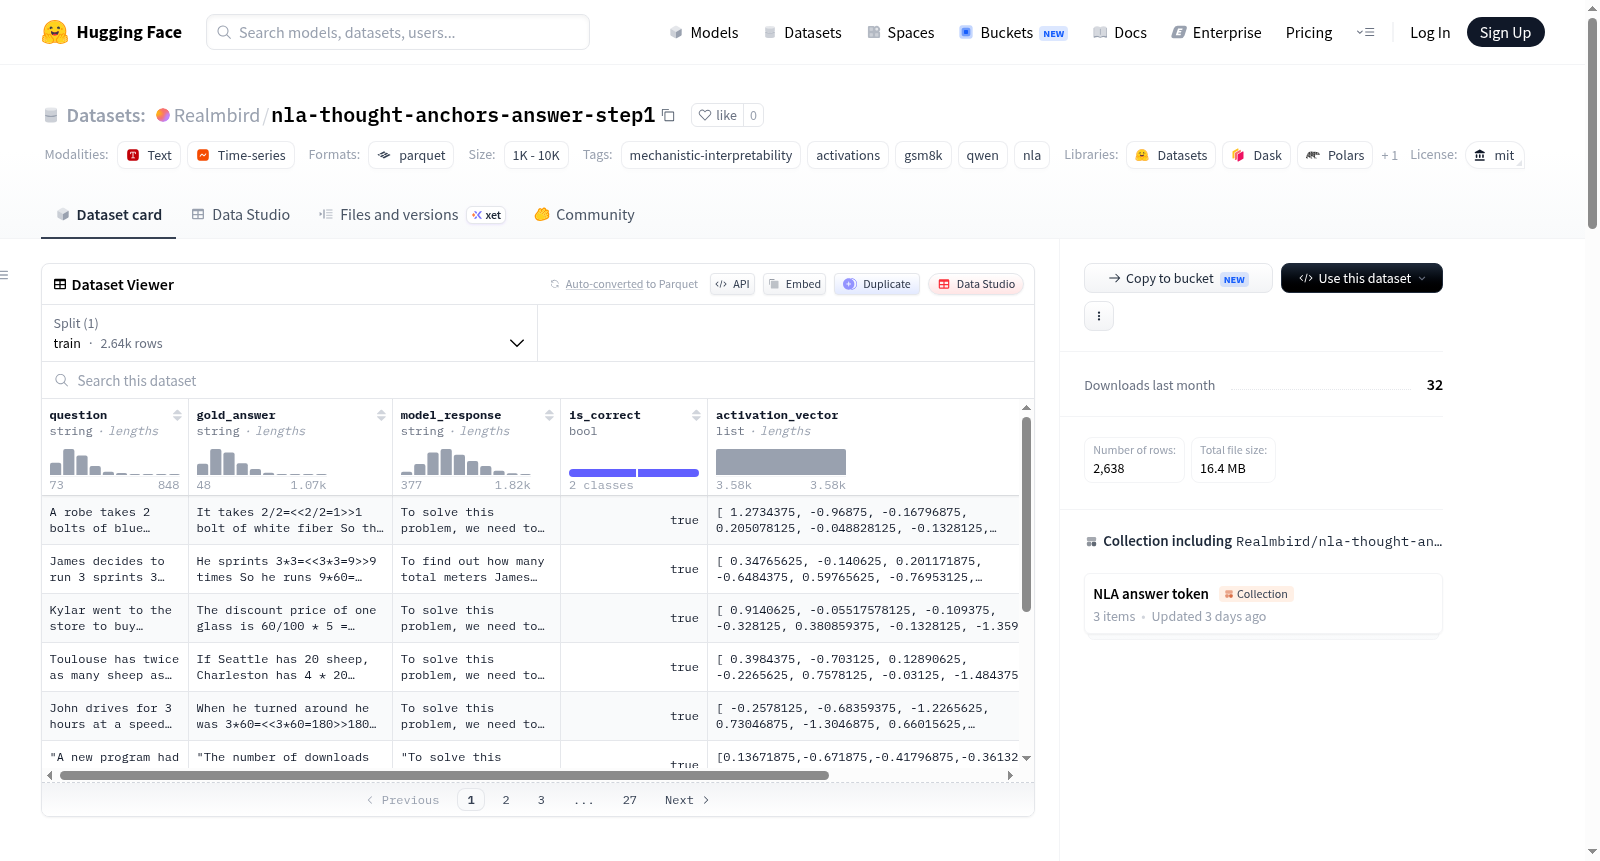
该数据集名为nla-thought-anchors-answer,是nla-thought-anchors项目的一部分,该项目复现并扩展了关于自然语言自编码器的研究。数据集包含从Qwen2.5-7B-Instruct模型第20层(0索引,残差流在Transformer块之后)提取的激活向量,提取位置在模型生成响应中####标记后的第一个答案数字令牌处。提取采用完整回滚方法:模型先生成完整的思维链响应,然后在完整序列(提示+响应)上进行第二次前向传播,捕获####后第一个数字处的隐藏状态。在此位置,答案值已不再是预测,而是被写入序列中成为上下文的一部分,因此这比任何早期提取点都更直接地编码了特定答案。数据集基于GSM8K测试集,包括问题文本、真实答案(含####标记)、模型生成响应、正确性标志(布尔值)、激活向量(长度为3584的float32列表)和示例索引(原始GSM8K测试分割中的索引)。数据分为correct(708个样本)和incorrect(611个样本)两个子集,总计1319个样本。

This dataset, named nla-thought-anchors-answer, is part of the nla-thought-anchors project, which reproduces and extends research on natural language autoencoders. The dataset contains activation vectors extracted from the 20th layer (0-indexed, residual stream post-Transformer block) of the Qwen2.5-7B-Instruct model, at the position of the first answer-related numerical Token immediately following the #### delimiter in the model's generated response. The extraction adopts the full rollback method: the model first generates a complete Chain-of-Thought (CoT) response, then performs a second forward pass over the full sequence (prompt + response) to capture the hidden state at the first numerical Token immediately following ####. At this position, the answer value is no longer a prediction but has been written into the sequence as part of the context, thus encoding the specific answer more directly than any earlier extraction points. Built upon the GSM8K test split, the dataset includes question text, ground-truth answers (accompanied by the #### delimiter), model-generated responses, correctness flags (boolean values), activation vectors (float32 lists of length 3584), and example indices (their corresponding indices in the original GSM8K test split). The dataset is split into two subsets: correct (708 samples) and incorrect (611 samples), with a total of 1319 samples.
提供机构:
Realmbird
搜集汇总
数据集介绍
Realmbird/nla-thought-anchors-answer-step1 数据集图片
构建方式
该数据集源于对Qwen2.5-7B-Instruct模型在GSM8K测试集上进行全序列生成时中间层表征的捕获。具体而言,研究者在模型完成完整思维链推理后,于第20层残差流中提取了首个紧接“####”标记后的答案数字token所对应的激活向量。此时答案值已被写入序列并成为上下文的一部分,因此该位置编码了最为直接且明确的答案信息,相较于其他提取点蕴含更强的信号。
特点
数据集共包含1319个样本,按模型回答正确与否划分为correct(708条)与incorrect(611条)两个子集。每个样本不仅提供了问答文本与模型完整输出,还存储了大小为3584维的激活向量,为探究模型内部数字推理机制提供了高保真度的神经表征素材。数据采用float32精度存储,确保了数值稳定性与计算兼容性。
使用方法
用户可通过HuggingFace的datasets库直接加载该数据集,调用load_dataset("Realmbird/nla-thought-anchors-answer")后,可分别访问correct与incorrect两个子集。激活向量可便捷地转换为NumPy数组格式,例如np.array(correct["activation_vector"], dtype=np.float32),从而支持后续的统计分析、可视化或作为机械可解释性研究的输入特征。
背景与挑战
背景概述
在机械可解释性(Mechanistic Interpretability)领域,如何将神经网络内部的高维激活状态映射为人类可理解的语义概念始终是核心难题。nla-thought-anchors-answer-step1数据集由Realmbird团队于2024年创建,依托Qwen2.5-7B-Instruct模型,聚焦于GSM8K数学推理任务中答案生成阶段的神经表征分析。该数据集在模型第20层残差流中,提取了模型生成“####”标记后首个答案数字token处的激活向量,旨在捕捉答案被明确写入上下文后的最直接编码。作为自然语言自编码器(NLA)研究的扩展工作,该数据集为探索语言模型内部答案锚点(thought anchors)的语义结构提供了关键基准,其细粒度的位置对比设计(如与哈希标记位置对比)显著推动了可解释性研究中激活-语义对齐的量化分析。
当前挑战
数据集面临的核心挑战体现在领域问题与构建过程两个层面。在领域问题层面,现有可解释性工具难以精准定位数学推理中答案生成的具体神经通路,该数据集通过固定提取位置(第20层、答案token)解决了“何时何处捕获答案信号”的歧义,但如何区分模型对答案的预测、确认与记忆信号仍是开放问题。构建过程中,由于GSM8K答案格式包含“####”分隔符,不同推理步骤的答案长度差异导致提取token的语义一致性难以保证;此外,激活向量在1319个样本中仅按正确性分为708/611两个子集,样本量有限且缺乏针对错误模式的细粒度标注,限制了泛化到多步推理错误的解释能力。
常用场景
经典使用场景
在机械可解释性(Mechanistic Interpretability)研究领域,该数据集作为从Qwen2.5-7B-Instruct模型第20层残差流中提取的激活值集合,为探索大型语言模型内部的数学推理机制提供了关键的数据基础。其经典使用场景聚焦于分析模型在GSM8K数学应用题测试集上生成答案时,在第一个答案数字token处的神经活动状态。研究者通过获取该特定位置的高维激活向量(维度3584),能够精确定位语言模型在完成数学推理并输出答案瞬间所编码的语义信息,从而为理解模型如何从链式思维推理过渡到最终答案生成这一认知环节提供了可量化的观测窗口。
实际应用
在实际应用层面,该数据集支撑着自然语言自编码器(Natural Language Autoencoders)技术的开发与评估,使得研究者能够训练出将高维神经激活映射到可解释自然语言短语的解码器。通过分析答案token处的激活模式,工程人员可以构建更为精准的模型行为监控系统,例如实时检测数学推理中的错误模式或识别模型在特定问题上的不确定性。此外,这些激活数据也可用于开发模型编辑和知识修正技术,通过对特定推理步骤的神经表征进行定向调整,提升模型在标准数学任务上的可靠性和准确性。
衍生相关工作
该数据集衍生了一系列具有代表意义的研究进展,包括基于'####'标记位置的变体数据集nla-thought-anchors-hash、针对答案token激活向量的自然语言描述数据集nla-av-explanations,以及配套的NLA演员(actor)和评论家(critic)模型检查点。这些衍生工作构建了完整的从激活提取到语义解释的技术栈,推动了自然语言自编码器方法在机械可解释性领域的系统化应用。相关工作已复现并扩展了Ryan Greenblatt关于语言模型内部结构自然涌现语义编码的发现,为后续研究提供了可复现的基准框架和标准化评估工具。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

