遇见数据集

atmallen/fever

收藏
Hugging Face2023-08-08 更新2024-03-04 收录
官方服务:

资源简介:

--- dataset_info: features: - name: id dtype: int32 - name: label dtype: class_label: names: '0': REFUTES '1': SUPPORTS - name: claim dtype: string - name: evidence_annotation_id dtype: int32 - name: evidence_id dtype: int32 - name: evidence_wiki_url dtype: string - name: evidence_sentence_id dtype: int32 - name: ev_sentence dtype: string - name: ev_paragraph dtype: string splits: - name: train num_bytes: 45894925.26486 num_examples: 27129 - name: validation num_bytes: 6624298.64 num_examples: 4912 - name: test num_bytes: 10877370.514204947 num_examples: 7199 download_size: 20846819 dataset_size: 63396594.41906495 --- # Dataset Card for "fever" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

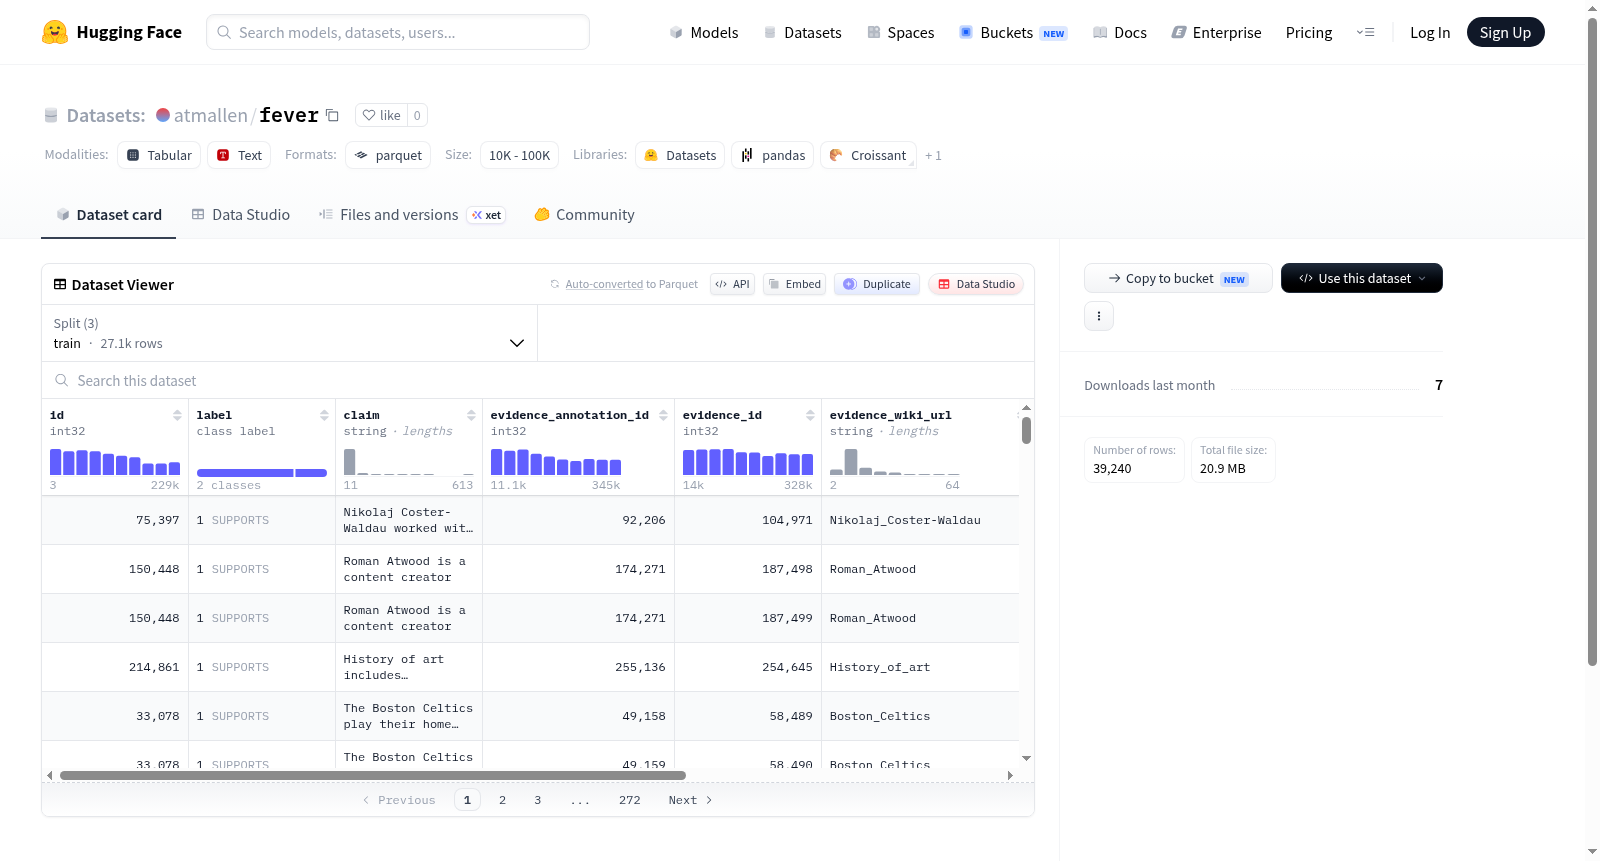
## 数据集信息 ### 特征项 - 字段名:id,数据类型:32位整数(int32) - 字段名:label,数据类型:类别标签(class_label),类别映射如下: '0': 驳斥(REFUTES) '1': 支持(SUPPORTS) - 字段名:claim,数据类型:字符串 - 字段名:evidence_annotation_id,数据类型:32位整数(int32) - 字段名:evidence_id,数据类型:32位整数(int32) - 字段名:evidence_wiki_url,数据类型:字符串 - 字段名:evidence_sentence_id,数据类型:32位整数(int32) - 字段名:ev_sentence,数据类型:字符串 - 字段名:ev_paragraph,数据类型:字符串 ### 数据集划分 - 划分集:train(训练集),数据字节数:45894925.26486,样本量:27129 - 划分集:validation(验证集),数据字节数:6624298.64,样本量:4912 - 划分集:test(测试集),数据字节数:10877370.514204947,样本量:7199 ### 数据集规模 - 下载大小:20846819 - 数据集总大小:63396594.41906495 --- # "FEVER"数据集卡片 [如需补充更多信息,请访问](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
atmallen
原始信息汇总

数据集概述

数据集名称

  • 名称: fever

数据集特征

  • id: 整数类型 (int32)
  • label: 分类标签,包含两个类别:
    • 0: REFUTES
    • 1: SUPPORTS
  • claim: 字符串类型 (string)
  • evidence_annotation_id: 整数类型 (int32)
  • evidence_id: 整数类型 (int32)
  • evidence_wiki_url: 字符串类型 (string)
  • evidence_sentence_id: 整数类型 (int32)
  • ev_sentence: 字符串类型 (string)
  • ev_paragraph: 字符串类型 (string)

数据集分割

  • 训练集:
    • 样本数: 27129
    • 数据大小: 45894925.26486 字节
  • 验证集:
    • 样本数: 4912
    • 数据大小: 6624298.64 字节
  • 测试集:
    • 样本数: 7199
    • 数据大小: 10877370.514204947 字节

数据集大小

  • 下载大小: 20846819 字节
  • 总数据集大小: 63396594.41906495 字节
搜集汇总
数据集介绍
atmallen/fever 数据集图片
构建方式
在事实核查与自然语言推理领域,FEVER数据集作为一项关键基准,通过系统化地整合维基百科证据来验证声明真伪。该数据集以声明(claim)为核心,每一条样本均关联来自维基百科的段落级及句子级证据,并标注为“支持”(SUPPORTS)或“反驳”(REFUTES)两类。构建过程中,数据采集自公开的FEVER挑战赛,经过严格的人工标注与交叉验证,确保证据与声明之间的逻辑一致性。数据集包含训练集27129例、验证集4912例及测试集7199例,覆盖多样化的声明类型,为模型训练提供了丰富的对抗性样本。
特点
该数据集的核心特色在于其多粒度证据结构,每条样本不仅包含声明文本和标签,还精细记录了证据来源的维基百科URL、段落内容、句子内容及对应的证据ID与标注ID,支持从句子级到段落级的细粒度推理。此外,数据集的标签体系简洁明确,仅包含二分类任务,降低了任务复杂度却提升了可解释性。证据的跨文档关联性使得模型需具备从异构文本中提取关键信息的能力,从而推动更鲁棒的事实核查技术发展。
使用方法
用户可通过HuggingFace Datasets库直接加载atmallen/fever数据集,调用load_dataset函数即可获取预设的三分片数据。使用时需注意,数据集默认以整数编码标签,需通过features中的class_label映射转换为文本标签。适用于构建声明验证模型,典型流程包括将claim与ev_sentence拼接作为输入,利用预训练语言模型(如BERT)进行二分类微调。评估时可采用准确率与F1分数,尤其需关注模型对证据段落中隐含矛盾的识别能力。
背景与挑战
背景概述
在自然语言处理领域,事实核查(Fact Verification)作为一项关键任务,旨在自动判断文本声明的真实性,以应对信息爆炸时代虚假信息泛滥的挑战。atmallen/fever数据集基于FEVER(Fact Extraction and VERification)任务构建,由伦敦大学学院等机构的研究人员于2018年提出,核心研究问题在于从维基百科中提取证据并验证声明是否被支持或反驳。该数据集包含超过3.9万个样本,每个样本由声明、标签(SUPPORTS或REFUTES)以及对应的维基百科证据段落组成,为事实核查系统的训练与评估提供了标准化基准。其影响力深远,不仅推动了自动事实核查技术的发展,还被广泛应用于谣言检测、知识验证等下游任务,成为领域内不可或缺的评估资源。
当前挑战
atmallen/fever数据集所解决的领域问题在于,事实核查系统需从海量文本中精准定位相关证据并判断声明真实性,这一过程面临证据稀疏性、声明歧义性及多跳推理等挑战。在构建过程中,研究人员需从维基百科中人工标注证据段落,确保标注一致性与覆盖度,但不同标注者对证据关联性的理解差异可能导致质量波动。此外,数据集中声明与证据的匹配可能引入偏见,例如支持性证据更易被收录,而反驳性证据的收集则需更复杂的检索策略。这些挑战要求模型具备鲁棒的跨文本推理能力,同时需设计更高效的证据检索与验证框架,以应对现实场景中声明多样性与证据动态更新的难题。
常用场景
经典使用场景
在自然语言处理与事实核查领域,FEVER数据集作为一项标志性资源,被广泛用于构建和评估基于证据的谣言检测系统。该数据集精心设计了“SUPPORTS”与“REFUTES”两类标签,并提供了从维基百科中抽取的句子级证据,使得模型能够学习如何将文本主张与可验证的源信息进行比对。其经典使用场景聚焦于训练端到端的推理模型,要求系统不仅判断主张的真伪,还需定位支撑其结论的具体证据段落,从而推动了对可解释性AI的深入探索。
解决学术问题
FEVER数据集的核心学术贡献在于解决了事实核查任务中缺乏大规模、高质量标注语料的瓶颈问题。它系统性地整合了主张、证据与标签三元组,为研究者提供了标准化的评估基准,从而有效度量模型在开放域信息验证上的泛化能力。该数据集催生了对多跳推理、跨文档证据融合以及对抗性噪声鲁棒性等关键学术议题的探讨,其发布极大促进了自然语言推理与信息检索交叉领域的发展,成为检验模型逻辑理解与知识运用水平的经典标尺。
衍生相关工作
围绕FEVER数据集衍生出一系列经典工作,包括基于图神经网络的证据聚合模型、融合外部知识库的增强型推理框架,以及针对对抗性样本的鲁棒性训练方法。其中,UKP-athene团队提出的多任务学习架构将句子选择与关系分类联合优化,显著提升了证据召回率;而剑桥大学推出的分层注意力网络则通过建模证据间的长程依赖,实现了对复杂主张的精准判别。这些工作共同构建了从数据驱动到算法创新的完整研究链条,持续推动事实核查技术的边界拓展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务