
Grammarly Corpus of Discourse Coherence
收藏数据链接:
官方服务:
资源简介:
Grammarly Discourse Coherence语料库,用于评估和开发话语连贯性模型,部分基于Yahoo Answers语料库构建。
Grammarly 语篇连贯性语料库,旨在评估与开发语篇连贯性模型,其中部分内容基于 Yahoo Answers 语料库构建。
创建时间:
2018-05-10
原始信息汇总
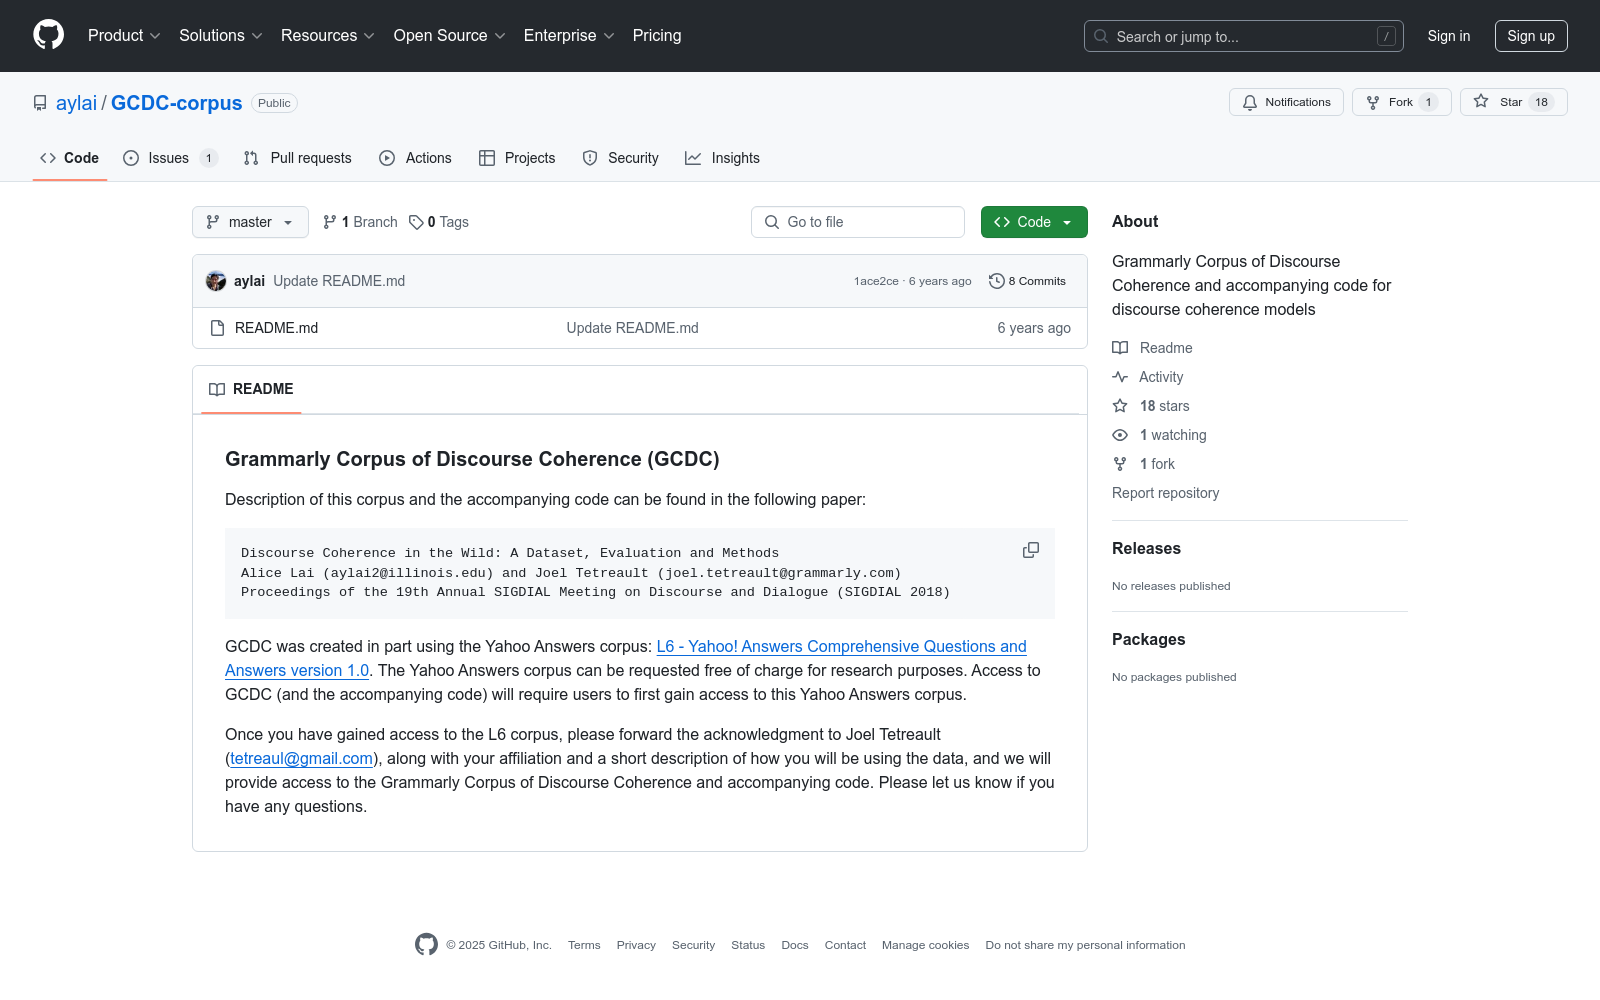
Grammarly Corpus of Discourse Coherence (GCDC)
数据集来源
- GCDC部分基于Yahoo Answers corpus构建。
获取条件
- 用户需先免费申请并获得Yahoo Answers corpus的访问权限。
- 获得Yahoo Answers corpus后,需向Joel Tetreault (tetreaul@gmail.com)发送确认邮件,附上机构信息及数据使用计划,以获取GCDC及其配套代码的访问权限。
相关文献
- 数据集描述及配套代码的详细信息可参考以下论文:
- 论文标题:Discourse Coherence in the Wild: A Dataset, Evaluation and Methods
- 作者:Alice Lai (aylai2@illinois.edu) 和 Joel Tetreault (joel.tetreault@grammarly.com)
- 发表会议:Proceedings of the 19th Annual SIGDIAL Meeting on Discourse and Dialogue (SIGDIAL 2018)
搜集汇总
数据集介绍
构建方式
Grammarly Corpus of Discourse Coherence (GCDC) 是基于Yahoo Answers Comprehensive Questions and Answers version 1.0语料库构建的。该语料库包含了丰富的问答数据,研究者通过筛选和整理这些数据,构建了一个专门用于研究语篇连贯性的数据集。构建过程中,研究者对原始数据进行了细致的标注和分类,以确保数据集能够准确反映语篇连贯性的多样性和复杂性。
特点
GCDC数据集的特点在于其专注于语篇连贯性的研究,提供了丰富的语篇样本,涵盖了多种语言风格和语境。数据集的样本经过精心挑选和标注,能够有效支持语篇连贯性分析、模型训练和评估。此外,该数据集还附带了相关的代码和工具,便于研究者进行深入分析和实验。
使用方法
使用GCDC数据集需要首先获取Yahoo Answers Comprehensive Questions and Answers version 1.0语料库的访问权限。获得权限后,用户需联系Joel Tetreault并提供相关信息和研究计划,以获取GCDC数据集的访问权限。数据集附带的代码和工具可以帮助研究者快速上手,进行语篇连贯性分析和模型训练。
背景与挑战
背景概述
Grammarly Corpus of Discourse Coherence (GCDC) 是由Alice Lai和Joel Tetreault于2018年创建的一个专注于语篇连贯性研究的数据集。该数据集基于Yahoo Answers Comprehensive Questions and Answers version 1.0语料库构建,旨在为自然语言处理领域提供关于语篇连贯性的高质量标注数据。GCDC的创建标志着语篇连贯性研究从理论探讨向实际应用的重要转变,为开发更先进的自然语言处理模型提供了坚实的基础。该数据集在SIGDIAL 2018会议上首次发布,迅速成为语篇连贯性研究领域的重要资源,推动了相关算法和模型的进一步发展。
当前挑战
GCDC数据集在构建和应用过程中面临多重挑战。首先,语篇连贯性本身是一个复杂且主观的语言现象,如何准确标注和量化连贯性成为数据集构建的核心难题。其次,尽管基于Yahoo Answers语料库,但原始数据的质量和多样性仍需进一步筛选和优化,以确保数据集的代表性和可靠性。此外,语篇连贯性研究的多维度特性要求数据集能够涵盖不同语境和语言风格,这对数据集的广度和深度提出了更高要求。最后,数据集的访问和使用受到Yahoo Answers语料库的限制,增加了研究者的获取难度,可能影响数据集的广泛应用和进一步研究。
常用场景
经典使用场景
Grammarly Corpus of Discourse Coherence (GCDC) 数据集主要用于研究文本连贯性,特别是在自然语言处理领域中的对话和篇章分析。该数据集通过整合Yahoo Answers的问答数据,提供了一个丰富的语料库,用于评估和改进文本连贯性模型。研究人员可以利用该数据集来训练和测试各种自然语言处理算法,特别是在自动文本生成和文本质量评估方面。
解决学术问题
GCDC数据集解决了自然语言处理领域中一个关键问题:如何量化并提升文本的连贯性。通过提供大量真实世界的对话数据,该数据集使得研究人员能够开发出更精确的连贯性评估模型,从而推动自动文本生成、机器翻译和文本摘要等技术的发展。这些技术的进步不仅提升了文本生成的质量,还增强了人机交互的自然性和流畅性。
衍生相关工作
基于GCDC数据集,许多经典的研究工作得以展开。例如,研究人员开发了多种连贯性评估模型,如基于深度学习的神经网络模型和基于规则的连贯性分析工具。这些模型不仅在学术界得到了广泛认可,还被应用于工业界的实际产品中,推动了自然语言处理技术的商业化进程。
以上内容由遇见数据集搜集并总结生成


