
tglcourse/5s_birdcall_samples_top20
收藏官方服务:
资源简介:
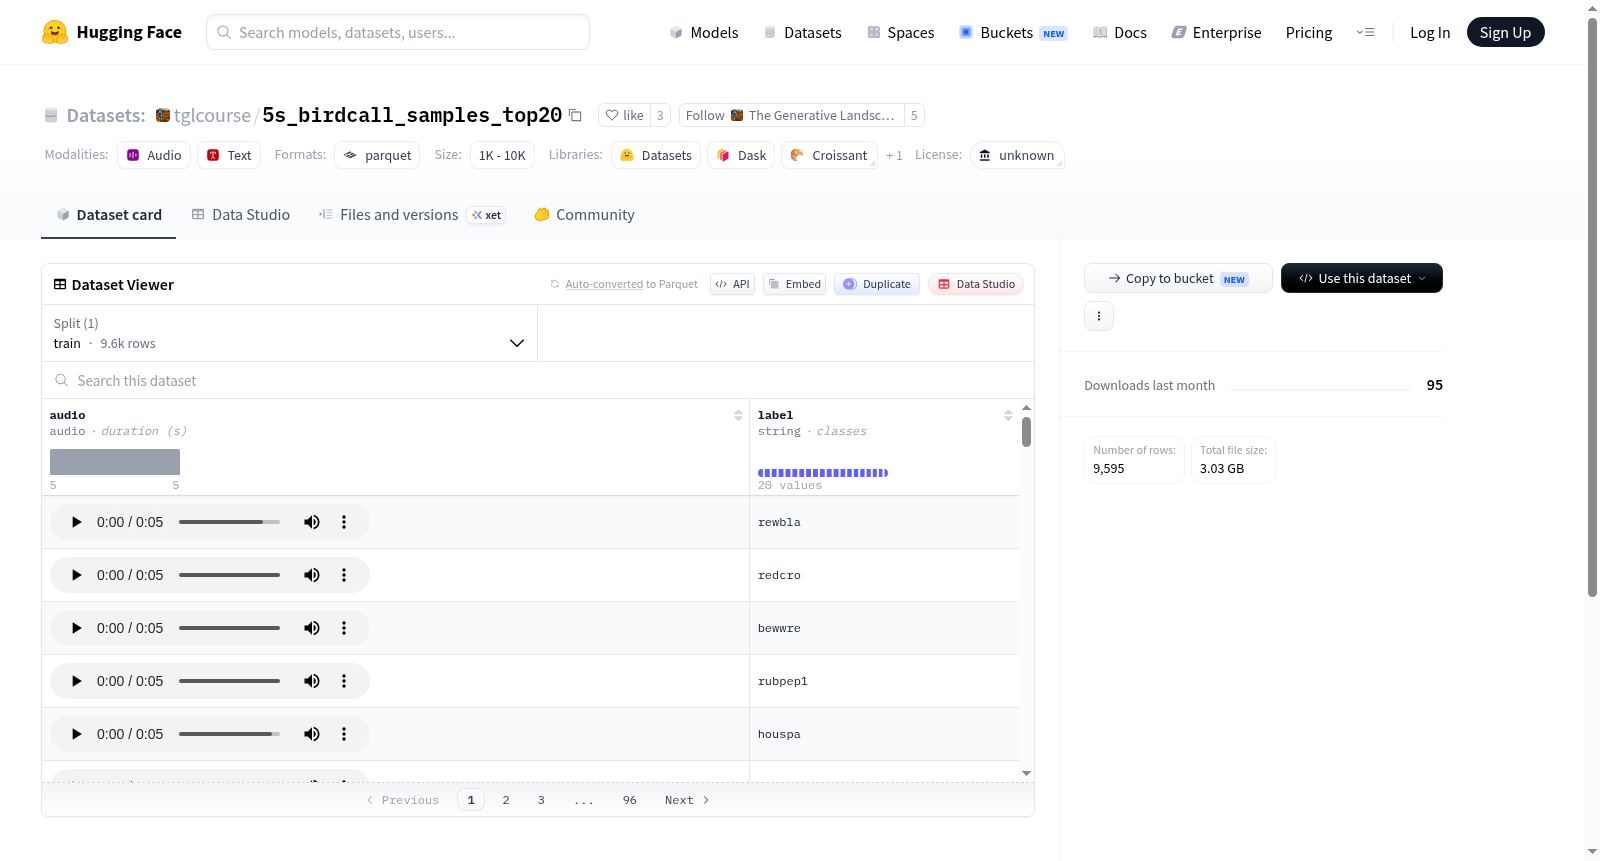
该数据集包含用于音频生成测试的5秒鸟鸣声片段。共有20种鸟类,每种鸟类大约有500个录音,这些录音来自xeno-canto。音频片段是从较长的样本中通过特定方法识别出的鸟鸣声,音频采样率为32kHz(单声道)。
This dataset contains 5-second bird song clips designed for audio generation testing. It includes recordings of 20 bird species, with roughly 500 recordings per species, all sourced from xeno-canto. The audio clips are bird vocalizations extracted from longer samples using specific methods, with a sampling rate of 32 kHz (mono).
提供机构:
tglcourse原始信息汇总
数据集概述
数据集名称
- 名称: 5s Birdcall Samples
数据集内容
- 描述: 包含20种鸟类的叫声,每种鸟类约有500个录音片段,每个片段时长为5秒。
- 来源: 录音来自xeno-canto。
- 处理方法: 通过识别录音中的叫声片段,从长录音中提取出5秒的片段。
- 音频规格: 音频采样率为32kHz,单声道。
数据集用途
- 用途: 用于音频生成测试。
许可证
- 许可证: 未知
搜集汇总
数据集介绍
构建方式
在鸟类声学监测与生物多样性研究的广阔领域中,高质量、标准化的音频数据集是推动音频生成模型发展的基石。本数据集聚焦于20种常见鸟类,从全球知名的鸟类鸣声数据库xeno-canto中精选原始录音。构建过程中,研究者首先获取了每种鸟类的多段长时录音,随后采用峰值检测算法(具体实现参考Kaggle上的相关代码)精准识别鸣叫片段,最终截取为5秒长度的音频样本。每种鸟类约包含500条独立样本,确保了数据量的均衡性与代表性。所有音频均统一处理为32kHz采样率的单声道格式,以适配后续的音频生成与模型训练需求。
特点
该数据集的核心特点在于其专为音频生成测试而设计,具有明确的实用导向性。首先,5秒的固定时长既保留了鸟类鸣叫的完整节律特征,又避免了过长音频带来的计算冗余,适合作为生成模型的输入与评估基准。其次,20个物种的覆盖范围兼顾了多样性,每种约500条样本的规模在类间平衡与数据充分性之间取得了良好折中。此外,音频来源xeno-canto保证了数据的生态真实性,而统一的32kHz单声道格式则消除了采样率与声道差异带来的预处理负担,便于直接用于模型训练与对比实验。
使用方法
本数据集的使用方法灵活且直观,主要面向音频生成模型的训练与评估场景。用户可直接加载32kHz单声道音频文件,无需额外重采样或声道转换即可输入至WaveNet、DiffWave或GAN-based生成器等主流架构。对于分类或检索任务,5秒片段可作为标准输入长度,配合数据增强技术(如时域拉伸、噪声注入)进一步提升模型鲁棒性。建议在训练过程中将数据集按8:2比例划分为训练集与验证集,并利用峰值检测标注信息辅助监督学习。此外,该数据集也适合作为基线测试集,用于对比不同生成模型在鸟类鸣声合成任务上的表现。
背景与挑战
背景概述
鸟类鸣声识别与生成是生物声学与人工智能交叉领域的重要研究方向,其核心在于通过声学特征解析物种行为与生态分布。tglcourse/5s_birdcall_samples_top20数据集由研究人员于近年构建,依托xeno-canto全球共享的鸟类录音库,精选20个代表性物种,每个物种约500段5秒长的鸣叫片段。该数据集旨在为音频生成模型提供高质量的训练素材,推动鸟类鸣声的合成与多样性研究。其影响力体现在为声学生态学与深度学习模型搭建了桥梁,助力自动识别与生成技术的落地应用。
当前挑战
该数据集面临多重挑战。首先,在领域问题层面,鸟类鸣声的类间相似性与环境噪声干扰导致模型泛化困难,20个物种的分类与生成任务需应对声学特征的细微差异。其次,构建过程中,原始录音来自不同地域与季节的野外采集,背景噪声、录音设备差异及鸣声时段非标准化增加了预处理难度。此外,基于峰值检测的片段提取方法可能遗漏弱信号或引入非目标声,影响数据纯净度与代表性,限制了生成模型的鲁棒性。
常用场景
经典使用场景
该数据集收录了20种鸣禽的5秒短时鸣叫片段,每类约500条样本,音频统一采样至32kHz单声道格式。其经典应用场景聚焦于鸟类声音检测与生成模型的训练与评估,尤其适用于基于深度学习的音频片段分类、声学事件检测以及条件音频生成任务。研究者可借助该数据集探索细粒度物种识别算法,或作为预训练音频表示学习的基准数据。
衍生相关工作
该数据集衍生的工作主要围绕音频峰值检测与声学事件分割方法,其构建流程借鉴了基于信号处理的峰值识别技术。相关研究包括将卷积神经网络与注意力机制结合用于鸣叫分类,以及利用扩散模型生成高保真鸟类音频。这些工作进一步推动了跨物种声音迁移学习与无监督声学表征学习的进展,为低资源音频数据集构建提供了可复现的范例。
数据集最近研究
最新研究方向
在当前生物声学与人工智能交叉领域,基于短时鸟类鸣声片段的数据集正成为推动音频生成与生态监测技术发展的关键资源。tglcourse/5s_birdcall_samples_top20 数据集收录了来自xeno-canto平台的20种鸟类、每种约500段5秒鸣声样本,以32kHz单声道格式呈现,为深度学习模型提供了高质量、标准化的训练素材。前沿研究方向聚焦于利用此类数据集进行鸟类鸣声的合成与增强,例如通过扩散模型或变分自编码器生成逼真的鸟类叫声,以辅助生态学中的物种识别与种群动态研究。该数据集与全球生物多样性监测热点事件紧密相连,如公民科学项目中的自动声学监测系统,其标准化设计有助于降低模型训练中的数据偏差,提升跨区域物种识别的泛化能力。这一资源的发布不仅推动了音频生成技术的边界,也为保护生物学中的非侵入性监测提供了可复用的数据基础,具有显著的生态与科技双重意义。
以上内容由遇见数据集搜集并总结生成


