
遇见数据集

TheFinAI/dolma3_300B_sample_shuffled

收藏
Hugging Face2026-05-28 更新2026-06-14 收录
官方服务:

资源简介:

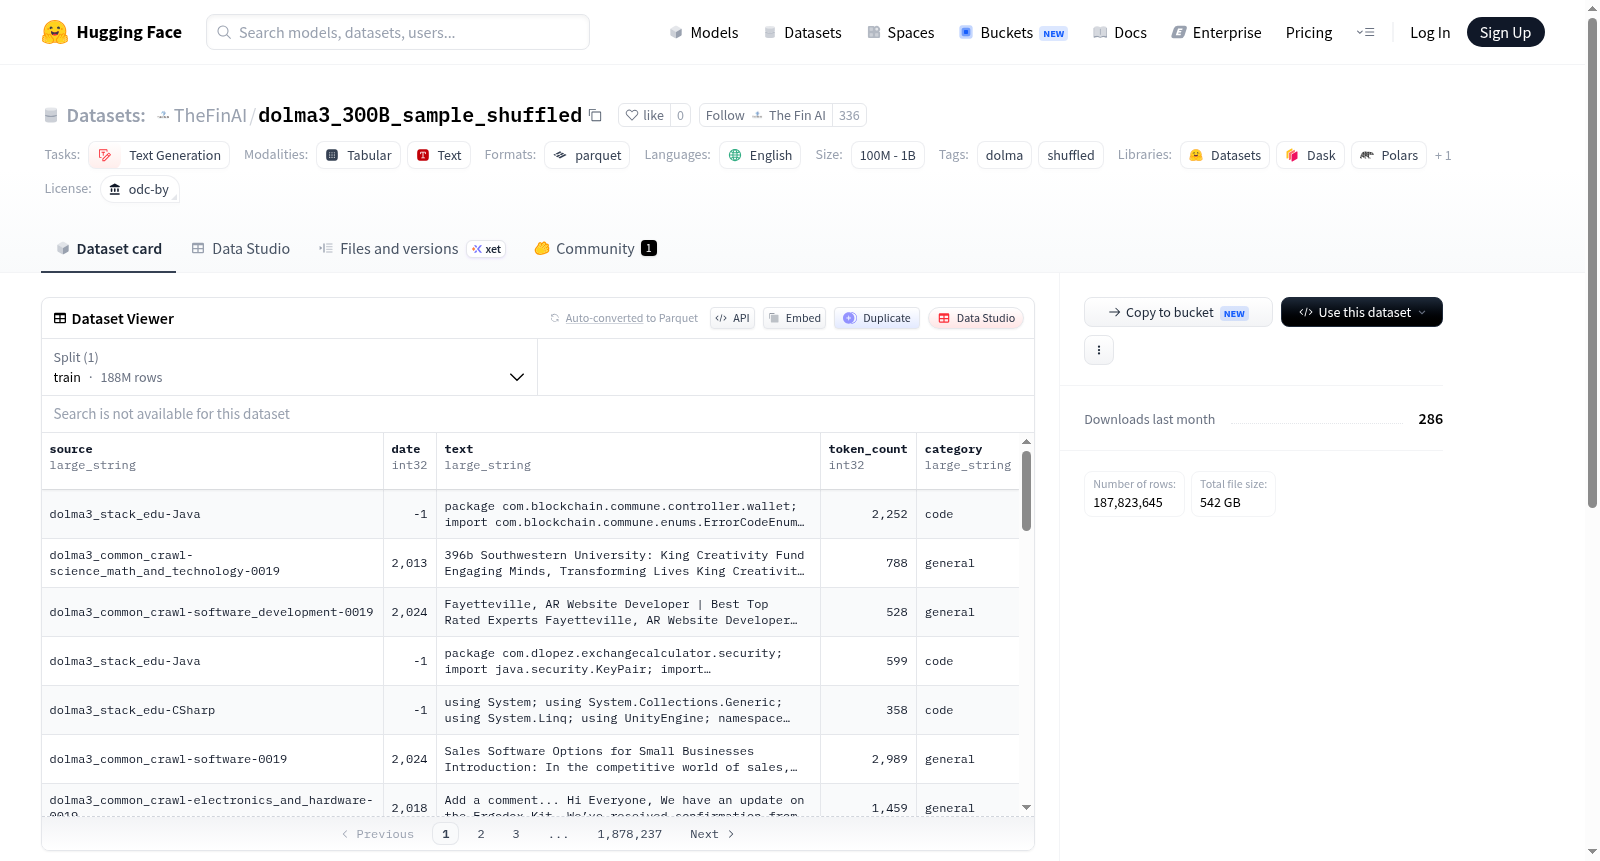
dolma3_300B_sample_shuffled数据集是对TheFinAI/dolma3_300B_sample数据集的全局行级洗牌版本。源数据来自allenai/dolma3_mix-6T-1025-7B,通过伯努利采样(概率约0.0506)生成约3000亿cl100k令牌,保留了原始Dolma3的混合比例。由于源数据在磁盘上按子源聚类存储,可能导致训练时小缓冲区出现非均匀源混合问题。本数据集通过真正的全局洗牌解决了这一问题:每行数据均匀随机分配到200个输出桶中,每个桶在内存中进行洗牌,同时保持源混合比例不变。数据模式与源相同,包括来源、日期、文本、令牌计数和类别字段。洗牌使用种子42以确保可重复性。

The dolma3_300B_sample_shuffled dataset is a globally row-shuffled variant of the TheFinAI/dolma3_300B_sample dataset. Its source data originates from allenai/dolma3_mix-6T-1025-7B, and approximately 300 billion cl100k tokens were generated via Bernoulli sampling with an approximate probability of 0.0506, while preserving the original mixture ratios of Dolma3. Since the source data is stored on disk clustered by sub-sources, it may introduce non-uniform source mixing issues in small buffers during training. This dataset addresses this problem via true global shuffling: each row of data is uniformly randomly assigned to one of 200 output buckets, each bucket is shuffled in-memory, and the source mixture ratios are maintained unchanged. The data schema is identical to that of the source dataset, including fields such as source, date, text, token count, and category. The shuffling process uses a fixed seed of 42 to ensure reproducibility.
提供机构:
TheFinAI
搜集汇总
数据集介绍
TheFinAI/dolma3_300B_sample_shuffled 数据集图片
构建方式
在自然语言处理领域,大规模语料库的构建往往面临数据分布不均的挑战。dolma3_300B_sample_shuffled数据集源自对allenai/dolma3_mix-6T-1025-7B的逐行伯努利采样(采样率p≈0.0506),生成约3000亿cl100k个token,并保持了原始Dolma3的混合比例。原始数据以parquet格式存储,每个约10万行的文件内记录按输入分片连续排列,导致小规模shuffle缓冲区内每个小批次的来源分布不均。为此,本数据集实现了真正的全局洗牌:将所有行均匀随机分配到200个输出桶中,再对每个桶进行内存级重排,从而彻底打破原始分布的局部聚集性。随机种子设为42,确保可复现。
特点
本数据集的核心特点在于其全局行级洗牌策略,与原始数据集相比,它从根本上解决了语料按子来源物理聚集的问题。每个训练批次中的样本来源更加均匀混合,避免了小缓冲区训练时因局部数据簇集导致的分布偏移,使模型能够更稳定地学习跨来源的语言模式。此外,数据集保留了源数据的完整模式,包括来源、日期、文本、token计数和类别字段,且混合比例与原始Dolma3完全一致。这使其成为大规模语言模型预训练中验证洗牌策略对训练稳定性和模型性能影响的理想数据源。
使用方法
使用时,可直接通过HuggingFace Datasets库加载本数据集,其Schema与源数据集一致,包含source、date、text、token_count和category字段。加载后即可作为标准文本生成任务的数据源,适用于大规模语言模型的预训练或持续训练。由于已进行全局洗牌,可直接按顺序或使用默认的shuffle缓冲区进行迭代,无需额外处理数据分布问题。建议在训练前根据token_count字段进行适当的序列长度过滤或分组,以适应不同的模型输入限制。数据集的随机种子固定,保证了划分和采样的可复现性。
背景与挑战
背景概述
在自然语言处理领域,大规模文本语料库的构建与优化是推动语言模型发展的基石。dolma3_300B_sample_shuffled数据集由TheFinAI团队于近期创建,来源于allenai/dolma3_mix-6T-1025-7B的伯努利采样(p≈0.0506),旨在生成约3000亿cl100k词元的精简样本,同时保留原始Dolma3的混合比例。该数据集的核心研究问题在于解决大规模预训练数据中源分布不均的难题,通过全局行级随机洗牌确保每个训练小批次的源混合均匀性,从而提升模型训练的一致性与泛化能力。作为Dolma系列的重要扩展,该数据集对语言模型预训练中数据质量与分布优化具有关键参考价值。
当前挑战
该数据集所解决的领域挑战在于自然语言预训练中源数据非均匀分布问题:原始语料按子来源在磁盘上聚类存储,导致小尺寸训练混洗缓冲区内每个小批次的源混合比例与实际分布偏差显著,进而影响模型鲁棒性。为此,构建过程中面临技术挑战:需在保持原始混合比例不变的前提下,对约300B词元的样本进行全局随机重排,通过将每行均匀分配至200个输出桶并逐桶内存洗牌,最终以固定种子42实现可复现的均匀分布。此外,大规模数据的高效全局洗牌对计算资源与存储管理提出了苛刻要求。
常用场景
经典使用场景
在自然语言处理与大规模语言模型预训练的领域中,dolma3_300B_sample_shuffled 数据集作为经过全局行级随机打乱的文本生成语料库,被广泛用于训练自回归语言模型。其核心价值在于通过均匀随机打乱策略,彻底消除了原始数据分片存储带来的子源分布偏倚,使得训练过程中每个小批次都能获得均匀的混合比率,从而为模型提供更为稳定和均衡的跨域语言信号。该数据集特别适用于需要覆盖多样化文本来源(如网页、书籍、代码、学术论文等)的预训练任务,能够有效提升模型对通用语言模式的建模能力。
解决学术问题
该数据集解决了大规模预训练语料中因数据分簇存储导致的训练分布非均匀问题,这是学术界长期关注的采样偏差难题。通过全局随机打乱,避免了传统训练中因 shuffle buffer 较小而出现的局部子源密度不均现象,显著提高了梯度更新的统计稳定性。这一设计使得研究人员能够更精确地控制域内与跨域的学习动态,推动了关于数据组成、混合策略与模型泛化性能之间关系的研究。其意义在于为构建高质量、可复现的预训练基准提供了数据层面的关键支持,促进了公平的比较与评估。
衍生相关工作
该数据集衍生了一系列重要的学术与工程工作,涵盖数据混合优化、训练动态分析及模型鲁棒性提升等领域。基于其均匀分布特性,研究人员提出了自适应采样策略与域加权学习方法,以进一步探索子源比例对下游任务的影响。同时,该数据集被用作 Dolma 系列消融实验的核心基准,支撑了关于数据规模、随机性与模型质量之间关联的实证研究。在工程实践层面,其全局打乱的设计思路启发了多个大规模语料库的预处理流程优化,如 Pile、RedPajama 等同类项目的改进版本中融入了类似的混洗策略,推动了开放科学数据基础设施的标准化进程。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

