OpenVoiceOS/intents-for-eval
收藏资源简介:
OVOS意图基准数据集是一个用于语音助手意图分类和槽位填充的多语言基准测试数据集,旨在评估不同意图引擎(如基于关键词、模板或嵌入的引擎)的泛化能力。数据集覆盖12种语言(包括英语、葡萄牙语、西班牙语、法语、德语、意大利语、荷兰语、加泰罗尼亚语、加利西亚语、丹麦语和巴斯克语),包含50个意图和10个领域(如媒体、定时器警报、智能家居、通信等)。数据集分为训练集和测试集:训练集包括模板文件(每语言20个模板×50个意图,共12,000行)和关键词文件(每语言50个规则,共600行);测试集包含自然语言句子(每语言1,750行,共21,000行),分为模板、释义、近OOD、远OOD、ASR噪声和打字错误等桶。数据集通过人工指导生成,使用Claude Opus模型,并遵循严格的验证流程。数据集用于意图分类和槽位提取的评估,支持多种指标(如准确率、F1分数、假阳性率等),并遵循Apache-2.0许可证。
The OVOS Intent Benchmark Dataset is a multilingual benchmark dataset tailored for intent classification and slot filling tasks in voice assistant systems, aiming to evaluate the generalization performance of diverse intent engines (e.g., keyword-based, template-based, or embedding-based engines). It covers 12 languages including English, Portuguese, Spanish, French, German, Italian, Dutch, Catalan, Galician, Danish, and Basque, and contains 50 intents across 10 domains such as media, timer/alarm, smart home, communication, and more. The dataset is split into training and test sets: the training set consists of template files (20 templates × 50 intents per language, totaling 12,000 lines) and keyword files (50 rules per language, totaling 600 lines); the test set contains natural language sentences (1,750 lines per language, totaling 21,000 lines) divided into buckets such as templates, paraphrases, near out-of-distribution (OOD), far OOD, ASR noise, and typos. The dataset was generated under human guidance using the Claude Opus model and follows a strict validation pipeline. It is used for evaluating intent classification and slot extraction, supports multiple metrics such as accuracy, F1-score, false positive rate, and more, and is released under the Apache-2.0 license.
数据集概述
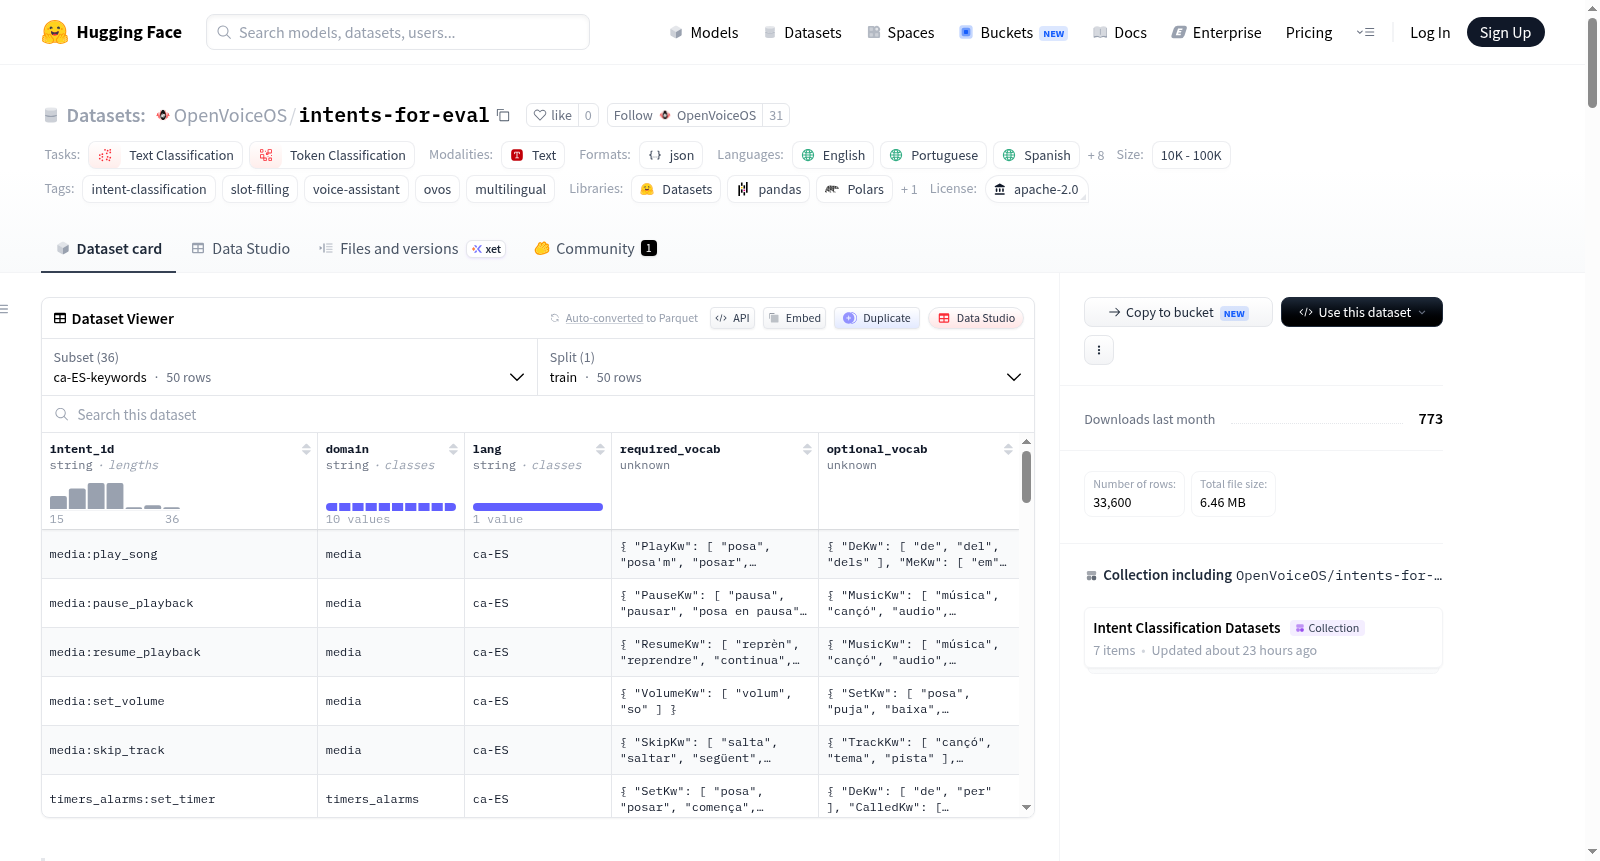
该数据集是 OVOS Intent Benchmark,专为语音助手意图分类和槽位提取任务设计的基准数据集。
核心信息
- 目的:用于 意图解析器(intent-parser)基准测试,衡量 OVOS 意图插件(如基于关键词、模板或嵌入的引擎)的泛化能力,而非记忆能力。作为 OVOS 意图分类数据集的一部分,用于 OVOS 插件竞技场(OVOS Plugin Arena)基准测试。
- 任务:文本分类(Text Classification)、词元分类(Token Classification)。
- 数据模态:文本(Text)。
- 数据格式:json。
- 数据集大小:10K - 100K 条。
- 许可证:Apache-2.0。
具体数据统计
| 项目 | 内容 |
|---|---|
| 意图数量 | 50 个(覆盖 10 个领域) |
| 语言数量 | 12 种 |
| 训练集(模板) | 每语言 1,000 行(50 个意图 × 20 个模板),共 12,000 行 |
| 训练集(关键词) | 每语言 50 行 |
| 测试集 | 每语言约 1,750 行 |
| 子集 (Subsets) | 共 36 个子集,按语言-类型(如 ca-ES-keywords, en-US-templates, de-DE-test)划分 |
| 分割 (Splits) | 包含 train 分割 |
语言
涵盖 12 种语言:英语(en-US)、葡萄牙语(pt-PT, pt-BR)、西班牙语(es-ES)、法语(fr-FR)、德语(de-DE)、意大利语(it-IT)、荷兰语(nl-NL)、加泰罗尼亚语(ca-ES)、加利西亚语(gl-ES)、丹麦语(da-DK)、巴斯克语(eu-ES)。
领域与意图
数据集覆盖 10 个领域,包含 50 个意图,例如:
- 媒体 (media):播放歌曲、暂停、恢复、设置音量、跳过曲目。
- 计时器与闹钟 (timers_alarms):设置/取消计时器、设置/列出/小睡闹钟。
- 智能家居 (smarthome):开关灯、设置亮度/恒温器、锁门。
- 通讯 (communication):呼叫联系人、发送/阅读消息、挂断、视频通话。
- 导航 (navigation):导航至某地、查找附近、查询ETA/交通状态、取消路线。
- 搜索与问答 (search_qa):定义单词、事实查询、人物查询、翻译短语、拼写单词。
- 天气 (weather):今日天气、天气预报、特定地点天气、湿度、风速。
- 日历 (calendar):创建/列出/取消/重新安排事件、下一个事件。
- 系统控制 (system_control):关机、重启、设置屏幕亮度、静音、更改语言。
- 新闻 (news):阅读头条、阅读特定主题新闻、下一条/上一条新闻、选择新闻源。
数据生成与文件结构
- 三文件布局:每种语言包含三种类型的文件:
train_templates.jsonl:基于模板的短语。train_keywords.jsonl:基于关键词的短语(Adapt 风格规则)。test.jsonl:测试集。
- 数据生成:通过编写规则(Authoring rules)、测试桶(Test-bucket authoring)和关键词规则(Keyword-rule authoring)生成。
其他信息
- 标签:包含
intent-classification,slot-filling,voice-assistant,ovos,multilingual。 - 库 (Libraries):支持
Datasets,pandas,Polars等。 - 资金:由 TigreGotico 为 OpenVoiceOS 开发,作为“OpenVoiceOS — 从测试版到突破”(From Beta to Breakthrough)项目的一部分,由欧盟委员会下一代互联网计划下的 NGI0 Commons Fund 资助(授权协议号 101135429)。