mmJEE-Eval
收藏资源简介:
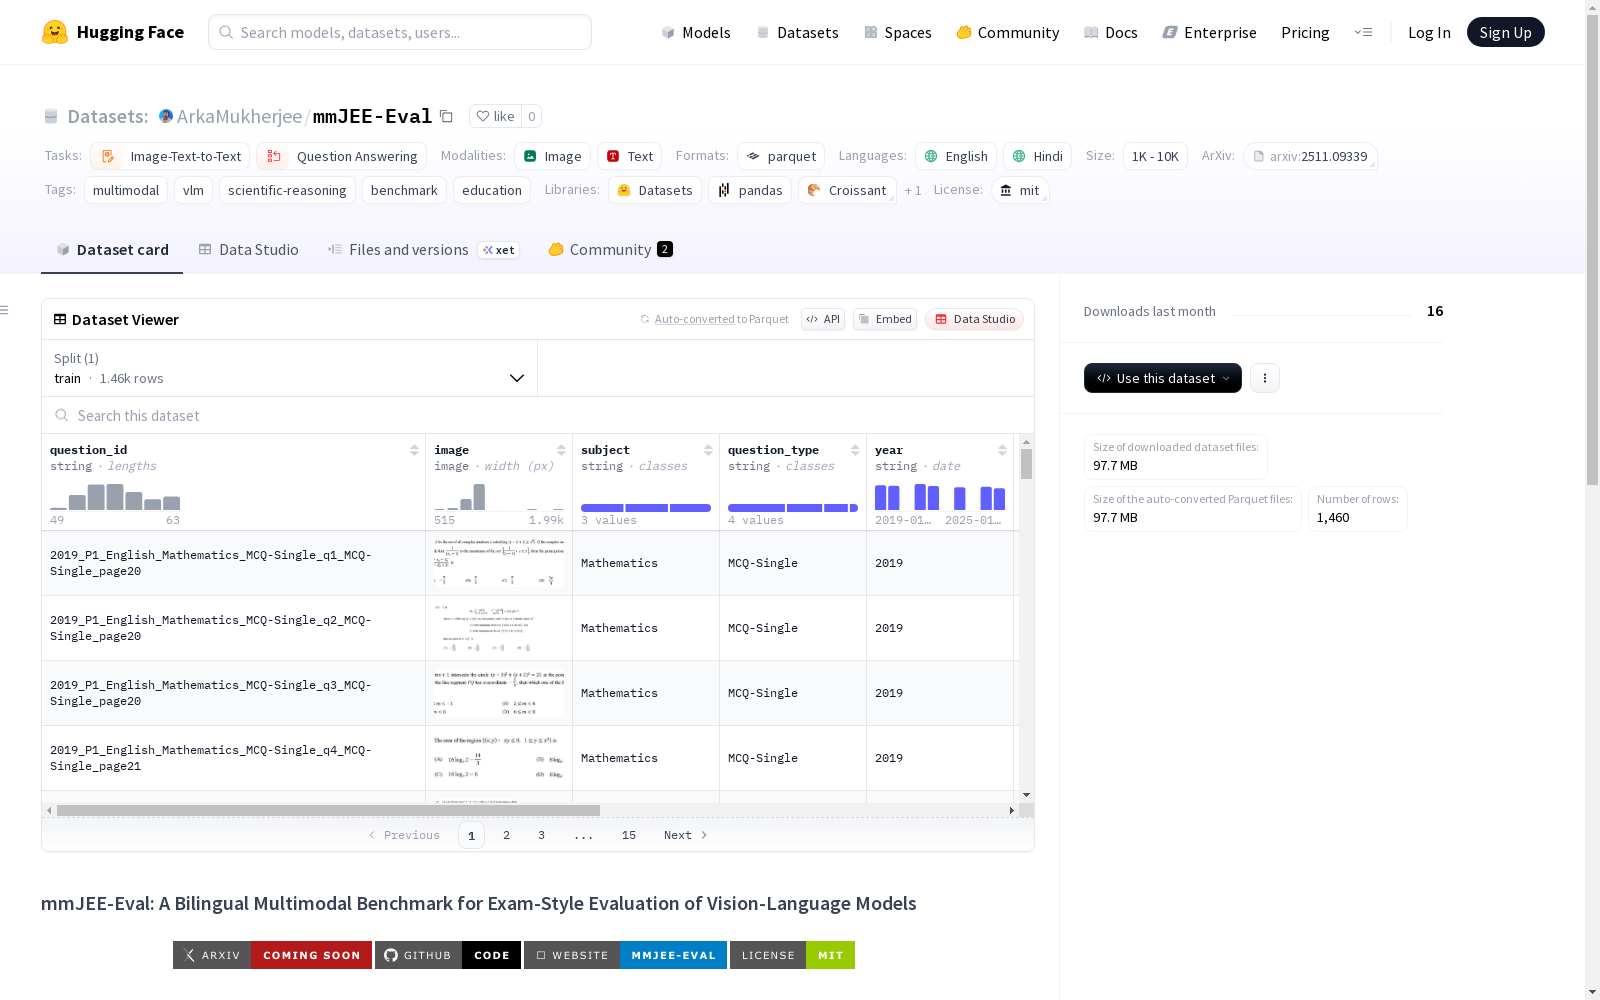
mmJEE-Eval是一个包含来自印度JEE Advanced竞争考试的1,460个挑战性问题的大型双语多模态评估数据集,涵盖2019至2025年的试题。该数据集用于评估视觉语言模型在科学推理方面的能力,并为模型提供了比文本单一的JEEBench数据集更具挑战性的测试环境。
mmJEE-Eval is a large bilingual multimodal evaluation dataset containing 1,460 challenging problems from the Indian JEE Advanced competitive examination, covering exam questions from 2019 to 2025. This dataset is designed to evaluate the scientific reasoning capabilities of vision-language models, and provides a more challenging test environment for models compared to the text-only JEEBench dataset.
mmJEE-Eval数据集概述
基本信息
- 数据集名称: mmJEE-Eval
- 许可证: MIT
- 语言: 英语、印地语
- 任务类别: 图像文本到文本、问答
- 标签: 多模态、视觉语言模型、科学推理、基准测试、教育
数据集规模
- 下载大小: 97,675,003字节
- 数据集大小: 101,253,285.86字节
- 训练集样本数: 1,460个
- 训练集大小: 101,253,285.86字节
数据特征
- 问题ID: 字符串类型
- 图像: 图像类型
- 科目: 字符串类型
- 问题类型: 字符串类型
- 年份: 字符串类型
- 试卷: 字符串类型
- 语言: 字符串类型
- 答案: 字符串类型
- 答案来源: 字符串类型
- 需要图像: 布尔类型
数据集描述
mmJEE-Eval是一个多模态双语数据集,用于评估视觉语言模型。该数据集包含来自印度JEE Advanced竞争性考试七个年份(2019-2025年)的1,460个具有挑战性的问题。该基准测试比纯文本的JEEBench更具挑战性,能有效区分不同模型的能力。
相关资源
- 论文: https://huggingface.co/papers/2511.09339
- 代码: https://github.com/ArkaMukherjee0/mmJEE-Eval
- 项目页面: https://mmjee-eval.github.io
使用方式
可通过Hugging Face的datasets库加载数据集: python from datasets import load_dataset dataset = load_dataset("ArkaMukherjee/mmJEE-Eval")