
遇见数据集

boffire/timucuha-kabyle-tales

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

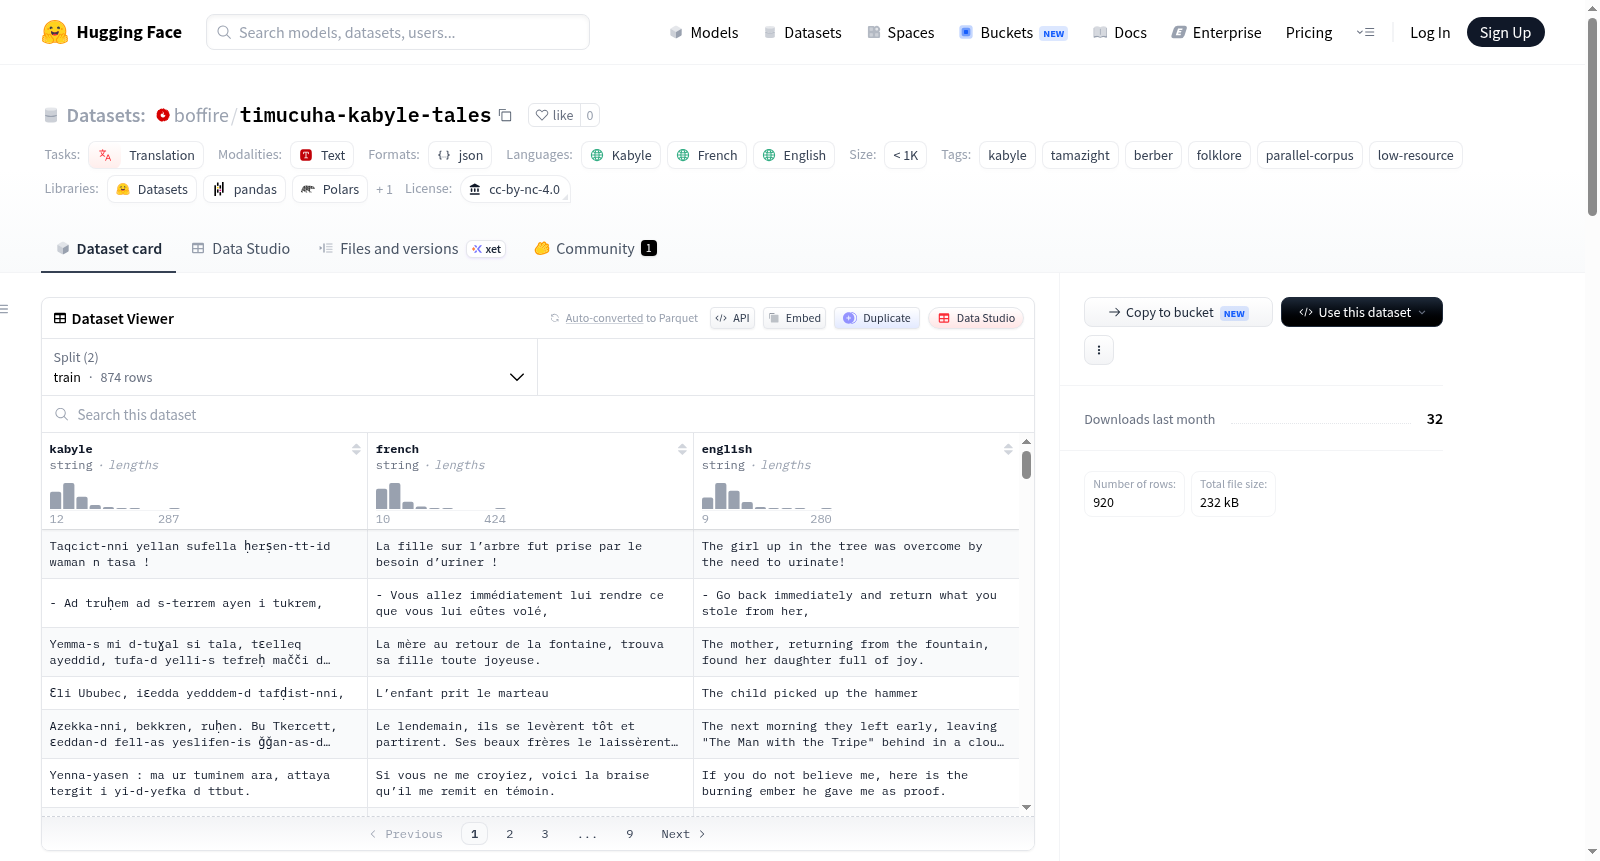
Timucuha三语语料库是一个平行语料库,包含卡拜尔语(塔马塞特语)民间故事及其法语和英语翻译。该数据集源自Numidya文化协会的Timucuha项目,旨在保护和推广卡拜尔口头传统。语料库包含920个示例,其中训练集874个,验证集46个。数据字段包括:kabyle(原始卡拜尔文本,由人工收集)、french(法语翻译,由人工提供)和english(英语翻译,使用Gemini 3.5 Flash生成,非人工翻译)。语料库支持低资源语言处理,适用于翻译任务,专注于卡拜尔语、塔马塞特语和柏柏尔语民俗内容。

The Timucuha Trilingual Corpus is a parallel corpus containing Kabyle (Tamashek) folk tales and their French and English translations. Derived from the Timucuha Project of the Numidya Cultural Association, this corpus aims to preserve and promote Kabyle oral traditions. It comprises 920 total instances, with 874 allocated to the training set and 46 to the validation set. The data fields include: kabyle (raw Kabyle text, manually collected), french (French translations, manually provided), and english (English translations generated by Gemini 3.5 Flash, not manually translated). This corpus supports low-resource language processing, is suitable for translation tasks, and focuses on folk content related to Kabyle, Tamashek and Berber languages.
提供机构:
boffire
搜集汇总
数据集介绍
boffire/timucuha-kabyle-tales 数据集图片
构建方式
该数据集名为Timucuha Kabyle Tales,源自Association Culturelle Numidya发起的Timucuha项目,旨在保存和推广卡比利(Kabyle)口头传统。数据集收集了卡比利民间故事的平行文本,包含原始卡比利语、法语人工翻译以及英语机器翻译(由Gemini 3.5 Flash生成)。数据以句子或段落级别对齐,共计920个示例,其中874个用于训练,46个用于验证。所有文本以JSONL格式存储,每一行均为包含三个字段(kabyle、french、english)的JSON对象。
使用方法
用户可通过HuggingFace的datasets库直接加载该数据集,使用load_dataset('bof/timucuha-trilingual-corpus')即可获取训练和验证划分;亦可从本地JSONL文件加载,指定data_files参数对应train.jsonl和validation.jsonl。数据集支持翻译任务、跨语言检索及低资源语言模型研究,返回的每个样本包含卡比利语、法语和英语三语对齐文本,便于直接用于序列到序列模型训练或评估。
背景与挑战
背景概述
Timucuha Trilingual Corpus是由Association Culturelle Numidya于2026年创建并发布的多语平行语料库,聚焦于卡拜尔语(Kabyle,又称塔马齐格特语)民间故事的保存与翻译。该数据集包含920条句子级对齐的三语平行文本,涵盖卡拜尔语、法语及英语,其中法语翻译由人工完成,英语译文则借助Gemini 3.5 Flash模型自动生成。作为低资源语言领域的珍贵资源,该语料库源自Numidya协会的Timucuha项目,旨在数字化和推广北非柏柏尔人的口头文学传统,为跨语言自然语言处理研究提供了稀缺的标准化数据基础设施,尤其在濒危语言保护与机器翻译基准构建方面具有开创性意义。
当前挑战
该数据集所面对的领域挑战核心在于低资源语言卡拜尔语的翻译与保存:柏柏尔语支系缺乏大规模结构化语料,现有语音转写规则不统一,词汇形态丰富但标注资源极度匮乏,制约了神经机器翻译模型的有效训练与泛化。在构建过程中,挑战体现在民间故事文本的多义性与文化特异性:口头文学中特有的隐喻、俚语及古语表达难以准确映射至法语及英语,且英语译文依赖非人工的自动生成方式,其语义保真度与流畅性缺乏严格的人工校验,可能导致跨语言对齐质量不均衡。此外,920条样本的规模对鲁棒模型训练构成数据稀疏性瓶颈,亟需与外部低资源语料库进行互补融合。
常用场景
经典使用场景
Timucuha Kabyle Tales数据集作为一项低资源语言的对齐平行语料资源,其最经典的应用场景在于神经机器翻译模型的训练与评估。研究者通过将卡拜尔语(Kabyle)与法语、英语的句子级对齐文本作为输入-输出对,能够有效地构建面向柏柏尔语系的翻译基准。该语料库虽规模有限,但因其内容源自民间故事,具备丰富的口语化表达与地域文化特色,尤其适用于验证跨语言迁移学习、数据增强及回译策略在低资源场景下的有效性。
数据集最近研究
最新研究方向
该数据集聚焦于柏柏尔语系中卡拜尔语这一低资源语言的机器翻译与数字人文保护研究。其前沿方向在于利用民间传说平行语料,结合大语言模型(如Gemini 3.5 Flash)生成英语译文以扩充三语对齐数据,为濒危语言的自然语言处理提供新范式。此工作呼应了全球对语言多样性的关注,尤其在2026年国际土著语言十年背景下,通过数字化手段挽救非物质文化遗产,对推动低资源神经机器翻译、跨语言民俗学分析及文化遗产计算具有重要示范意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

