遇见数据集

ru-llm-judge-dataset

收藏
Hugging Face2026-08-06 更新2026-08-07 收录
官方服务:

资源简介:

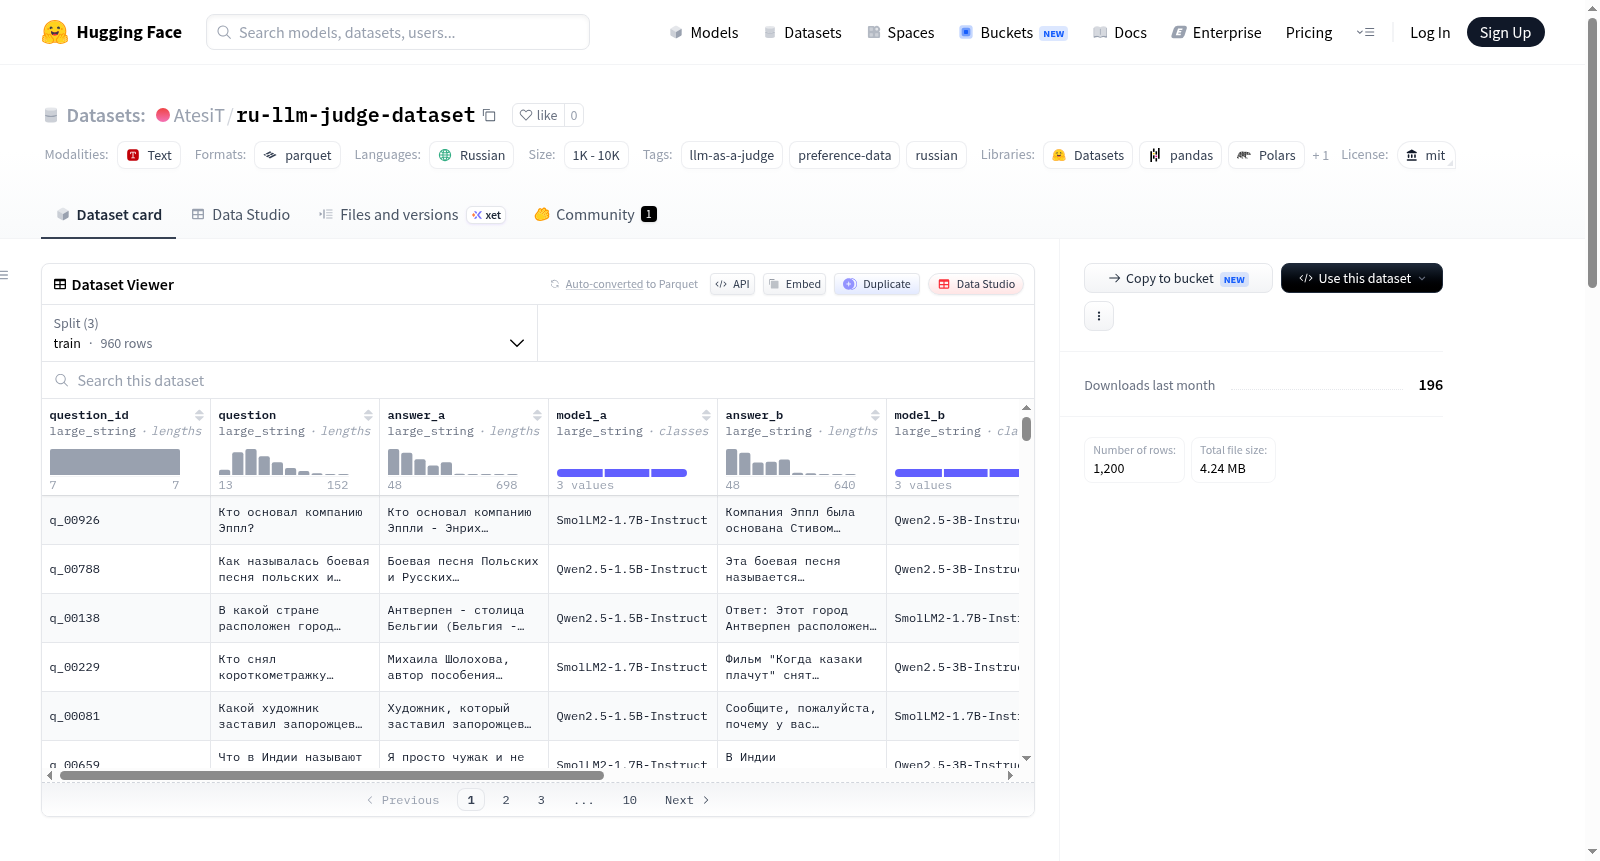
RU-LLM-Judge-Dataset 是一个俄语偏好数据集,用于训练和评估语言模型作为裁判的能力。数据集通过增量收集方式构建,目前包含 1,200 条判断记录(目标 5,000 条)。每条记录包含一个问题(源自 ai-forever/rubq-retrieval 数据集),以及由三个不同生成模型(Qwen2.5-1.5B-Instruct、Qwen2.5-3B-Instruct、SmolLM2-1.7B-Instruct)生成的两个答案(A 和 B),并由裁判模型 Qwen/Qwen2.5-3B-Instruct 评判哪个答案更优,同时给出偏好原因。数据格式为 CSV 风格字段:question_id, question, answer_a, model_a, answer_b, model_b, preferred(A 或 B), preferred_model, preference_reason。适用于 LLM 偏好对齐、裁判模型训练、俄语问答评估等任务。

RU-LLM-Judge-Dataset is a Russian preference dataset for training and evaluating the ability of language models as judges. The dataset is constructed incrementally and currently contains 1,200 judgment records (target 5,000). Each record includes a question (from ai-forever/rubq-retrieval dataset) and two answers (A and B) generated by three different generative models (Qwen2.5-1.5B-Instruct, Qwen2.5-3B-Instruct, SmolLM2-1.7B-Instruct), judged by the judge model Qwen/Qwen2.5-3B-Instruct to determine which answer is better along with a preference reason. The data format is CSV-style fields: question_id, question, answer_a, model_a, answer_b, model_b, preferred (A or B), preferred_model, preference_reason. It is suitable for tasks such as LLM preference alignment, judge model training, and Russian QA evaluation.

创建时间:
2026-08-05
原始信息汇总

RU-LLM-Judge-Dataset 数据集概述

基本信息

  • 语言:俄语(Russian)
  • 许可证:MIT
  • 标签:llm-as-a-judge、偏好数据、俄语

数据集规模与进度

  • 当前规模:1,200 条判断结果(截至最近一次运行)
  • 目标规模:5,000 条判断结果,当前完成度为 24%

数据收集历史

会话 日期 新增数量 累计总量
1 2026-08-05 08:42 617 617
2 2026-08-06 14:40 583 1,200

数据来源

生成与评判模型

  • 答案生成模型:Qwen2.5-1.5B-Instruct、Qwen2.5-3B-Instruct、SmolLM2-1.7B-Instruct
  • 评判模型:Qwen/Qwen2.5-3B-Instruct

数据格式

包含字段:question_id, question, model_a/answer_a, model_b/answer_b, preferred (A/B), preferred_model, preference_reason

示例数据

示例包含问题、两个模型的回答、偏好选择(A/B)、偏好模型及偏好理由,例如:

  • 问题:谁创立了苹果公司?
  • 模型A(SmolLM2-1.7B-Instruct)的回答包含事实错误;
  • 模型B(Qwen2.5-3B-Instruct)的回答更准确、完整,被判为偏好答案。

收集状态

  • 数据通过免费 Google Colab 会话增量收集,当前进度 24%。
  • 每次新运行会加载已有数据,从缺失的问题和答案对继续收集,不重复已完成的采集。
  • 原始数据检查点保存在该仓库的 raw/ 文件夹中。
搜集汇总
数据集介绍
ru-llm-judge-dataset 数据集图片
构建方式
本数据集以俄罗斯语问答数据集ai-forever/rubq-retrieval为问题来源,利用多种生成模型(包括Qwen2.5-1.5B-Instruct、Qwen2.5-3B-Instruct及SmolLM2-1.7B-Instruct)针对同一问题生成候选回答,再由Qwen2.5-3B-Instruct模型作为评判者,对比答案质量并标注偏好。构建过程在Google Colab免费环境中分批次增量执行,通过持久化检查点记录累积数据,避免重复劳动。当前已集结1,200条评判样本,正朝着5,000条目标稳步推进。
使用方法
研究人员可直接加载该数据集用于俄语大模型的偏好对齐训练、奖励模型构建或生成质量评估基准。数据集提供标准化字段,便于将其转换为OpenAI格式或ChatML模板,适用于监督微调与强化学习流程。鉴于其偏好标签及理由,亦可用于训练评判模型(LLM-as-a-Judge),或作为测试集验证既有评判体系的准确性。数据集持续更新,新样本的定期融入确保其时效性与多样性。
背景与挑战
背景概述
随着大语言模型(LLMs)在自然语言处理领域的迅猛发展,如何客观评估其生成内容的质量成为亟待解决的核心议题。传统的自动化指标(如BLEU、ROUGE)在捕捉语义连贯性与事实准确性方面存在显著局限,而人工评估则成本高昂且难以规模化。在此背景下,LLM-as-a-Judge范式应运而生,利用高性能模型模拟人类偏好,为模型输出提供可扩展的评估方案。然而,此类评估方法在非英语语种(尤其是俄语)中的适用性尚未充分探索。俄罗斯人工智能领域的研究机构ai-forever团队于2026年8月启动RU-LLM-Judge-Dataset项目,旨在构建首个面向俄语的偏好评估数据集。该数据集基于rubq-retrieval问答语料,系统性采集了Qwen2.5-1.5B/3B-Instruct与SmolLM2-1.7B-Instruct三个开源模型的成对回答,并借助Qwen2.5-3B-Instruct作为裁判模型,通过增量式构建方法形成包含1,200条高质量标注的初步版本。此数据集的问世不仅填补了俄语环境下LLM偏好评估资源的空缺,更为跨语言模型对齐研究提供了重要基准,推动了多语言AI评估体系的完善。
当前挑战
RU-LLM-Judge-Dataset面临的挑战多维且深刻。从领域问题而言,当前LLM-as-a-Judge框架多依赖英语数据训练,直接迁移至俄语时面临语义理解偏差与文化语境缺失的双重困境,导致裁判模型的判断在复杂问答场景下可能偏离人类真实偏好。数据集构建过程中,团队遭遇了资源与效率的显著制约——依托免费Google Colab算力进行增量采集,单次会话仅能处理约600条样本,且需应对环境中断、数据一致性与去重等工程挑战。此外,裁判模型自身的能力边界构成内在局限,其偏好标注可能继承训练数据中的偏见,影响set数据可靠性。更为关键的是,数据集当前的规模(1,200条)仅为5,000条目标的24%,样本量的不足限制了其在模型微调与评测中的统计效力,而多样化的问答来源与模型组合虽增强了代表性,却也对标注一致性提出了更高要求。这些挑战共同指向一个核心问题:如何在有限资源下,构建兼具规模、质量与语言适配性的俄语偏好评估数据集。
常用场景
经典使用场景
该数据集专为俄语环境中评估大型语言模型(LLM)应答质量而构建,其核心用途在于作为LLM-as-a-Judge范式的基准测试集。研究者可借助其中包含的成对模型应答及人工/模型标注的偏好标签,系统性地比较不同生成模型在俄语任务上的表现,从而筛选出更优的模型配置或训练策略。
解决学术问题
该数据集填补了俄语偏好数据稀缺的空白,有助于解决非英语环境下LLM评估标准缺失的问题。通过提供结构化偏好标注,它支持研究者探究模型生成质量差异、偏好一致性问题,以及判断器(judge)模型的可信度,为多语言模型优化提供实证基础。
实际应用
在实际应用中,该数据集可服务于俄语智能助手、客服系统、内容生成工具等产品的模型选型与迭代。开发者能依据数据集中的偏好反馈,快速识别并修正模型缺陷,提升应答准确性,降低人工评测成本,加速俄语NLP产品落地。
数据集最近研究
最新研究方向
在俄语自然语言处理领域,llm-as-a-judge(大语言模型作为裁判)正成为评估生成式模型输出质量的新兴范式,其核心在于利用强语言模型对候选回答进行偏好判断,以替代昂贵且耗时的人工标注。该数据集聚焦俄语场景,由AI-forever的RUBQ检索数据集派生,通过Qwen2.5-1.5B/3B-Instruct与SmolLM2-1.7B-Instruct等模型生成回应,并由Qwen2.5-3B-Instruct作为裁判模型,已积累1200条偏好标注(目标5000条),涵盖问题、成对回答、偏好选择及理由。此方向尤其关注低资源语言下的裁判模型泛化能力、偏好一致性与可解释性,为构建俄语自动评估基准、促进多语言对齐与模型优化提供数据支撑,其增量式收集策略亦体现了数据工程的实践创新,对推动多语种评估体系发展具有里程碑意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务