BaltiVoice
收藏资源简介:
BaltiVoice是由独立研究者Muhammad Ali创建的首个巴尔蒂语公开语音语料库,旨在填补该低资源语言在自动语音识别领域的空白。该数据集包含10,060条经过验证的语音片段,总时长达16.8小时,平均每条语音时长6秒,词汇量约10.12词,数据源自Mozilla Common Voice社区贡献的朗读语音。其创建过程通过志愿者朗读句子并经过社区验证,采用说话人分离划分得到9,519条训练数据和538条验证数据。该数据集主要应用于低资源语言ASR系统开发,通过微调Whisper-small模型将词错误率从182.18%降至30.07%,为巴尔蒂语语音技术研究提供了重要基线。
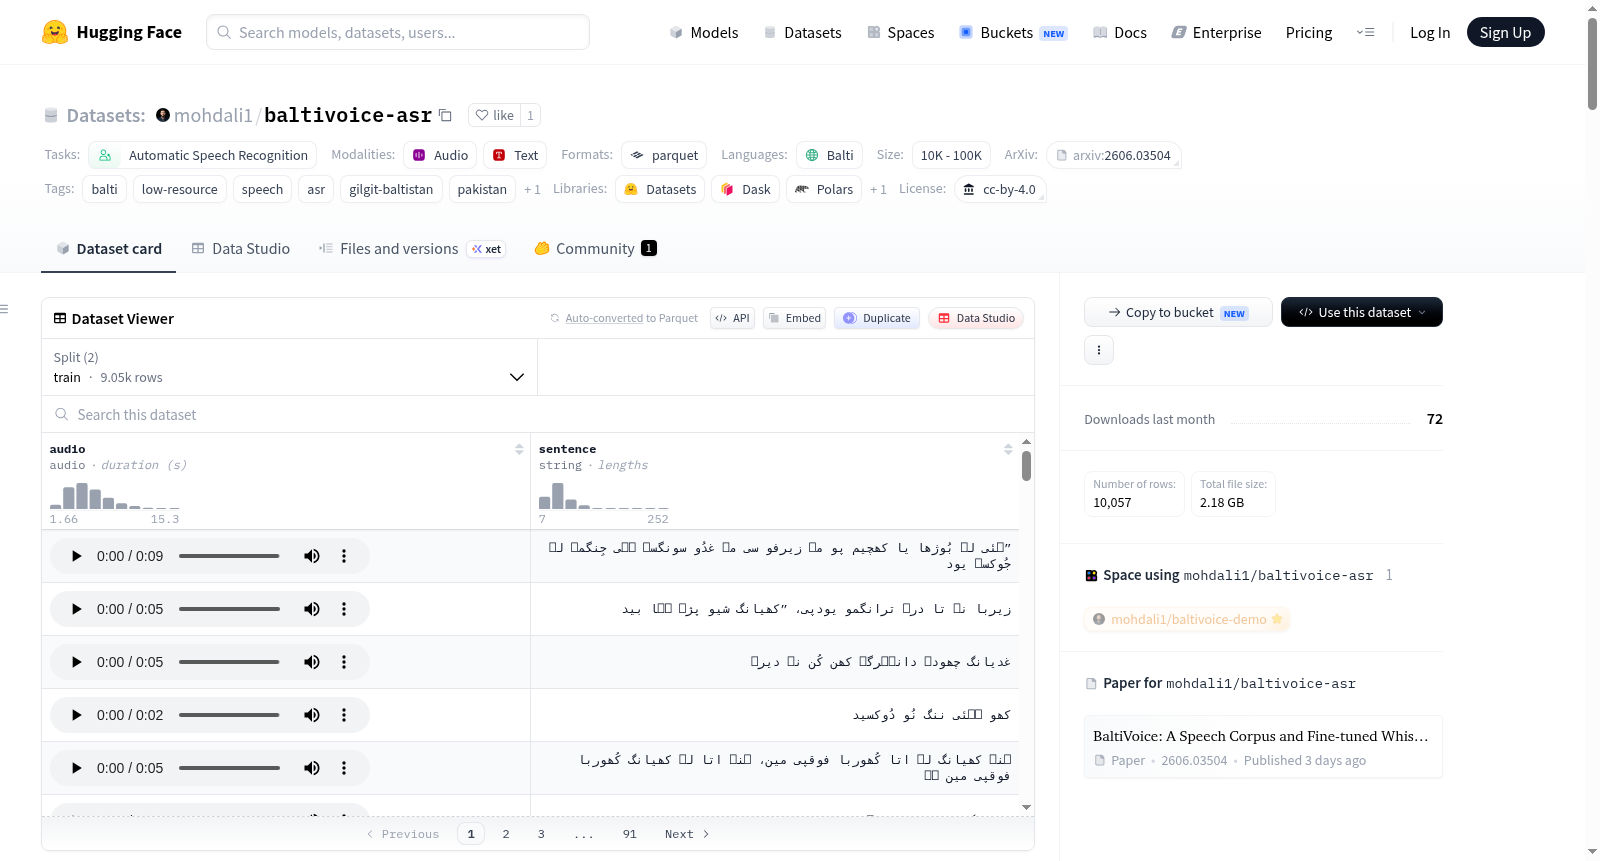
BaltiVoice is the first publicly available Balti language speech corpus created by independent researcher Muhammad Ali, designed to address the research gap of this low-resource language in the field of automatic speech recognition (ASR). This dataset comprises 10,060 validated speech segments, with a total duration of 16.8 hours, an average duration of 6 seconds per segment, and an average vocabulary size of approximately 10.12 words per utterance. The data is sourced from read speech contributions submitted to the Mozilla Common Voice community. During its development, volunteers read target sentences followed by community-based validation, and the corpus was split into 9,519 training samples and 538 validation samples via speaker diarization. This dataset is primarily applied to the development of low-resource language ASR systems. As a demonstration, fine-tuning the Whisper-small model on this corpus reduced the word error rate (WER) from 182.18% to 30.07%, providing an important baseline for Balti language speech technology research.
数据集概要
BaltiVoice ASR 是首个公开的巴尔蒂语(Balti)自动语音识别(ASR)数据集。巴尔蒂语(ISO 639-3: bft)是一种极度低资源的藏语支语言,主要使用于巴基斯坦吉尔吉特-巴尔蒂斯坦地区和印度拉达克部分地区。
语言信息
| 属性 | 详情 |
|---|---|
| 语言 | 巴尔蒂语 (بلتی) |
| ISO 代码 | bft |
| 语系 | 汉藏语系 → 藏缅语族 → 藏语支 |
| 文字 | 纳斯塔利克体(基于阿拉伯字母) |
| 区域 | 巴基斯坦吉尔吉特-巴尔蒂斯坦、印度拉达克 |
| 使用人口 | 约400,000(估计) |
| 资源水平 | 极度低资源 |
数据集统计
| 划分 | 样本数 | 说话人数 | 估计时长 |
|---|---|---|---|
| 训练集 | 9,519 | 122 | ~15.9小时 |
| 验证集 | 538 | 14 | ~0.9小时 |
| 总计 | 10,060 | 136 | ~16.8小时 |
- 训练集和验证集严格说话人无重叠(经验证,重叠数为0)。
说话人人口统计
| 属性 | 数值 |
|---|---|
| 总独立说话人 | 136 |
| 性别(女性) | 1,246条话语 |
| 性别(未公开) | 1,030条话语 |
| 年龄(二十多岁) | 3,758条话语 |
| 年龄(三十多岁) | 3,697条话语 |
| 年龄(十几岁) | 97条话语 |
音频属性
| 属性 | 数值 |
|---|---|
| 格式 | WAV(16kHz,单声道) |
| 平均时长 | ~6.0秒 |
| 最短时长 | ~1.0秒 |
| 最长时长 | ~15.0秒 |
| 采样率 | 16,000 Hz |
文本属性
| 属性 | 数值 |
|---|---|
| 平均单词/句 | 10.12 |
| 平均字符数 | 48.80 |
| 文字 | 纳斯塔利克体(从右向左) |
数据集结构
每条样本包含:
audio:16kHz单声道WAV音频数组sentence:巴尔蒂语纳斯塔利克体转录文本
python { "audio": { "array": [...], # numpy数组 "sampling_rate": 16000 }, "sentence": "بوا لہ سلام بے اِنپا سلام سہ مہ بیاس" }
数据来源与收集
- 基础数据源自 Mozilla Common Voice 巴尔蒂语(bft)贡献项目
- 仅使用了经验证的录音(共10,547个片段中选取10,060个)
- 使用说话人无重叠采样(基于
client_id元数据的GroupShuffleSplit,种子为42)创建划分
基于该数据集训练的模型
基于BaltiVoice微调的Whisper模型可在此获取:https://huggingface.co/mohdali1/whisper-small-balti
| 模型 | 词错误率 (WER) |
|---|---|
| Whisper-small(零样本) | 182.18% |
| Whisper-small(微调后) | 30.07% |
零样本WER超过100%表示模型产生幻觉——生成了参考文本中不存在的单词。微调后在说话人无重叠验证集上将该值降至30.07%。
相关论文
该数据集在以下论文中有详细描述:
BaltiVoice: A Speech Corpus and Fine-tuned Whisper ASR System for the Balti Language Mohammad Ali, Independent Researcher, Gilgit-Baltistan, Pakistan arXiv: https://arxiv.org/abs/2606.03504
社会影响
- 数字保护巴尔蒂语
- 为巴尔蒂语使用者提供语音技术
- 支持低资源藏语支语言的NLP研究
- 为未来的巴尔蒂语TTS、NER和MT系统提供基础
局限性
- 音频由志愿者贡献者收集,录音质量存在差异
- 词汇限于朗读语音领域,对话场景的词错误率可能更高
- 使用乌尔都语分词器作为代理进行微调(Whisper中支持的最接近纳斯塔利克体的语言)
- 未应用Unicode规范化,阿拉伯语/波斯语Yeh歧义可能影响词错误率计算
许可协议
引用
bibtex @dataset{baltivoice2025, author = {Mohammad Ali}, title = {BaltiVoice: A Speech Corpus and Fine-tuned Whisper ASR System for the Balti Language}, year = {2025}, publisher = {HuggingFace}, url = {https://huggingface.co/datasets/mohdali1/baltivoice-asr} }