
遇见数据集

sbintuitions/joyo-kanji-yomi-benchmark

收藏
Hugging Face2026-06-29 更新2026-07-22 收录
官方服务:

资源简介:

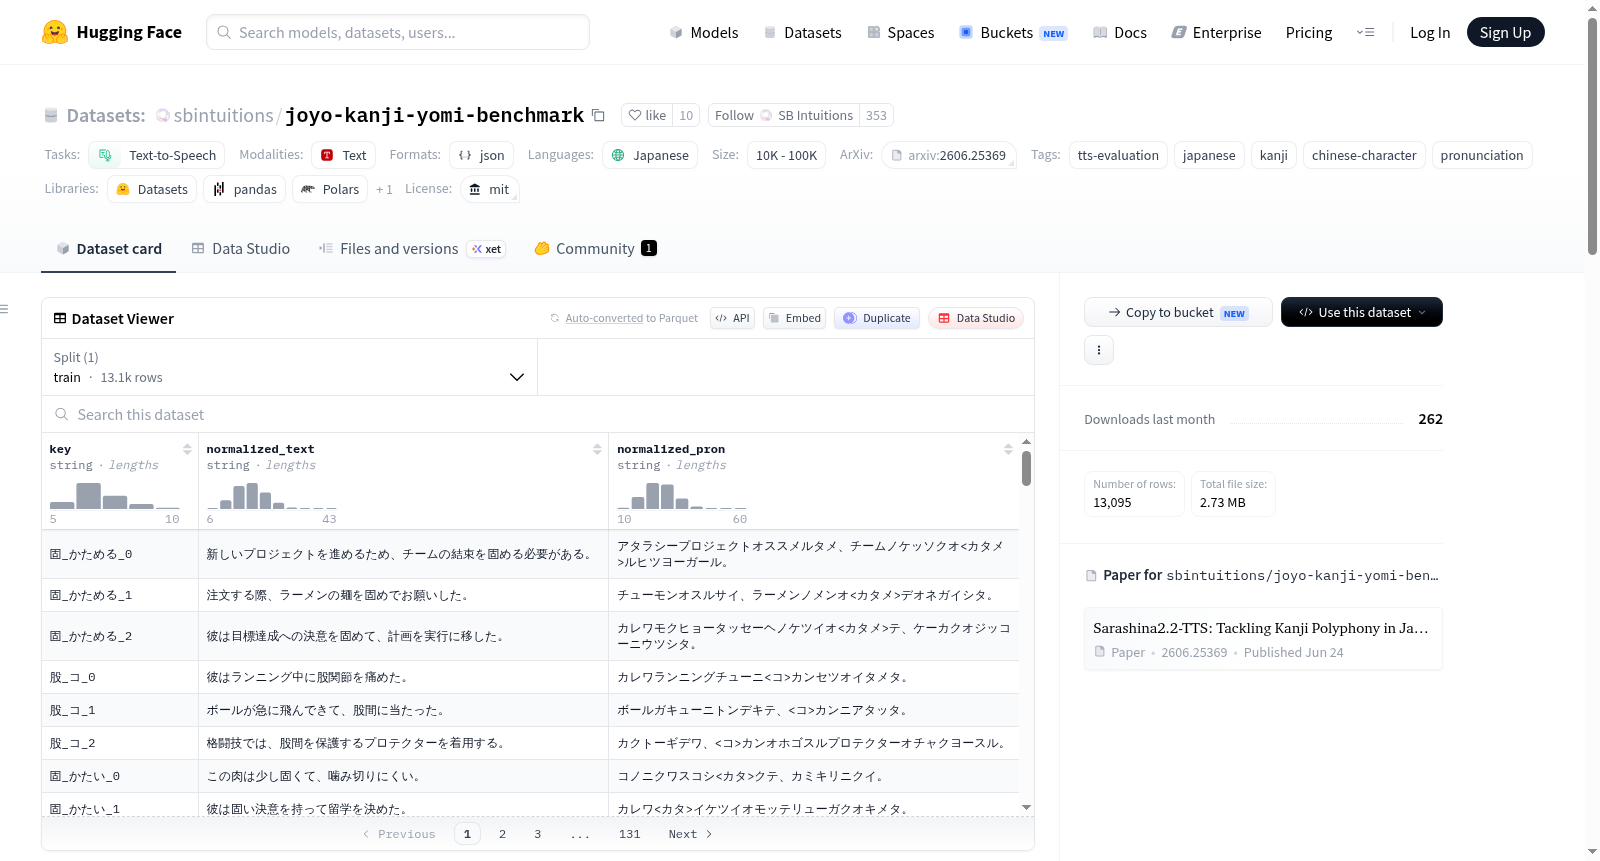
Joyo Kanji Yomi Benchmark是一个用于日语文本到语音(TTS)的汉字级别发音评估基准数据集,涵盖了所有2,136个常用汉字及其4,378种读法,包含13,095个经过母语者验证的测试句子。每个样本针对特定的汉字-读法对,句子上下文设计为仅目标读法有效。所有句子和注释都经过35位日语母语者通过三轮审核过程验证。少量汉字-读法对被排除在外,当仅凭句子上下文无法唯一区分目标读法与汉字的其他读法时。

Joyo Kanji Yomi Benchmark is a kanji-level pronunciation evaluation benchmark dataset for Japanese text-to-speech (TTS). It covers all 2,136 commonly used Japanese kanji and their 4,378 pronunciations, and contains 13,095 test sentences verified by native speakers. Each sample targets a specific kanji-pronunciation pair, and the sentence context is designed such that only the target pronunciation is valid. All sentences and annotations were verified by 35 Japanese native speakers through a three-round review process. A small number of kanji-pronunciation pairs were excluded when the sentence context alone cannot uniquely distinguish the target pronunciation from the other pronunciations of the corresponding kanji.
提供机构:
sbintuitions
搜集汇总
数据集介绍
sbintuitions/joyo-kanji-yomi-benchmark 数据集图片
构建方式
该数据集专为日语文本转语音(TTS)系统的汉字级发音评估而设计,覆盖了全部2,136个常用汉字及其4,378种读音,共计13,095条母语者验证的测试句子。每个样本针对特定的汉字-读音配对,句子上下文经过精心编排,确保仅目标读音在语境中合理。所有句子与标注由35位日语母语者通过三轮审查流程严格验证,排除因语境无法唯一消歧的少数配对,最终形成高可靠性的基准测试集。
使用方法
使用本数据集需配合官方提供的评估工具包,该工具包集成了自动语音识别(ASR)转录、对齐和指标计算功能。用户只需将TTS系统生成的音频输入工具包,工具包即可自动完成转录与对齐,基于标注中的读音标记计算汉字级CER,从而量化模型对日语汉字多音字读音的掌握程度。详细使用方法见GitHub仓库及配套论文。
背景与挑战
背景概述
日语文本到语音合成(TTS)技术长期面临汉字(kanji)多音字歧义这一固有难题。同一汉字在不同上下文中可能对应多种读音,例如「生」可读作「セイ」「ショウ」「イキ」等,这种一字多音现象严重制约了合成语音的自然度与准确性。为系统评估TTS模型对汉字读音的掌握能力,由Liu等人于2026年创建的Joyo Kanji Yomi Benchmark应运而生。该基准覆盖日本文部科学省指定的全部2,136个常用汉字及其4,378种读音,包含13,095条经35名母语者三轮审核验证的测试句。每一测试句子均经精心设计,确保仅目标读音在上下文中合法,从而提供汉字级发音评价的黄金标准。该基准建立在Sarashina2.2-TTS研究工作之上,已迅速成为日语TTS领域衡量汉字读音合成能力的权威工具,对推动多音字读音建模技术的发展具有里程碑意义。
当前挑战
该基准所应对的核心领域挑战在于汉字多音字歧义——日语中逾70%的常用汉字拥有两种以上读音,TTS模型若无法根据上下文精准选择正确读音,便会产生如将「東京」误读为「ひがしきょう」等识别错误。这一难题的本质是语音生成与语言理解的深度耦合,要求模型同时具备语义分析与音系映射能力。在基准构建过程中,研究者面临两重独特困难:首先,需为每个目标读音设计能唯一消除歧义的语境,但对于约5%的读音对,即使借助完整句子也无法从汉字本身的其他读音中区分,最终被迫排除;其次,35名标注者需通过三轮阶梯式审核确保读音标注与句子自然性的一致性,任何主观分歧均需仲裁,这使人工验证成本呈指数级上升。
常用场景
经典使用场景
在日语文本到语音(TTS)合成领域,汉字多音字(kanji polyphony)一直是影响发音准确性的核心难题。Joyo Kanji Yomi Benchmark作为首个覆盖全部2136个常用汉字及其4378种读法的发音评估基准,为日语TTS模型提供了系统化的测试平台。该数据集包含13095条由35位母语者通过三阶段审核验证的测试句子,每条样本均针对特定汉字-读音对设计,确保句子上下文唯一确定目标读音。研究者可利用提供的评估工具包,通过ASR转录、对齐和指标计算,自动提取汉字级别的字符错误率,从而精准衡量模型在多音字辨识上的表现。这一基准不仅填补了日语TTS缺乏标准化汉字发音评估的空白,更推动了领域内朝着更精细、更可靠的评测方向发展。
解决学术问题
该数据集旨在解决日语TTS合成中汉字多音字读音歧义这一长期存在的学术难题。在日语中,同一个汉字常因上下文不同而拥有多种读法,传统评估方法往往只能评测句子级别的整体发音质量,无法深入定位到具体汉字的读音错误。Joyo Kanji Yomi Benchmark通过精心设计语境使其唯一锁定目标读音,并引入汉字级别的读音错误率指标,使得研究者能够系统性地量化模型在多音字处理上的弱点。这为开发更具鲁棒性的日语TTS模型提供了明确的方向和可复现的评估标准,其意义在于推动学术研究从粗粒度的音质评估转向细粒度的语言学精准度量,从而加速日语语音合成技术的进步。
实际应用
在实际应用中,该基准直接服务于日语语音合成系统的质量控制和性能优化。商业化的日语TTS产品,如虚拟主播、语音助手、有声读物和导航系统,均面临汉字读音错误的尴尬,这会严重损害用户体验。通过使用Joyo Kanji Yomi Benchmark对模型进行系统性评测,开发者可以快速定位系统中常见的读音错误类型,并针对性地优化模型设计或调整训练数据。例如,合成系统在处理“精”(可读作セイ或ショウ)时,若在“精密”语境下误读,基准可立即反映出来。此外,该数据集还可用于辅助日语教育中的发音教学工具开发,帮助学习者正确掌握汉字的多样化读音,展现了从研究到产业的全链路实用价值。
数据集最近研究
最新研究方向
该基准聚焦于日文文本到语音合成中汉字多音字读音歧义消解这一前沿难题,通过覆盖全部2136个常用汉字及其4378种读法,结合13,095句由35名母语者三阶段审核的测试句,为评估TTS系统在复杂语言环境下的读音准确性提供了严苛标准。其构建思路与日语教育领域长期关注的汉字读音指导紧密相连,并回应了语音合成在实时交互、无障碍阅读等热点应用中面临的多音字误读瓶颈。该数据集不仅推动了声学模型对汉字-读音映射的细粒度学习,还为跨语种多音字处理研究树立了可复用的方法论标杆,尤其通过定制的评估工具包实现端到端音素级错误率计算,显著提升了日本语音技术评估的透明性与可复现性。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

